
Zabbix 8.0 LTS: OpenTelemetry nativ und MCP
Zusammenfassung
Zabbix 8.0 LTS ist eine kostenlose Monitoring Plattform, die OTLP direkt annimmt, Spuren und Protokolle in einen Speicher legt und einen MCP Server mitbringt.
Empfehlen- Name
- Zabbix
- Version
- 8
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- LinuxWindowsWeb
- Webseite
- https://www.zabbix.com/
- Aktualisiert
- 2026-11-15 12:09
Zabbix ist die Monitoring Plattform, die im Firmennetz steht, jahrelang unangetastet laeuft und erst auffaellt, wenn etwas ausfaellt. Die am 5. November erschienene 8.0 LTS tut mehr, als ein paar Zeilen in eine Funktionsliste zu schreiben: sie holt OpenTelemetry in die eigene Verarbeitung, sodass Messwerte, Spuren und Protokolle in einem Speicher landen, und sie gibt KI Vertretern einen offiziellen Eingang. Der Server laeuft weiter auf der eigenen Linux Maschine, der Browser oeffnet die Weboberflaeche, der Code kommt unter AGPLv3, und die Lizenz kostet nichts; bezahlt werden Betriebszeit und Hardware.
OpenTelemetry braucht keine Zwischenschicht mehr
Spuren aus einer Anwendung in Zabbix zu bringen hiess frueher, selbst eine Uebersetzungsschicht zu bauen, per Skript oder mit einem Sammler, und damit immer ein weiteres Stueck zu pflegen. Die 8.0 nimmt OTLP direkt an: ein Zabbix Proxy empfaengt die Daten ueber OTLP/gRPC, aus der Anwendung selbst oder aus einem Sammler, der ohnehin laeuft, und fuer die Anbindung muss keine zusaetzliche Schicht stehen.
Eine Falle gehoert ausgesprochen. Der Empfang sitzt nur im Proxy, der Server hat keinen eigenen Sammler und in seiner Konfiguration keinen passenden Schalter. Eine Umgebung, die bisher ohne Proxy auskam, stellt fuer APM also einen auf; er darf auf derselben Maschine wie der Server laufen, ein zweiter Rechner ist nicht noetig. Erlaubt ist allein OTLP/gRPC auf dem Standardport 4317, der HTTP Weg ueber Port 4318 funktioniert nicht, ein Exporteur spricht also gRPC oder geht zuerst durch einen Sammler.
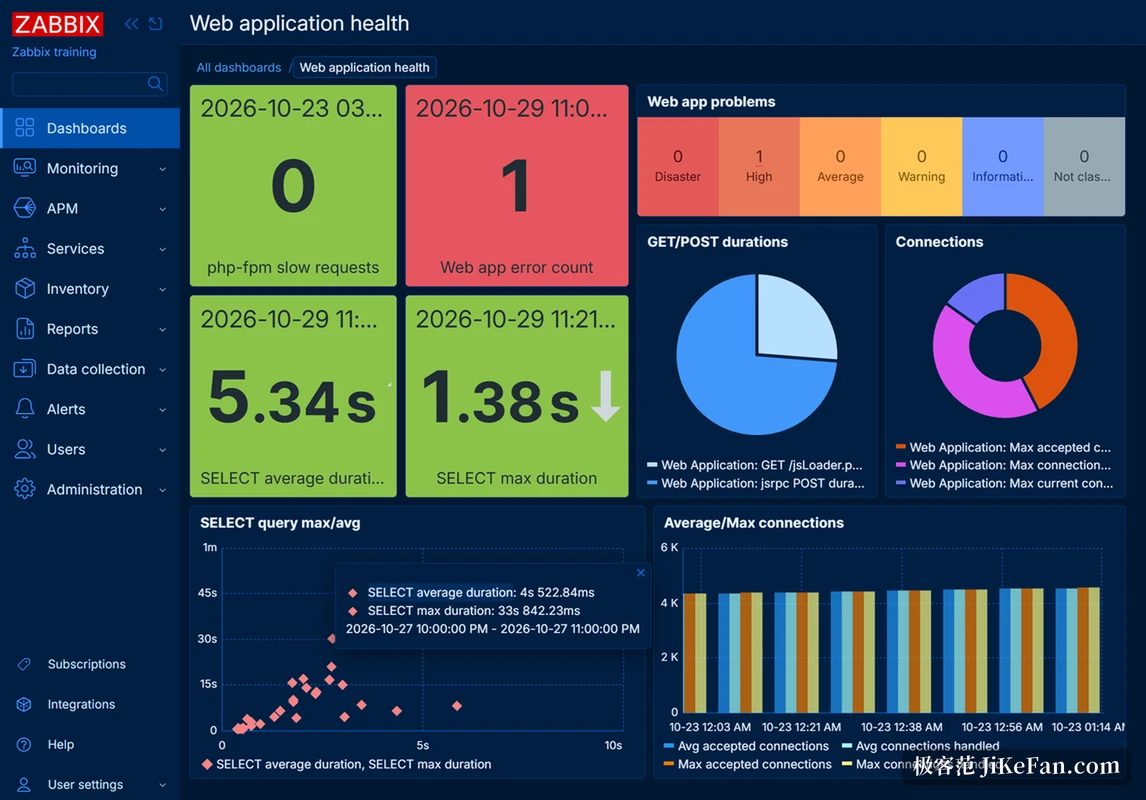
Die Weboberflaeche bekommt links einen APM Block mit drei Ansichten darunter, Traces, Metrics und Logs, jede fuer sich gelesen. Die Dashboards zeigen Fehlerzahlen, die Verteilung der Latenz fuer GET und POST, Verbindungszahlen und langsame Anfragen und lassen sich bis zur groessten und mittleren Verzoegerung einer Abfrage vertiefen. Der neue Datentyp fuer Telemetrieabfragen ist dabei wichtig: Diagramme und Ausloeser verweisen darauf, Regeln zur automatischen Erkennung koennen ihn nutzen, Spurdaten sind also nicht mehr nur zum Ansehen da, sondern erreichen die Alarmregeln.
Die Versionshinweise fassen die Linie in einem Satz zusammen: Messwerte, Spuren und Protokolle auf einer Plattform.
Wie eine einzelne Anfrage aussieht
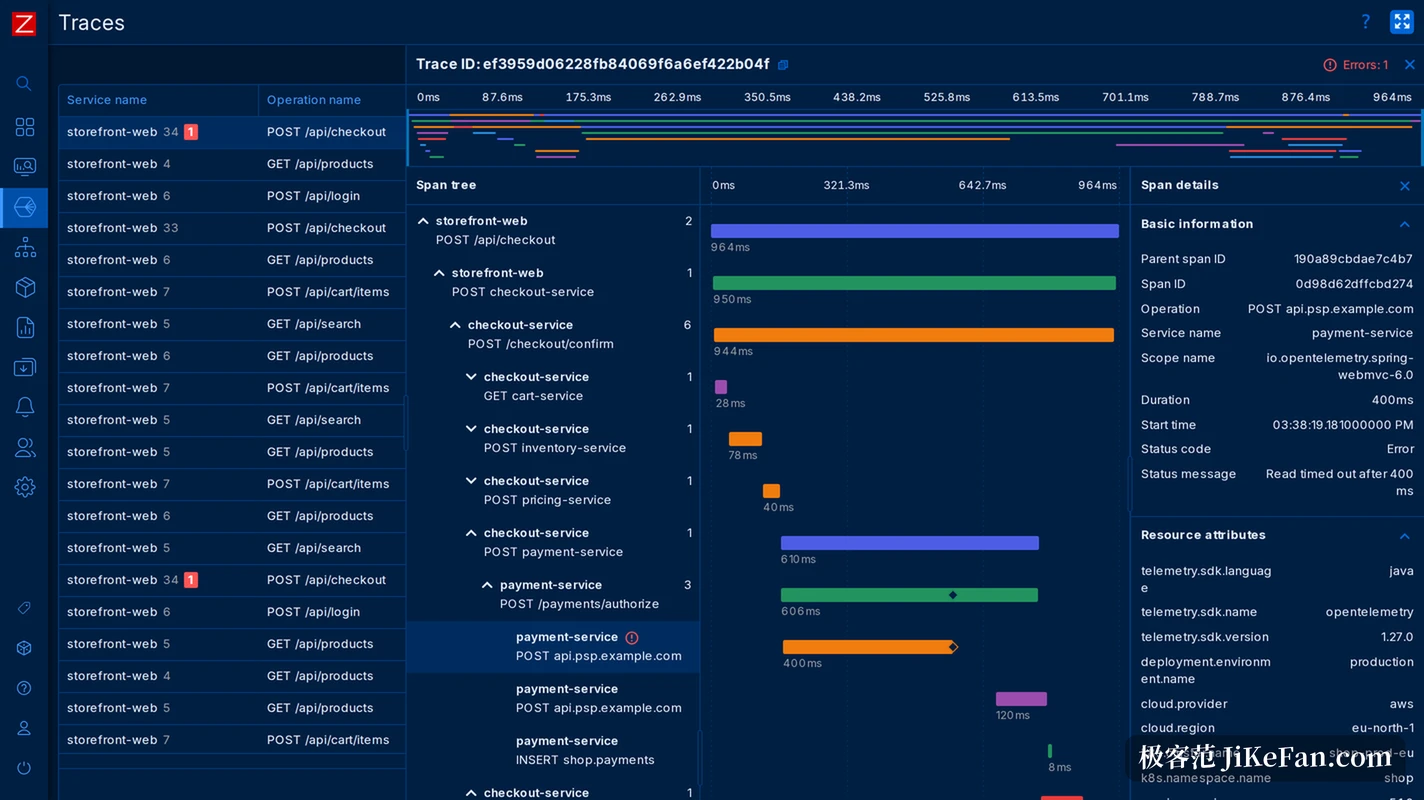
Die Detailseite einer Spur verdient einen eigenen Absatz. Eine Anfrage kommt an, die Paare aus Dienst und Vorgang werden gelistet, und das Oeffnen zeigt den Span Baum vom Tor ueber den Bestelldienst bis zum Zahldienst, jede Ebene als Block, dessen Laenge die Zeit zeigt, der fehlerhafte Abschnitt in Rot. Rechts stehen Span ID, Elternspan, Statuscode und Fehlermeldung, dazu Merkmale der Umgebung wie die Version des telemetry.sdk, der Cloud Anbieter, die Region und der Kubernetes Verbund. Die Frage, warum eine Zeitueberschreitung passiert ist, kostet kein Wechseln zwischen drei Systemen mehr.
Alarme laufen nicht mehr einzeln aus
CEP, die Verarbeitung komplexer Ereignisse, ist der zweite Schwerpunkt. Administratoren schreiben Vergleichslogik in JavaScript, die den Ereignisstrom in einem einstellbaren Zeitfenster auswertet, und die Maschine ordnet zusammenhaengende Probleme in Ursache und Symptom: faellt eine Datenbank weiter oben aus, landet die Kette der Folgefehler auf einer Ursache, statt einen Kanal mit Dutzenden Alarmen zu fuellen. Deduplizierung, Unterdrueckung und Verwerfen kommen mit, eine Obergrenze fuer gleichartige Ereignisse, das Zusammenfassen aehnlicher Ereignisse nach Ort, und umgekehrt ein Alarm, wenn Ereignisse zu haeufig oder gar nicht mehr eintreffen.
Der KI Teil kommt als offizieller MCP Server. Ein passender Vertreter liest Ueberwachungsdaten, geht die Problemhistorie durch, bestaetigt Alarme, aendert Schweregrade und verwaltet Wartungszeiten. Rechte oeffnen keine neue Tuer: der Vertreter arbeitet mit den vorhandenen Benutzerrollen, und was er darf, haengt vom Umfang seines API Tokens ab, sodass er die alten Grenzen nicht ueberschreitet.
Die Leistungsrechnung landet beim Speicher
Das Projekt nennt bis zu zehnmal so viel Leistung durch die neue Speicherarchitektur und Arbeit am Server, bei weniger CPU Last, weniger Plattenzugriffen und weniger belegtem Platz. In der Praxis kann ClickHouse als Hintergrund fuer Verlaufs und Telemetriedaten dienen und die analytische Last von der relationalen Datenbank nehmen; paralleles Laden des Verlaufs verkuerzt den Start; Proxy und Agent wechseln fuer die DNS Zwischenspeicherung auf den c-ares Aufloeser; und der Hintergrund nimmt mehrere PostgreSQL Knoten auf.
Eine Messung von der Vorstellung sagt mehr. Ein einzelnes Notebook, auf dem Server, Datenbank, Proxy und Oberflaeche liefen, hielt stetig 1,4 Millionen Messwerte pro Sekunde ohne Einbruch. Das Projekt schreibt das zwei Aenderungen zu, den im Server einzeln beseitigten Engstellen und der Kompression fuer die neue Speichermaschine, und als Nebenwirkung wird die Kapazitaetsplanung einfacher: Engstelle sind im Wesentlichen CPU und Arbeitsspeicher, eine schnellere Maschine kauft also mehr Durchsatz.
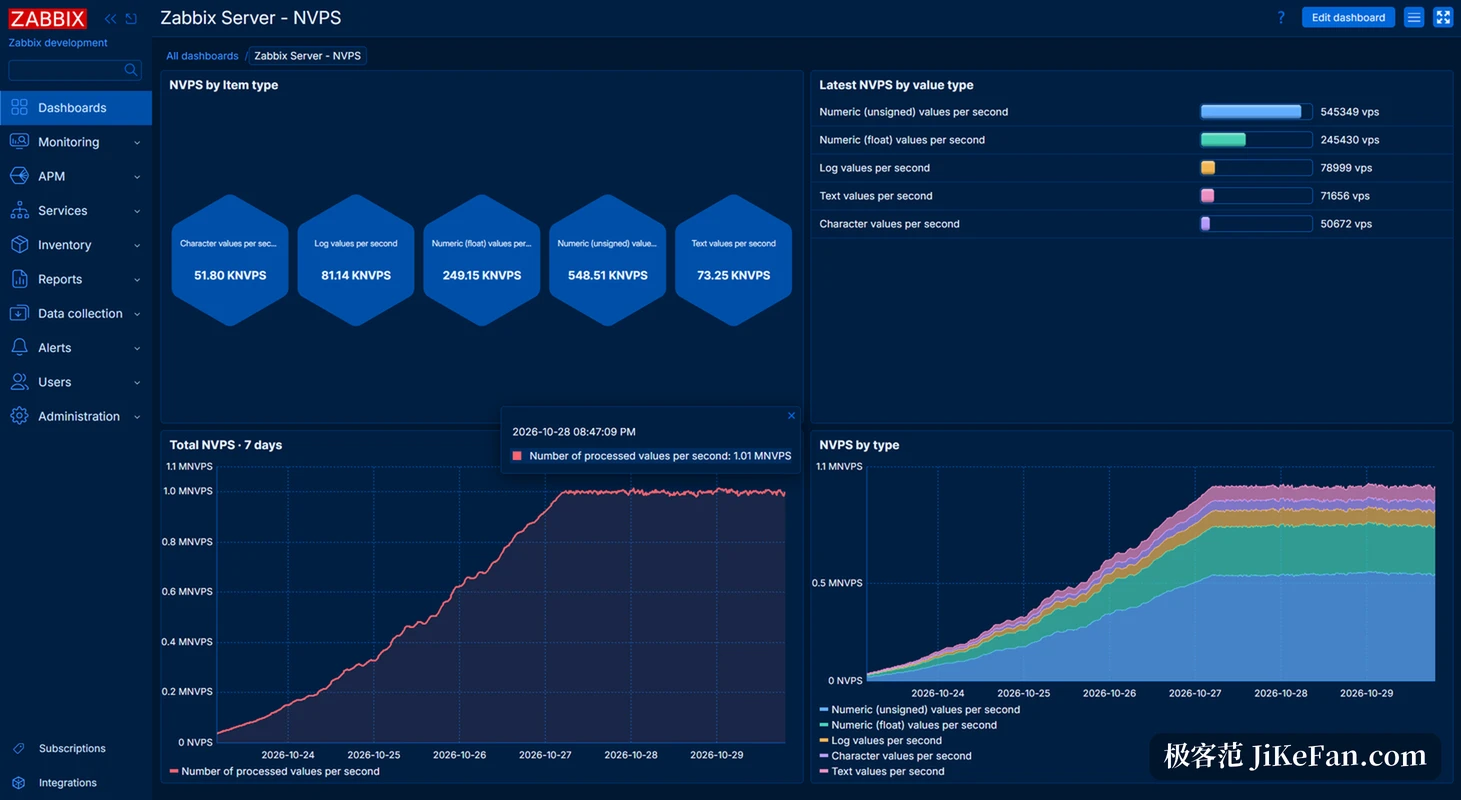
Dieses Dashboard zeigt die Groessenordnung: ueber fuenf Datenarten kommt allein die numerische auf mehr als eine halbe Million Werte pro Sekunde. Solche Faelle brauchten frueher eine eigene Zeitreihendatenbank, und ein System traegt sie jetzt mit.
Kleinere Arbeit an Oberflaeche und Sicherheit
Tabellen in der Weboberflaeche blenden Spalten aus, ordnen und skalieren sie um und nehmen eigene Spalten auf; ein dunkelblaues Thema kommt mit eingebauten Schriften; Formulare pruefen inline, und SAML Zertifikate samt privatem Schluessel lassen sich direkt in der Oberflaeche importieren, statt in eine Datei geschrieben zu werden. Dashboards lassen sich als YAML, JSON oder XML ein und ausfuehren, ein Streudiagramm Baustein ist neu, Diagramm Bausteine reagieren auf Eingaben, und der Baustein fuer die Karte fasst nahe Markierungen zu einer zusammen.
Die Sicherheit wurde an mehreren Stellen gestrafft: API Zugriff fuer Benutzerrollen ist standardmaessig aus und muss ausdruecklich eingeschaltet werden, die Anmeldung ueber HashiCorp Vault AppRole ist neu, Schluessel von Agent Messpunkten nehmen einstellbare Grenzen, und das Pruefprotokoll laesst sich ausgeben.
Zwei Rechnungen vor dem Aktualisieren
Die Vorlagen Sammlung gewinnt Podman, Kubernetes, Proxmox VE, Microsoft Hyper-V, MariaDB und Percona, dazu Dashboards fuer Ressourcen und Kosten von Cloud Anbietern, die sich unveraendert einfuegen lassen. Fuer Teams auf einer aelteren Fassung ist das Support Fenster das praktische Argument: volle Unterstuetzung bis 30. November 2029, begrenzte bis 30. November 2031, also fuenf Jahre aus einer Aktualisierung. Die andere Rechnung ist die Flaeche der Aenderung, denn API Zugriff ist aus, die Logik der Zusammenfassung wurde neu geschrieben und der Speicher kann auf ClickHouse wechseln; nichts davon ist ein Schalter, und eine Testumgebung ist der sicherere erste Schritt.
Ob sich das lohnt, haengt davon ab, wo es weh tut. Wenn Alarme laut sind, die Fehlersuche in Spuren Handarbeit ist und ein KI Vertreter einen richtigen Eingang braucht, zielen die Aenderungen der 8.0 genau dorthin. Wenn Zabbix nur prueft, ob ein paar Server leben, verliert die laufende Fassung nichts, wenn sie bleibt.