
Docling 2.150 behaelt Tabellen und Formeln
Zusammenfassung
Docling 2.150 steht unter MIT und wandelt PDF-Dateien, Scans und Aufnahmen offline in gegliedertes Markdown und JSON um, mit Tabellen und Formeln.
Empfehlen- Name
- Docling
- Version
- 2.150
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsmacOSLinux
- Webseite
- https://docling.ai/
- Aktualisiert
- 2026-11-12 23:00
Den Text aus einem Dokument zu ziehen ist die leichte Haelfte, und jeder Umwandler im Netz kann sie. Docling ist ein Werkzeug zur Dokumentenanalyse, das am anderen Ende anfaengt: erst das Layout lesen, damit eine Tabelle eine Tabelle bleibt.
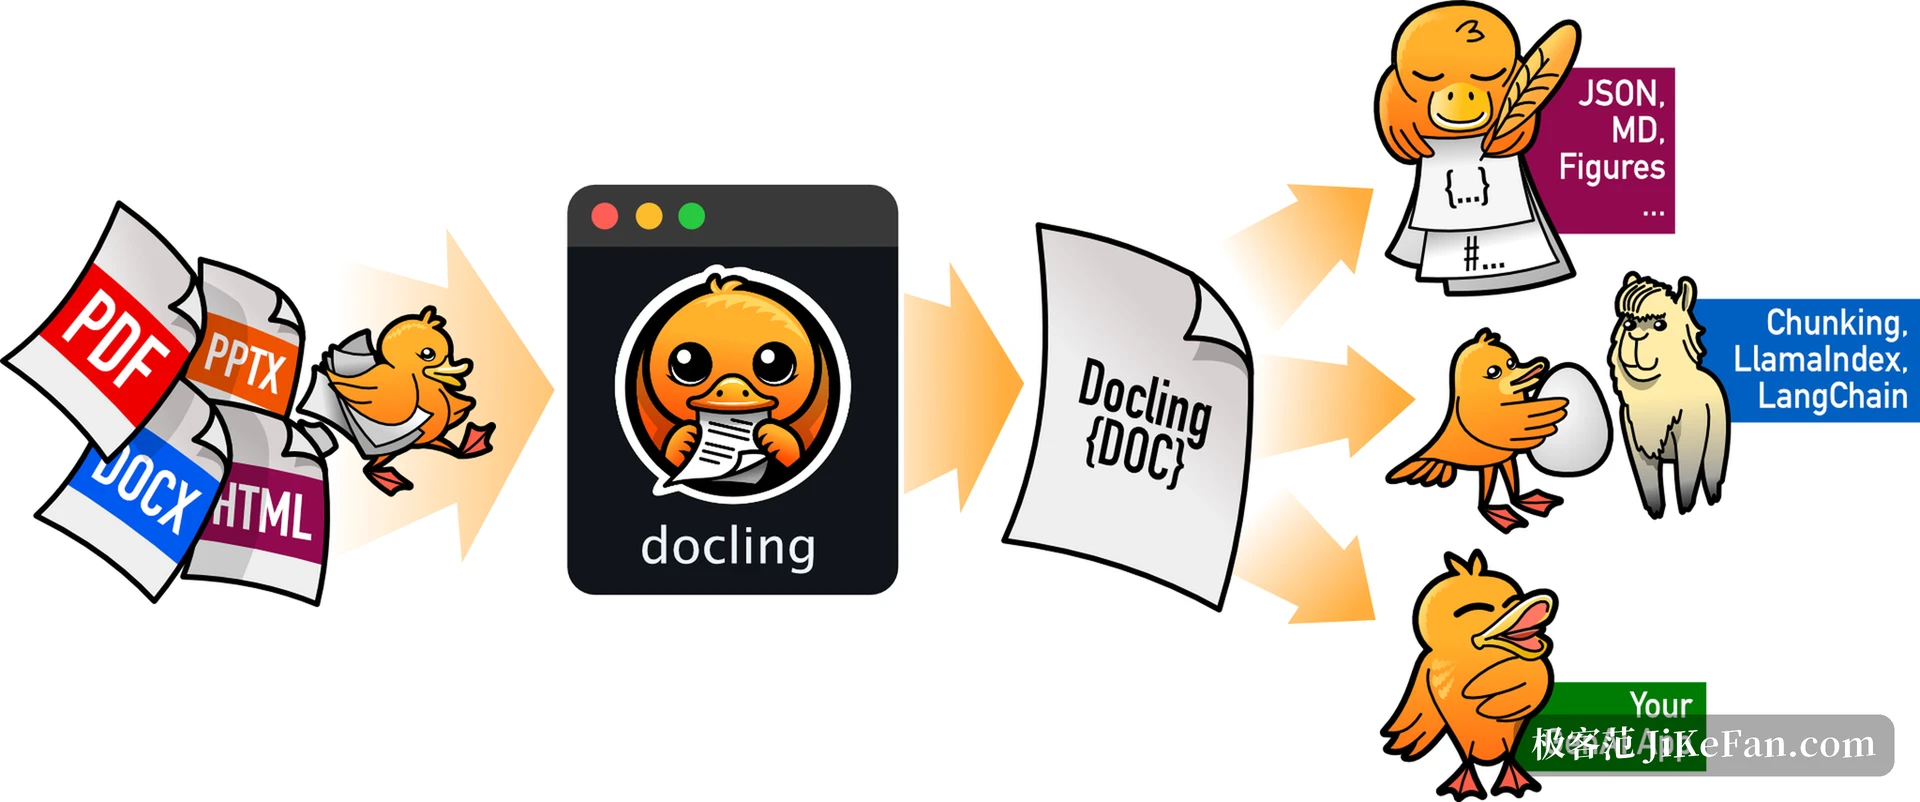
Docling laeuft auf dem eigenen Rechner und nimmt PDF, Word, PowerPoint, Excel, Webseiten, Scans und sogar Aufnahmen, zerlegt den Inhalt in gegliederten Text und gibt Markdown, HTML oder verlustfreies JSON aus. Entstanden ist es in einem Team bei IBM Research, heute wird es von der LF AI & Data Foundation getragen, unter der MIT-Lizenz. Version 2.150 vom 10. November 2026 nimmt iXBRL-Geschaeftsberichte als Eingabeformat auf.
Erst das Layout, dann die Zeichen
Die meisten Umwandler nehmen den Weg des Herausziehens: den Textstrom aus der PDF der Reihe nach holen und zu Absaetzen zusammensetzen. Docling macht es umgekehrt. Ein Modell fuer das Layout entscheidet, welche Bereiche eine Seite traegt, ob Kopf, Fuss, Absatz, Liste, Codeblock, Tabelle, Bild oder Formel, wo die Grenzen liegen, und ordnet erst danach die Reihenfolge des Lesens.
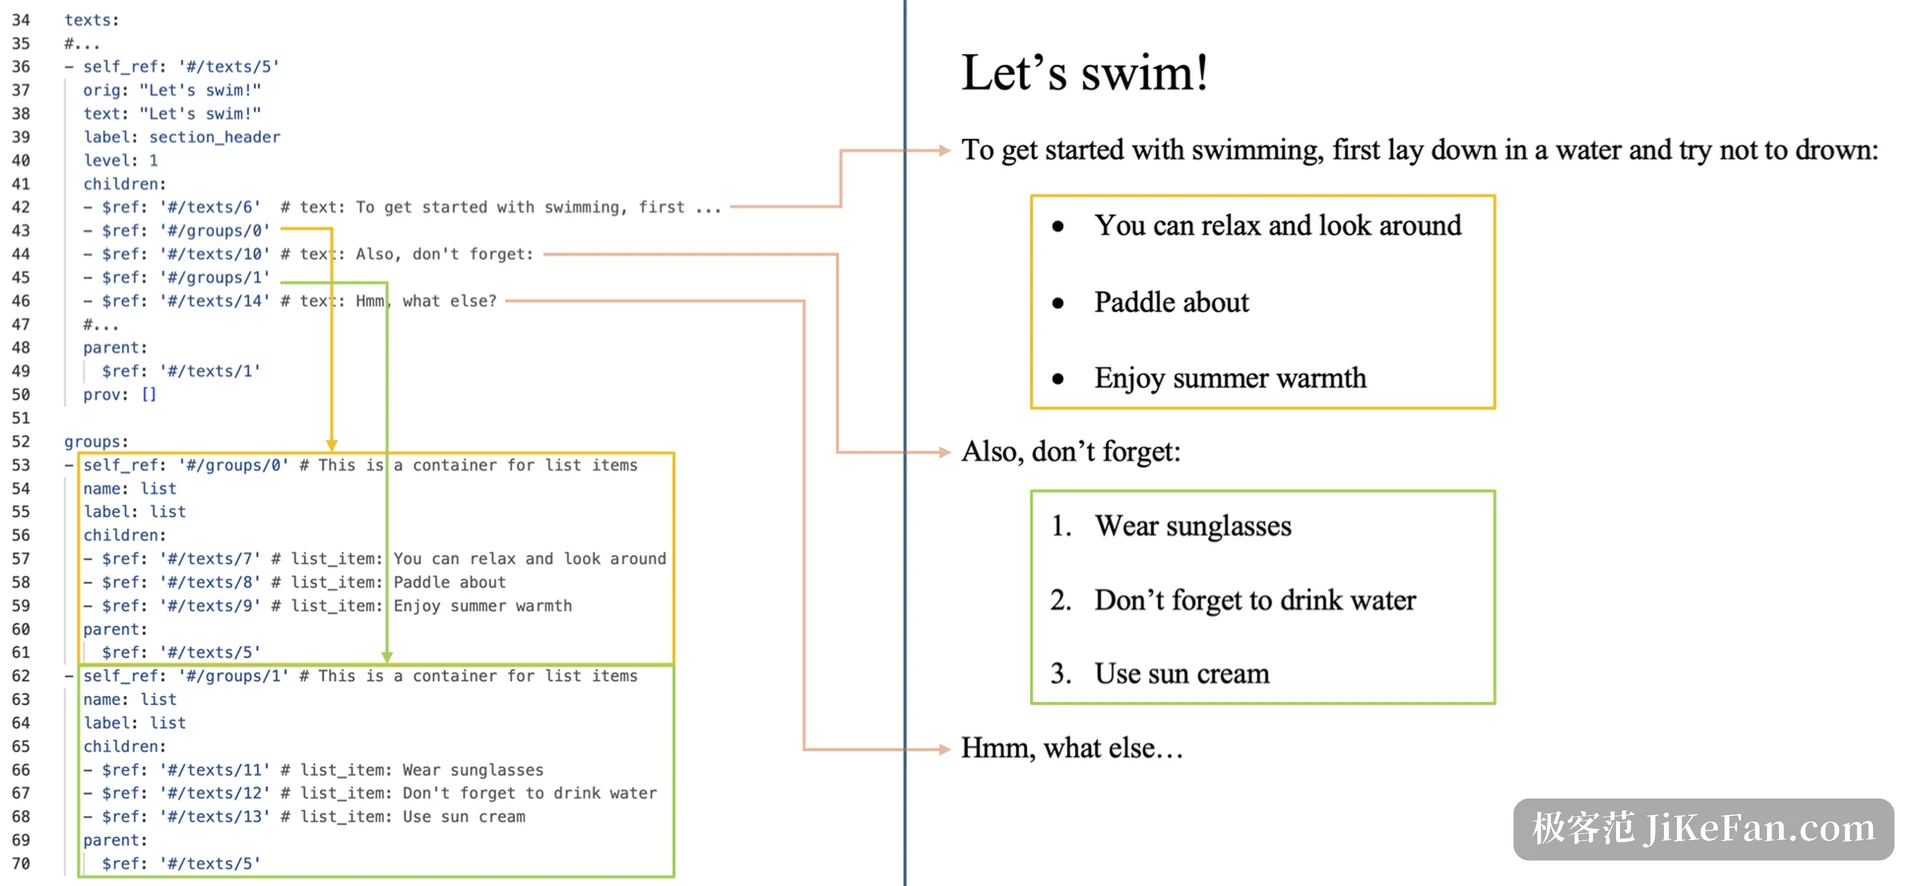
Ein Text mit zwei Spalten zeigt den Unterschied am deutlichsten. Wer nach Koordinaten von oben nach unten liest, verschraenkt Saetze aus linker und rechter Spalte; nach der Lesereihenfolge sortiert endet links, bevor rechts beginnt, und die Saetze schliessen aneinander an. Diese Reihenfolge steht im einheitlichen Dokumentmodell, sodass der Export nach Markdown sie abschreibt, statt neu zu raten.
Scans nehmen einen anderen Weg. Ist eine Seite ganz Bild, gibt es keinen Textstrom, also uebernimmt die Erkennung. Docling fragt zuerst, ob die Seite eine brauchbare Textebene hat, und startet OCR nur, wenn nicht. Die Engine laesst sich tauschen, und ein Bildmodell kann das Layout lesen. Modelle werden einmal geladen und laufen danach lokal.
Eine Tabelle hinein, eine Tabelle hinaus
Tabellen sind die Stelle, an der die Umwandlung von PDF am haeufigsten scheitert. Wird ein Raster zu einer Zeile Zahlen plattgedrueckt, verlieren Suche und Lesen ihren Sinn. Docling holt die Grenzen der Zellen mit einem Modell fuer die Tabellenstruktur zurueck, behaelt Zeilen, Spalten und mehrstufige Kopfzeilen und verliert keine ueber Zeilen oder Spalten verbundene Zelle. Eine Tabellenueberschrift wandert nicht in den Lauftext, sie bleibt bei ihrer Tabelle.
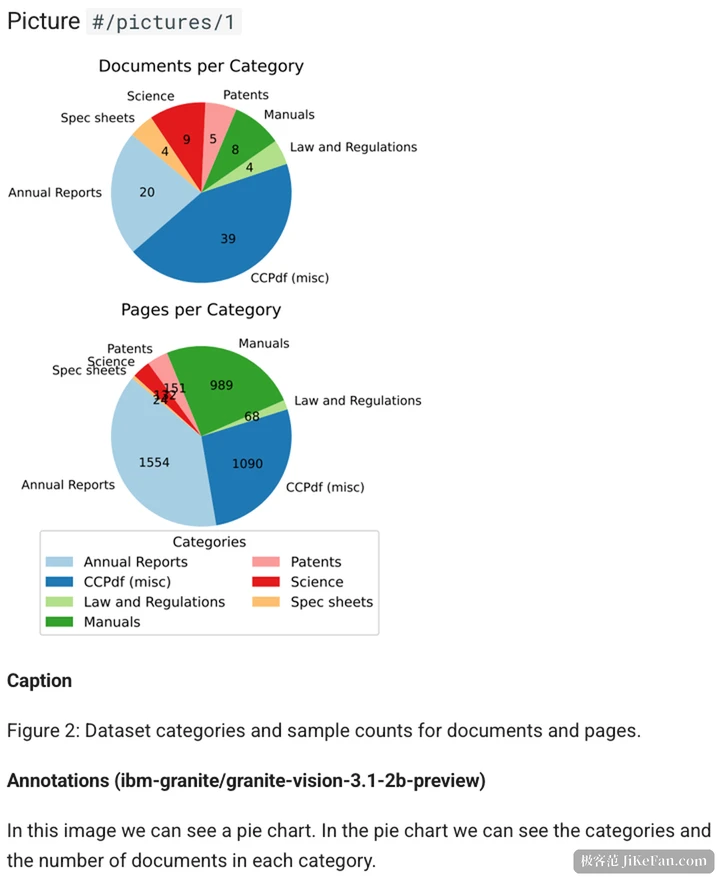
Formeln folgen derselben Regel. Formeln im Text und abgesetzte Formeln werden als LaTeX erkannt, nicht als Reihe verrutschter Zeichen. Bilder werden einzeln herausgezogen, mit ihren Koordinaten auf der Seite, der urspruenglichen Ueberschrift und einer Klasse des Inhalts, ob das Bild ein Liniendiagramm, ein Kreisdiagramm oder ein Foto ist.
Was die Fassung 2.150 aendert
Der November ist dicht, zwischen dem 3. und dem 10. kamen mehrere Fassungen, und die Aenderungen treffen die Eingaben und die Steuerung der Analyse. XBRL mit eingebetteten Marken in Geschaeftsberichten liess sich bisher nur als Webseite lesen, wobei die Finanzangaben in den Marken verloren gingen; 2.150 liest es direkt und kann Taxonomien von einer entfernten Adresse aufloesen. Bilder in einer PDF werden nur noch auf Anruf geoeffnet und nicht mehr standardmaessig geschrieben, was eine Menge unnoetiger Schreibzugriffe spart.
Die Kommandozeile wurde neu geordnet, damit ein Verzeichnis in Stapeln lesbar wird, und mehrere Ausgabeformate lassen sich auf einmal nennen.
Offline ist die Voraussetzung, kein Zusatz
Docling geht standardmaessig nicht ins Netz. Modelle liegen nach dem ersten Laden im lokalen Zwischenspeicher, danach laeuft die Umwandlung offline, ohne Upload, ohne Konto und ohne entfernte Schnittstelle. Wer Vertraege, Geschaeftsberichte oder Krankenakten verarbeitet, entscheidet mit dieser Regel oft darueber, ob das Werkzeug ueberhaupt in Frage kommt, denn eine Datei, die den Rechner nie verlaesst, braucht keine Erklaerung fuer die Pruefung.
Dieselbe Kette laeuft an mehr als einem Ort. Wer sie lokal zum Laufen gebracht hat, verschiebt dasselbe Dokumentmodell und dieselbe Einstellung in einen Dienst im eigenen Netz, fast ohne Aenderung am aufrufenden Code, und darueber liegt erst die kommerzielle Unterbringung. Fuer Einzelne und kleine Teams reichen die ersten beiden Stufen.
Woran es danach anschliesst
Die Ausgaben sind breiter als die Eingaben. Struktur geht nach JSON, Lesbarkeit nach Markdown, HTML oder reinem Text, und fuer die Suche wird entlang von Kapiteln und Tabellengrenzen geschnitten statt nach einer festen Zeichenzahl. Jedes Stueck traegt Seitenzahl und Koordinaten, sodass eine Antwort auf eine Stelle im Original zeigen kann.
Dazu kommt ein MCP-Server, mit dem ein Agent das Lesen eines Dokuments als typisierten Werkzeugaufruf behandelt, statt PDF-Bytes an ein Modell zu werfen und raten zu lassen. In Rahmen wie LangChain und LlamaIndex gibt es fertige Anschluesse.
Was hineingeht, ist vielfaeltiger als erwartet. Neben einer Reihe von Office-Formaten und EPUB stehen Mail, Kalender und Untertitel auf der Liste, und Aufnahmen wie Video werden in dasselbe Dokumentmodell gebracht, sodass eine Mitschrift einmal entsteht und danach ueber dieselbe Struktur gelesen wird.
Eine PDF in Text zu verwandeln schafft jedes Werkzeug im Netz. Docling verdient seinen Platz mit der anderen Haelfte: Tabellen bleiben Tabellen, Formeln bleiben LaTeX, Ueberschriften bleiben beim Bild, und zwei Spalten werden nicht quer gelesen. Bleiben diese Strukturen beim Umwandeln erhalten, muessen Suche, Wissensbasis und Modell sie spaeter nicht neu raten.