
本地跑一个文生视频模型:CogVideoX 代码与 2B 模型都是 Apache 2.0
用过智谱清影的人,未必知道它背后的模型是开源的。CogVideoX 的官方仓库在模型介绍里写得很直接:CogVideoX 是源自清影(QingYing)的视频生成模型的开源版本。换句话说,网页端排队等待生成的那种能力,有一份可以下载到本地自己跑的对应版本。
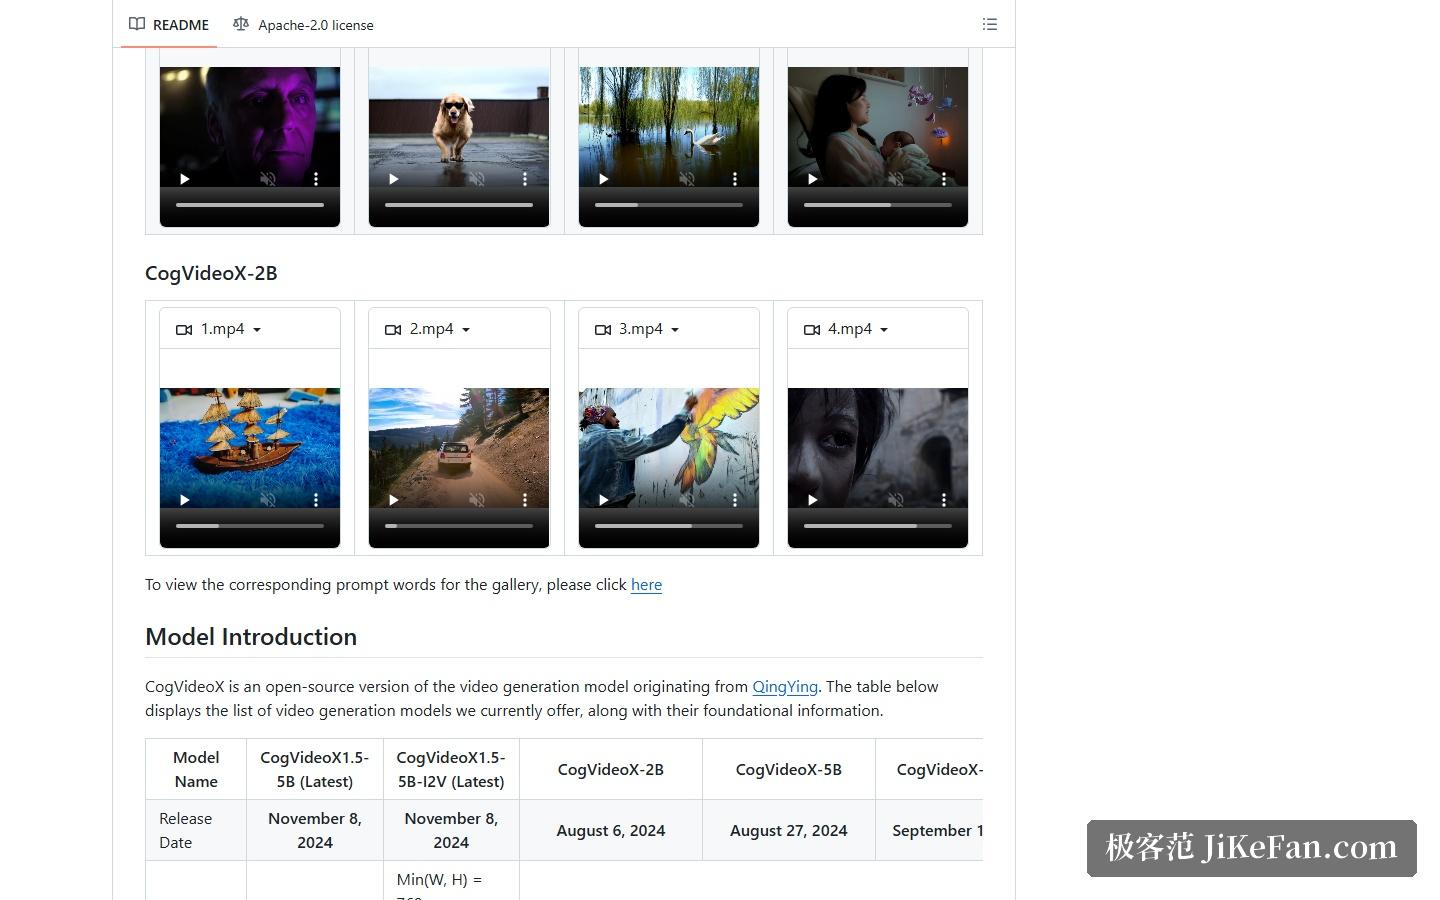
不过两者并不等同。官方在页面顶部就把关系说清楚了:想体验更大规模的商业视频生成模型,可以访问清影与 API 平台;而这个仓库提供的,是对应的开源版本。商业版面向线上大规模生成,开源版把权重和代码交到你自己手里。
五个型号,规格差异不小
官方在模型表里列出了目前提供的全部型号:CogVideoX1.5-5B、CogVideoX1.5-5B-I2V、CogVideoX-2B、CogVideoX-5B、CogVideoX-5B-I2V。名称里的 I2V 指图生视频,其余为文生视频。发布节奏也能看出这条线的演进:2024 年 8 月 6 日放出 CogVideoX-2B,8 月 27 日补上 5B,9 月 19 日开源图生视频模型 5B-I2V,11 月 8 日更新到 1.5 版本。
型号 | 分辨率 | 时长 | 帧率 |
|---|---|---|---|
CogVideoX-2B | 720×480 | 6 秒 | 8 fps |
CogVideoX1.5-5B | 1360×768 | 5 秒或 10 秒 | 16 fps |
CogVideoX1.5-5B-I2V 的分辨率规则更灵活:短边取宽高里的较小值等于 768,长边在 768 到 1360 之间且能被 16 整除,这个范围内都支持。从 720×480 到 1360×768,再到图生视频的灵活比例,这一系列把常见的输出规格基本覆盖了。
显存与速度:能不能跑在你的机器上
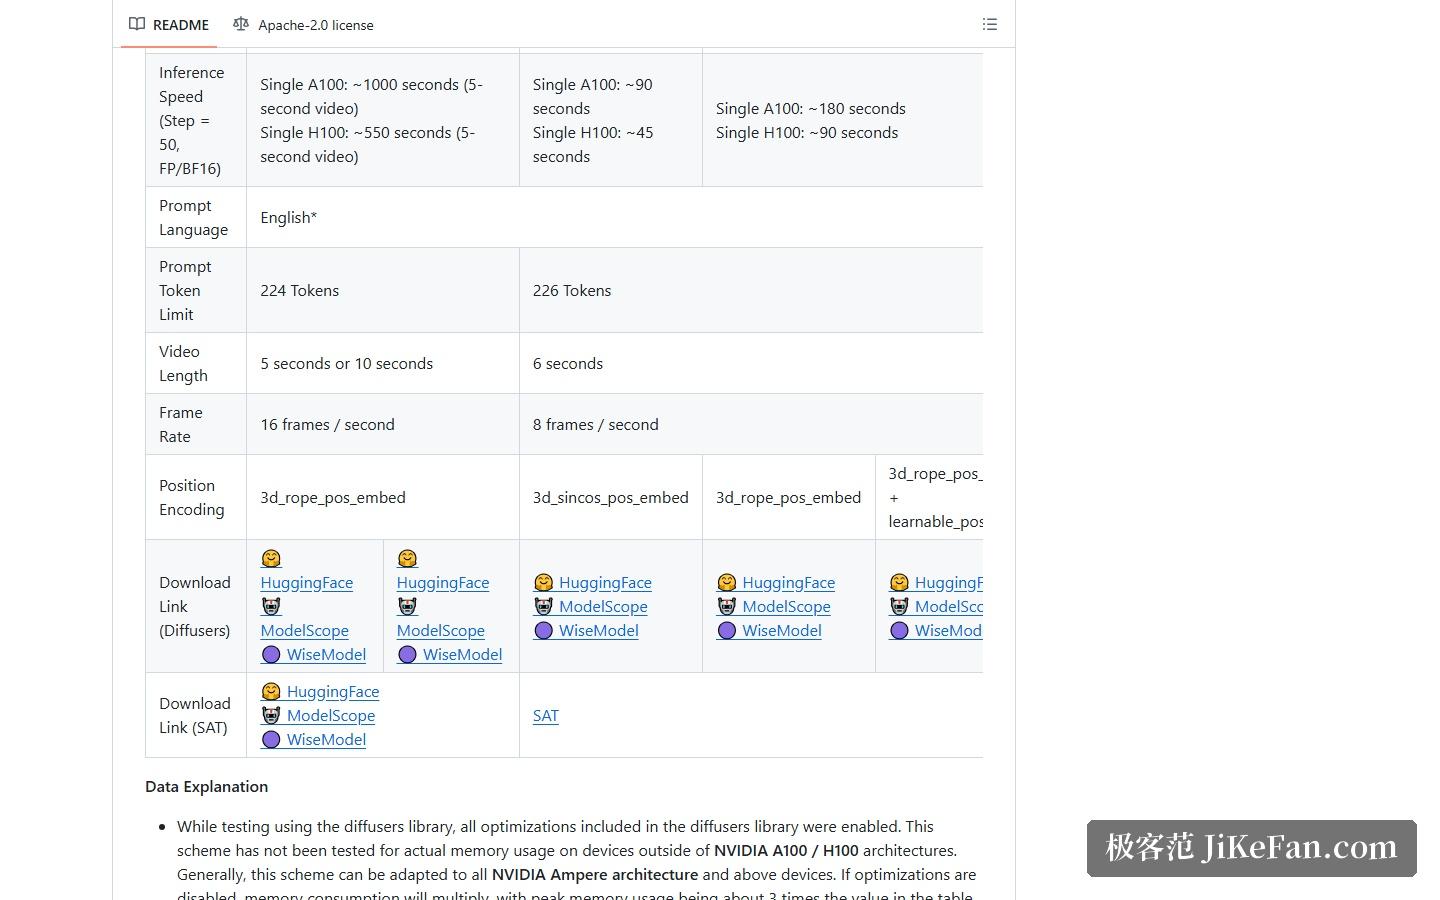
官方在数据说明里给了三组显存数字,都以 CogVideoX-2B 为例:用 SAT 搭配 FP16 推理时占用 18GB;换到 diffusers 下 FP16 最低 4GB;再用 INT8 量化(torchao)能压到最低 3.6GB。同一份说明里也提醒,INT8 是为了适配显存更小的显卡而降低推理速度,并非没有代价。
速度方面,官方给出的实测条件是步数 50、FP16/BF16 精度。CogVideoX-5B 在单张 A100 上约需 180 秒,在单张 H100 上约需 90 秒。更新的 CogVideoX1.5-5B 因为要出 5 秒或 10 秒的高分辨率视频,同样条件下 5 秒视频在 H100 上约需 550 秒——能力更强,代价是等待时间明显拉长。官方也说明,这组测试开启了 diffusers 库中的全部优化,并未在 A100 与 H100 之外的设备上验证真实显存占用,如果优化被关闭,峰值显存会是表内数值的三倍左右。
动手前要确认的两件事
第一是 Python 版本。官方在 SAT 与 diffusers 两条推理路径下都写明了同一条要求:Python 版本需要在 3.10 到 3.12 之间,含 3.10 与 3.12 本身。仓库同时提供了两套代码,其中 SAT 包含 SAT 权重的推理与微调代码,diffusers 那套对常用参数的说明更详细,适合先跑通再改动。
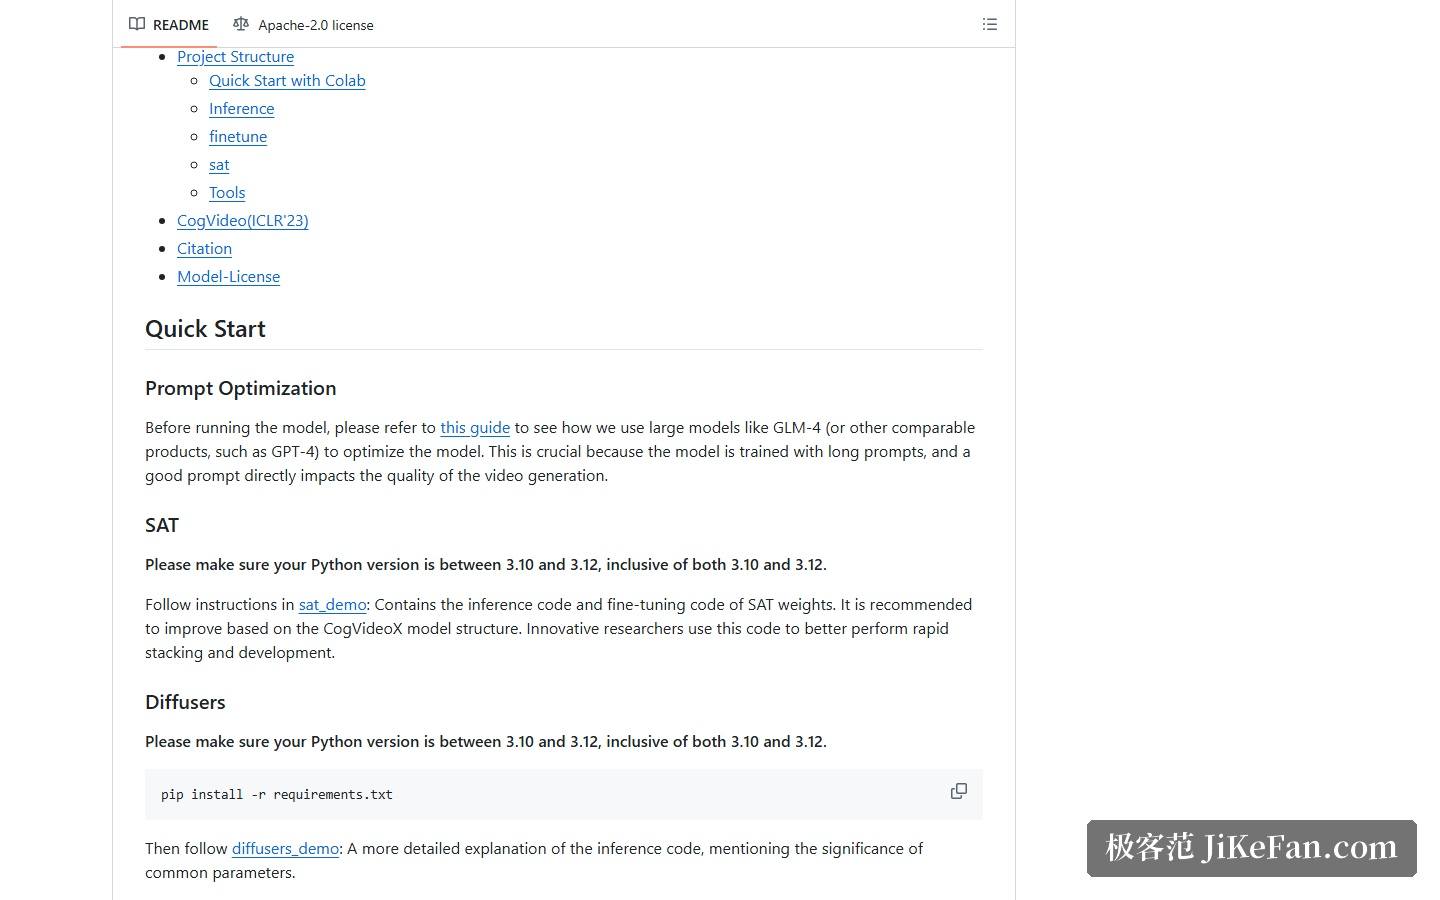
第二是提示词语言。这套模型只支持英文输入,其他语言需要先翻译成英文。官方在提示词优化一节建议用 GLM-4 或同类大模型把输入润色成模型适用的长文本——模型是用长提示词训练的,提示词质量会直接影响生成效果。仓库标出的提示词长度上限是 224 到 226 个 token。
许可证:代码和模型要分开看
仓库的代码以 Apache 2.0 许可证发布,这一点没有歧义。模型则要分型号看:CogVideoX-2B(含对应的 Transformer 与 VAE 模块)同为 Apache 2.0;CogVideoX-5B(Transformer 模块,含 I2V 与 T2V)使用单独的 CogVideoX LICENSE。如果你的场景对许可宽松度有要求,2B 这一档的边界更清楚;打算用 5B 之前,建议先把那份 LICENSE 读完。
仓库里有什么
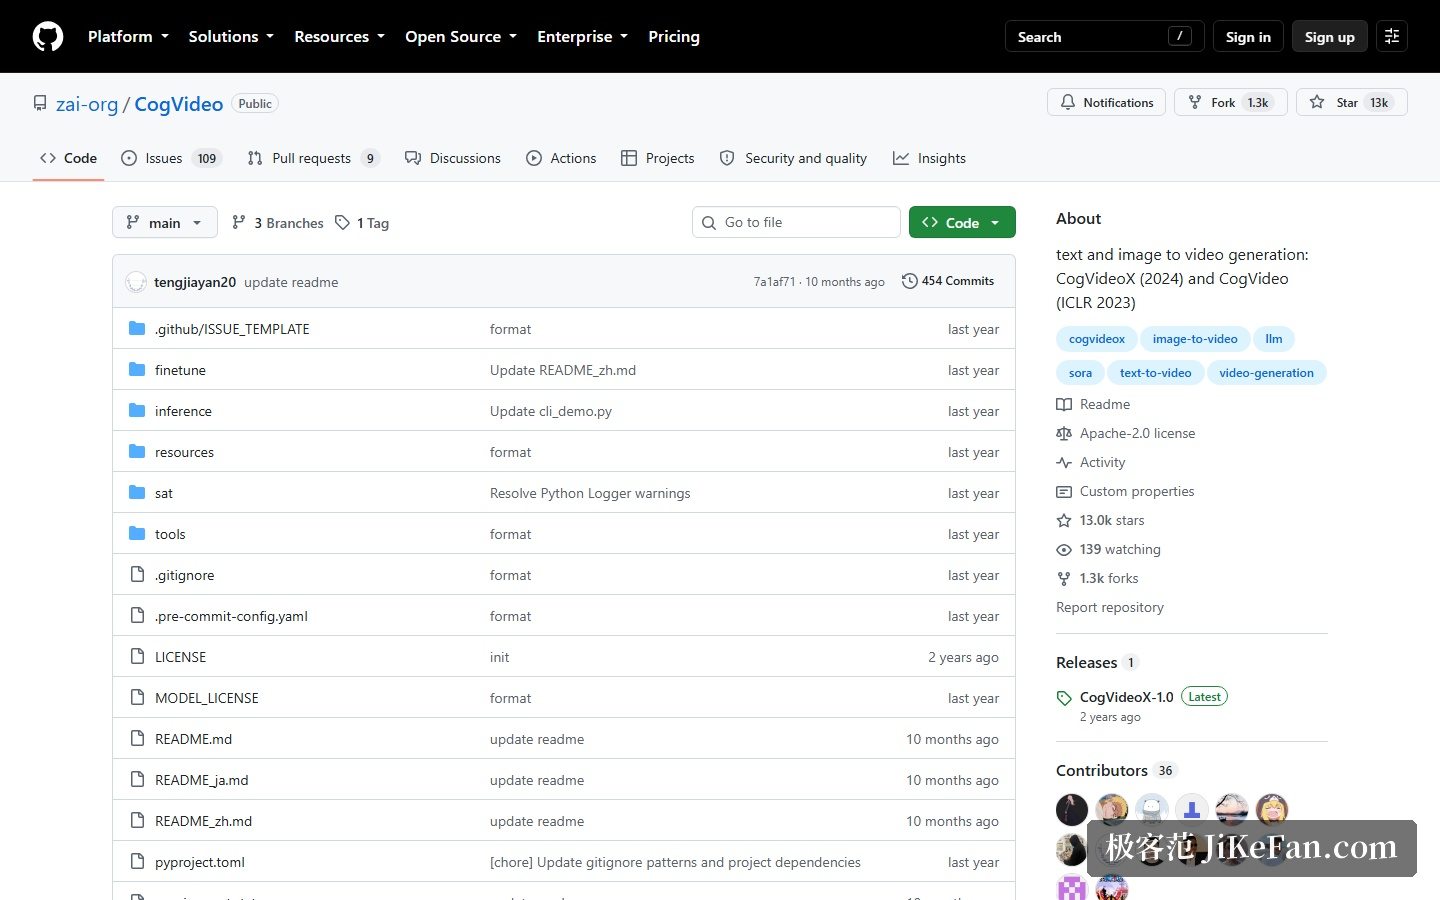
根目录结构很直白:sat 与 inference 是两套推理代码,finetune 放微调,resources 存素材,tools 是工具脚本;许可分成两个文件,LICENSE 覆盖代码,MODEL_LICENSE 单独说明模型。仓库目前有 13k 颗星与 1.3k 次 fork,官方登记的版本号为 CogVideoX-1.0。
近一年的更新
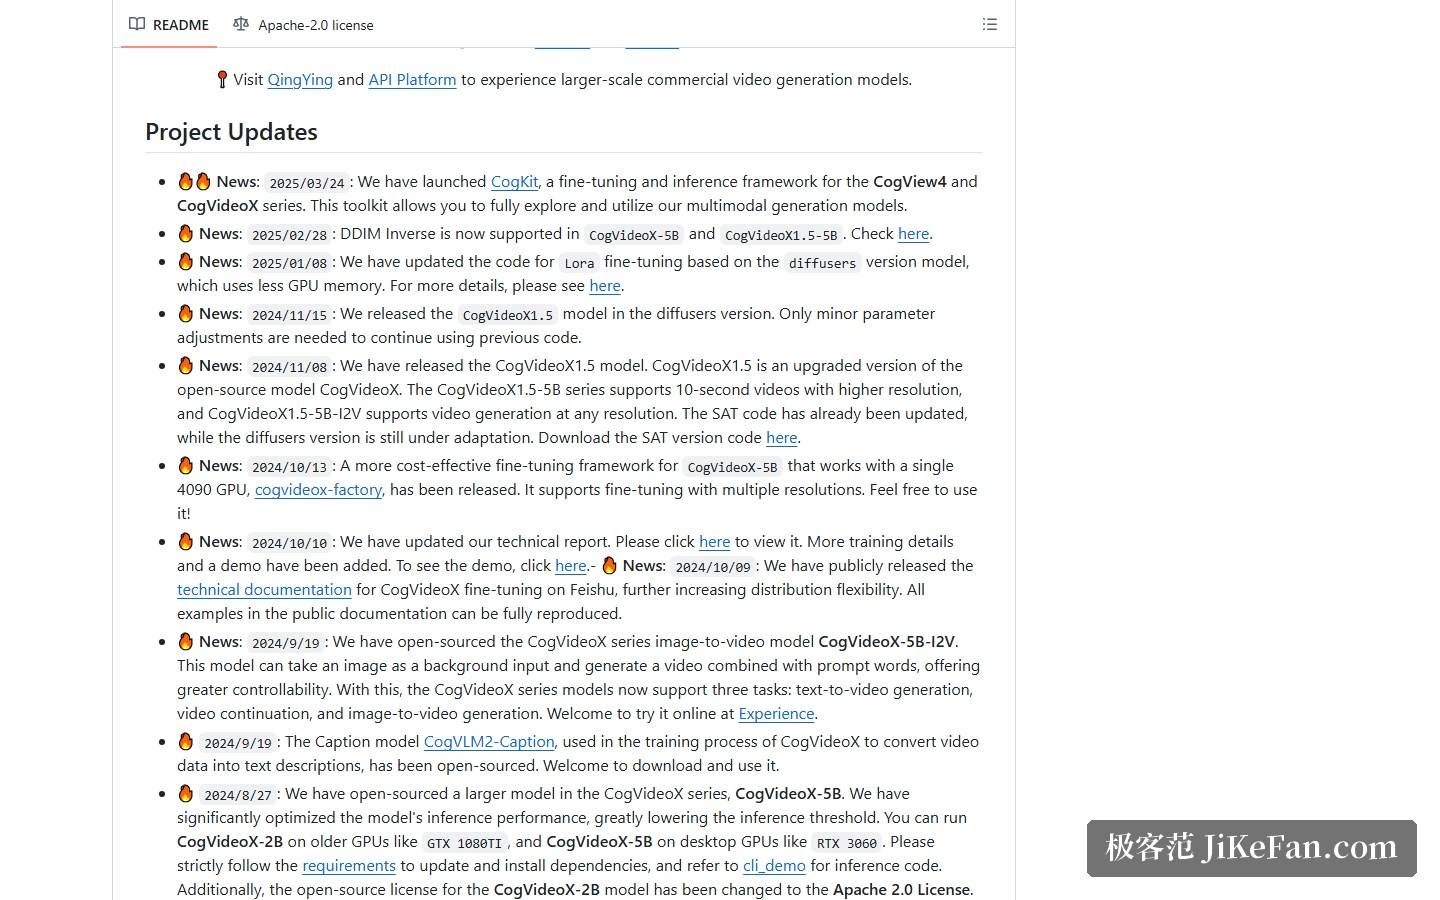
更新日志也能说明这条线的活跃程度。2025 年 3 月推出 CogKit,一套面向 CogView4 与 CogVideoX 系列的微调与推理框架;2 月为 CogVideoX-5B 与 CogVideoX1.5-5B 补上了 DDIM Inverse 支持;1 月更新了基于 diffusers 的 LoRA 微调代码。再往前,2024 年 10 月放出的微调框架让 CogVideoX-5B 的微调可以跑在单张 4090 上,官方同时提到 CogVideoX-2B 能在 GTX 1080Ti 这类更早的显卡上运行,5B 则对应 RTX 3060 这一档桌面显卡。
它适合谁
如果你想把视频生成接进自己的工作流,又不希望受线上服务的排队、额度和内容策略牵制,CogVideoX 提供了一条可控的本地路径:权重开放、代码开放,显存门槛能压到 3.6GB 这一档。它更适合有显卡、也愿意折腾环境的人——Python 版本、依赖、量化精度、提示词语言,每一步都得自己确认清楚。
反过来说,如果你只是偶尔生成一段视频,或者不想处理环境和依赖,直接用线上服务更省事。本地部署省下的是各种限制,付出的是时间和一张够用的显卡。
还有一点值得提前知道:这套模型只吃英文提示词。中文用户想用得顺手,得先解决"把想法翻译成模型能理解的长描述"这一步——而这一步的质量,往往比换一个更大的型号影响更明显。
开源模型的真正价值,不在于复刻一项线上服务的全部能力,而在于把生成过程搬回你自己的机器上。先确认显卡和环境能不能接受它,再谈效果。