
-
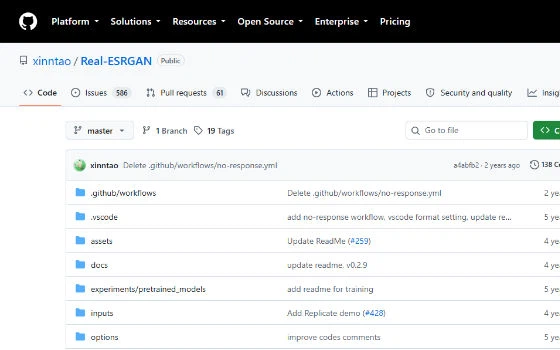
Real-ESRGAN:整排放大工具底下那個演算法
它是一個應用,也是一篇論文與其官方實作:訓練資料全用合成方式產生,授權寬鬆到整排圖形介面產品都把它包進外殼。三條使用路徑,代價各不相同。
-
可圖 Kolors 把中文字寫對,程式碼與權重都開源
一個能把漢字畫對而不是畫成亂碼的文生圖模型,程式碼與權重都放出來,還能接進既有的生成流程——只是面向一般使用者的入口如今搬到另一個平台上。
-
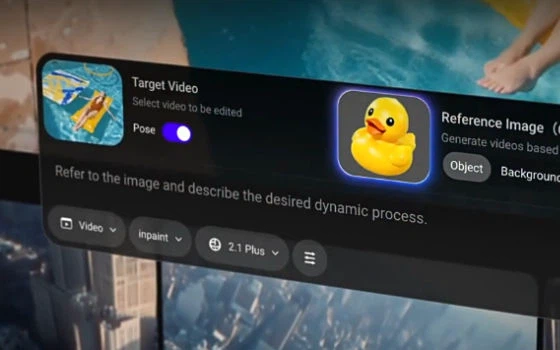
通義萬相一次生成三十秒有聲影片,還能接著改
第三代一次就能生出最長三十秒的多鏡頭影片,臺詞、配樂與音效都是原生帶出來的,最多吃二十個多模態素材含檔案與網頁,成片之後還能編輯與延長。
-
即夢 AI 把出圖、出片與畫布收進同一個入口
出圖、出片與一塊能繼續改圖的畫布共用同一個入口,首幀與尾幀都能釘死,整套流程更是繞著中文提示詞設計的。
-
Recraft 直接吐出可編輯的 SVG 向量圖,不是像素
它交出來的是能繼續編輯的向量檔,不是點陣圖;不必訓練,丟幾張樣本進去就能把一整套品牌調性固定住,字要寫多長、擺在哪裡也都能指定。
-
Adobe Firefly 把授權安全擺在驚豔之前
自研模型只用授權素材與公有領域內容訓練,沒有 Beta 標記的輸出可直接商用,生成式填色更是直接長在 Photoshop 裡,不必另外開工具。
-
Flux 把出圖與改圖併進同一份權重,小體型也能商用
第二代裡體型較小的那個成員,用同一份權重做完文字生圖、單一參考圖編輯與多參考合成,商用不設限,近兩代中高階遊戲卡就能跑起來。
-
Invoke 開場就是一塊能畫的畫布,不是一個提示詞框
Apache 2.0 授權的自架出圖工作台,生成與修圖共用同一張無限畫布,圖層能各自帶提示詞,畫布背後還有一套可重複執行的節點流程。
-
Fooocus 把取樣器藏起來,只留一個提示詞框
整套取樣參數收進預設背後,介面上只剩提示詞與生成鍵;內建的離線提示詞引擎會補齊風格與光線,一句話也能出四張完成度很高的圖。
-
SD WebUI Forge 留著舊介面,把底下那一層整個重寫
分頁一樣、參數欄一樣、模型資料夾也照舊;重寫的是記憶體追蹤與新模型支援,原本吃力的顯示卡現在能把同一件事做快一倍。
-
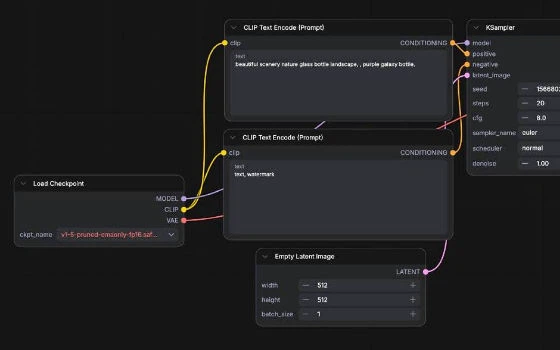
ComfyUI 把出圖拆成一張可以重新接線的圖
每一步都是一個方塊,用線接成整條流程;存成檔案就能原樣重跑,把成圖拖回來還能還原整張圖,環境也能切成互不干擾的幾套。
-
Waifu2x-Extension-GUI:放大是「有依據的猜」
Waifu2x-Extension-GUI 用一個從圖片學來的模型來放大與清理影像,而不是用一條插值規則。這個差別同時解釋了它哪裡做得極好,以及它哪裡會捏造出原本不存在的東西。
-
第 1 / 1 页