
Umi-OCR 2.1.5, 네트워크 없이 글자를 읽다
요약
Umi-OCR 2.1.5 버전은 캡처와 이미지 폴더, 스캔한 PDF를 네트워크 없이 읽습니다. 글자를 골라 복사하고 제외 영역도 정합니다.
추천- 이름
- Umi-OCR
- 버전
- 2.1.5
- 요금
- 무료
- 오픈소스
- 오픈소스
- 운영체제
- WindowsLinux
- 업데이트
- 2026-11-14 23:00
스캔한 종이, 화면 캡처, 남이 보내온 그림. 글자는 분명히 거기 있는데 문서로 옮기려면 한 글자씩 쳐야 합니다. 한 번 해 본 사람은 기억합니다. 온라인 인식은 수고를 덜어 주지만 파일을 남의 서버로 넘기는 값을 치릅니다. 망을 끊은 기계, 보안이 필요한 자료, 또는 그냥 번거로움이 싫은 경우에는 쓸 수 없는 길입니다. Umi-OCR은 자리를 바꿉니다. 인식 엔진을 자기 기계에 두고 네트워크 없이 돌립니다. Python과 Qt로 쓴 오픈 소스이며 MIT 라이선스이고, 배포판은 압축을 풀면 바로 쓰며 별도 실행 환경을 설치할 필요가 없습니다. 제작사는 운영 체제별로 패키지를 나눠 Windows와 Linux에 각각 판이 있고, 화면 언어도 열 가지가 넘습니다.
무료, 오픈 소스, 일괄 처리가 되는 오프라인 OCR 소프트웨어. 프로젝트 첫 화면은 자기 자리를 담백하게 적었습니다. 형용사 없이 세 가지 속성만 나열했습니다.
캡처한 뒤에는 글자를 골라 잡을 수 있다
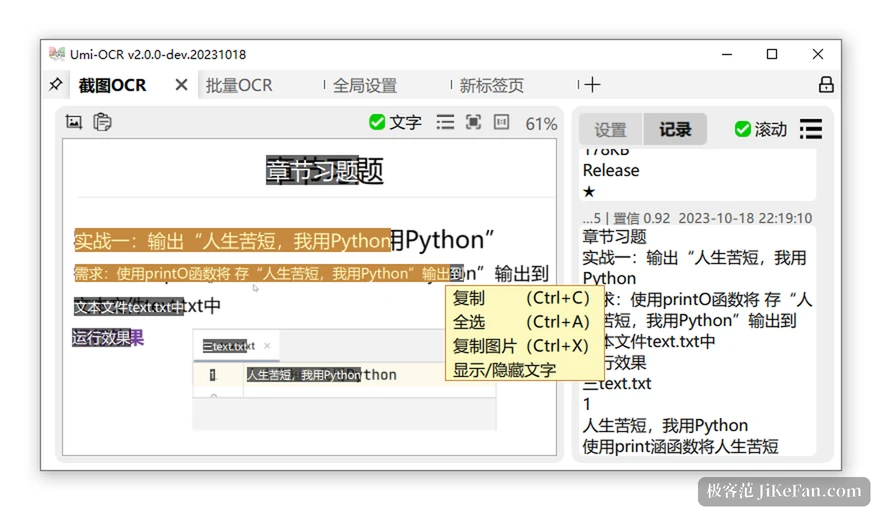
기본 화면은 탭 구조로, 캡처 인식, 일괄 인식, 전체 설정이 각각 한 쪽을 차지하고 탭을 더 열 수도 있습니다. 캡처 쪽은 왼쪽에 방금 잡은 화면, 오른쪽 칸에 설정과 기록이 들어갑니다. 인식이 끝나면 왼쪽 그림에서 마우스로 글자를 골라 잡을 수 있고, 오른쪽 기록은 최근 것부터 결과를 늘어놓으며 줄마다 확신도를 붙입니다. 0.92 같은 숫자는 예쁘지 않지만 이 줄을 얼마나 믿어도 되는지 정직하게 알려 주어, 사람이 다시 볼 곳이 한눈에 드러납니다.
2.1.5 버전부터는 대부분의 탭을 좌우나 위아래 두 칸으로 바꿀 수 있어, 화면이 좁을 때 기록을 아래로 내리면 그림이 보이는 면적이 늘어납니다. Esc를 누르면 기본 창이 숨는 기능은 캡처를 자주 하는 사람을 위한 지름길입니다.
조판 해석으로 흐트러진 덩어리를 말로 되돌린다
인식의 원죄는 글자를 틀리는 것이 아니라 두 단의 문단을 인식 순서대로 한 솥에 쏟아붓는 일입니다. Umi-OCR은 글자 후처리에 조판 해석을 넣어 여러 단, 한 단, 한 줄 같은 몇 가지 방식으로 결과를 다시 배열하고, 출력 순서를 원문의 읽는 순서에 가깝게 만듭니다. 한 줄 방식은 또 다른 흔한 경우도 다룹니다. 멀리 떨어진 두 덩어리 사이에 빈칸 하나를 넣어 문장이 붙어 버리지 않게 합니다.
이런 세부는 기능 목록에 나오지 않습니다. 그러나 긴 대목을 복사해 내고 나서 문장을 손으로 끊지 않아도 된다는 것을 알아차릴 때 차이가 느껴집니다.
일괄 쪽은 작은 흐름 작업장
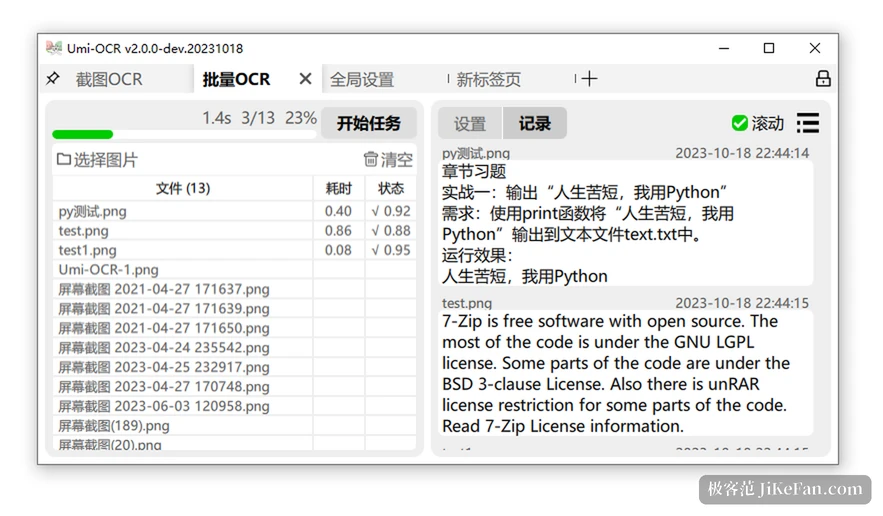
왼쪽에는 파일 목록이 있어 이름, 걸린 시간, 상태가 나오고, 상태 칸의 표시 뒤에는 같은 확신도가 따라붙습니다. 위쪽 막대는 끝난 장수와 백분율을 보여 줍니다. 오른쪽 기록은 파일별로 묶여, 그림을 누르면 그 결과를 읽고 아래로 굴리면 같은 묶음의 다른 파일 결과도 보입니다.
시간을 줄여 주는 것은 동시 실행보다 돌아가는 동안 함께 읽을 수 있다는 점입니다. 끝난 파일은 묶음 전체가 끝나기를 기다리지 않고 목록에 들어옵니다. 2.1.5 버전은 그림과 문서 읽기를 비동기로 바꿔, 하위 파일이 수만 개인 폴더도 매끄럽게 펼쳐지고 막대도 따라갑니다. 같은 쪽에는 제외 영역도 있습니다. 사각형을 그리면 그 안의 글자는 인식에 들어가지 않아, 캡처에 함께 찍힌 모서리 표시나 워터마크, 시각 표시를 통째로 건너뜁니다.
스캔한 PDF도 읽는다
문서 인식이 다루는 것은 PDF입니다. 하나는 스캔본으로 쪽에 글자 층이 아예 없어 인식으로 채워야 합니다. 다른 하나는 처음부터 층을 가진 파일로 그대로 뽑아낼 수 있어 인식 수고를 덜어 줍니다. 출력은 두 갈래로, 순수한 글자로 뽑거나 두 층짜리 검색 가능한 PDF를 만듭니다. 원본 모양은 그대로 두고 아래에 보이지 않는 글자 층을 깔아, 이후 뷰어에서 검색과 복사가 정상으로 됩니다.
2.1.5는 이와 관련된 두 가지 결함을 고쳤습니다. 쪽을 돌릴 때 원래 글자가 빠지던 문제, 그리고 한 층짜리 PDF를 만들 때 원문이 쓰이지 않던 문제입니다. 보관해야 하는 계약서나 설명서에는 이 두 가지가 새 기능보다 무겁습니다.
다른 프로그램이 부를 수 있어야 진짜 쓰임
화면 밖에 두 개의 입구를 두었습니다. 명령줄은 시작할 때 지시를 받고 도는 중에도 멀리서 작업을 받습니다. HTTP 접점은 이것을 자기 기계의 서비스로 바꿔, 캡처와 그림, PDF를 요청으로 보내면 돌려주는 결과에 줄마다 좌표와 확신도가 들어 있습니다. Linux 판은 컨테이너로도 돌릴 수 있어 자기 흐름에 끼워 넣습니다.
2.1.5 버전이 더한 기록 장치는 이 길을 위해 있습니다. 명령줄 인수를 붙여 시작하면 실시간 기록이 보이고, 정한 단계 이상의 기록은 기록 폴더에 떨어져 인식 실패를 짐작으로 좇지 않아도 됩니다. 같은 판에는 설정을 다시 읽는 지시도 더해져, 값을 바꾼 뒤 프로그램 전체를 다시 시작하지 않아도 됩니다.
미리 알아 둘 두 가지 경계
인식 엔진은 덧붙이는 형식으로 들어오고, 배포는 엔진에 따라 두 패키지로 나뉩니다. 빠른 쪽은 처리 장치의 명령 집합을 요구해 Pentium, Celeron, Atom 같은 오래된 처리 장치에서는 돌지 않습니다. 초기화가 실패하면 호환판으로 바꾸면 됩니다. 결함이 아니라 추론 틀 자체의 한계이며, 프로젝트 문서에도 그대로 적혀 있습니다.
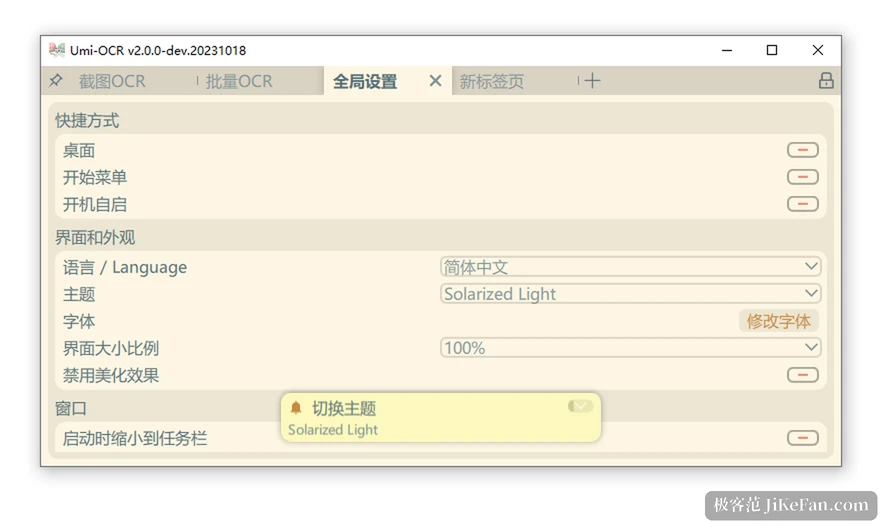
다른 경계는 인식만 하고 판면은 되돌리지 않는다는 점입니다. 표는 글자 흐름으로 나오므로 구조를 지키려면 직접 다시 배열해야 합니다. 화면 언어는 열 가지가 넘고 지역 번역 플랫폼을 통해 유지되며 중국어와 영어도 들어 있습니다.
무엇을 위한 도구인가
Umi-OCR 2.1.5를 쓰는 자리로 되돌려 보면 푸는 문제는 좁습니다. 그림과 스캔본 안의 글자를 복사할 수 있고 검색할 수 있고 다른 프로그램에 넘길 수 있는 글자로 바꾸는 일이며, 그 과정은 기계 밖으로 나가지 않습니다. 캡처에서 골라 잡기, 일괄 순서 기다리기, 제외 영역, 두 층 PDF, 명령줄과 접점. 이것들이 모이면 가끔 한 번 쓰는 자리에서 자동화의 한 단계까지 덮습니다. 무료이고 오픈 소스이며 계정도 네트워크도 필요 없습니다. 민감한 자료를 다루는 자리에서는 이 세 가지 자체가 선택의 이유가 됩니다.