
万能翻译站:文档、PDF、图片和游戏剧本,拖进窗口一次翻完
摘要
免费开源的 Windows 桌面翻译工具万能翻译站,把文档、PDF、图片和游戏剧本拖进窗口,自动识别、提取、翻译并写回原文件,全程在本机完成,可接四类翻译引擎。
推荐- 软件名称
- 万能翻译站
- 版本
- 1.4.1
- 收费
- 免费
- 开源
- 开源
- 操作系统
- Windows
- 更新时间
- 2026-11-12 23:00
在 Windows 上翻译一份外文文档,常见的流程是这样:找到文件、打开阅读器、复制一段、切到翻译页面、把结果贴回去,一份二十页的文档要把这个动作重复几十次。万能翻译站这款桌面工具把这一串收进同一个窗口,文件或整个文件夹拖进去,识别格式、抽出文字、送去翻译、写回原文件都由它完成。项目由 Match0121 开发,采用 MIT 许可,界面是本地窗口而不是网页,处理过程也不依赖网络上传。
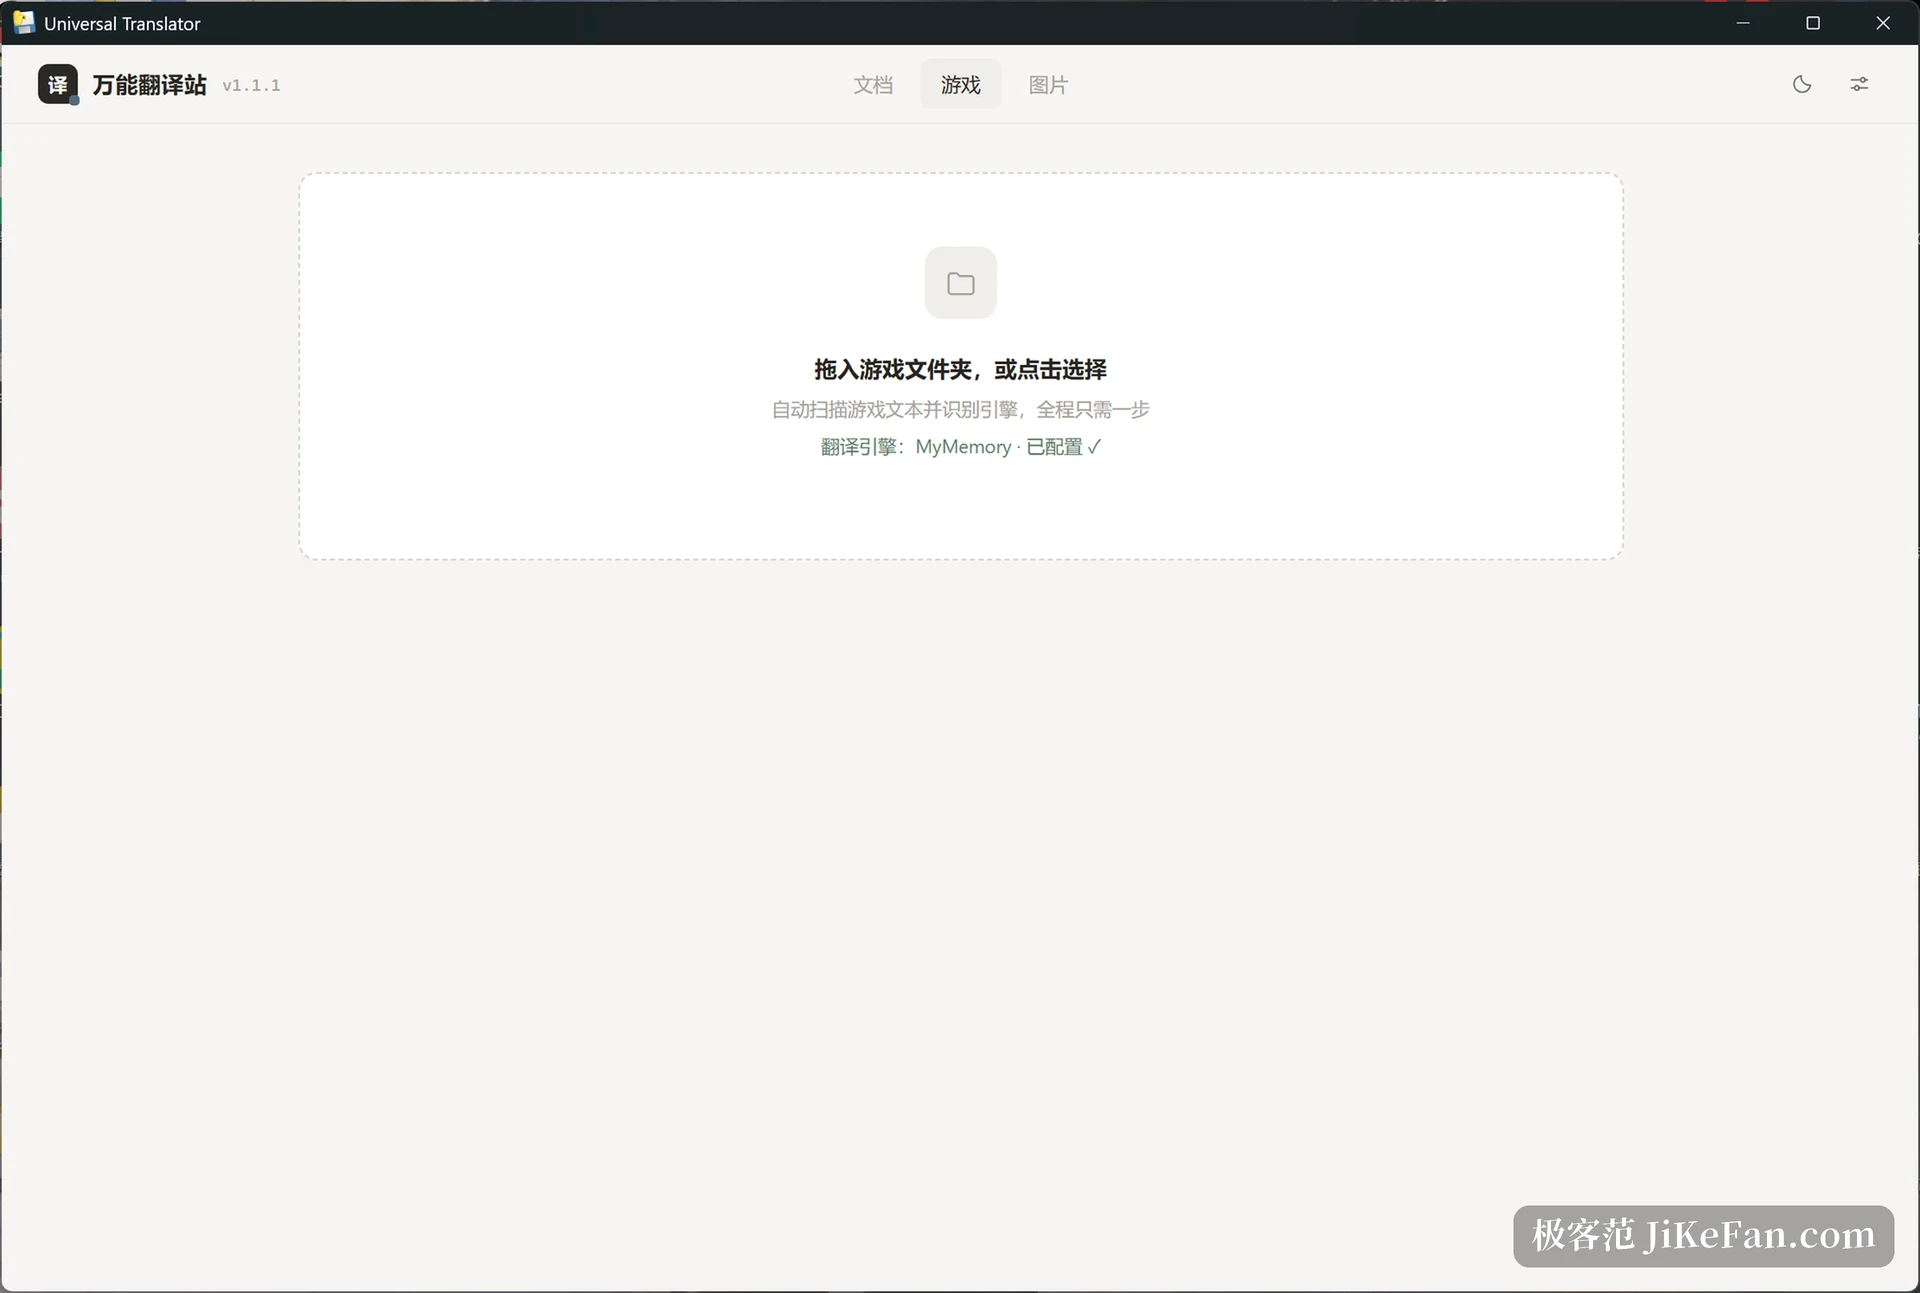
拖进去之后,它先判断这是什么
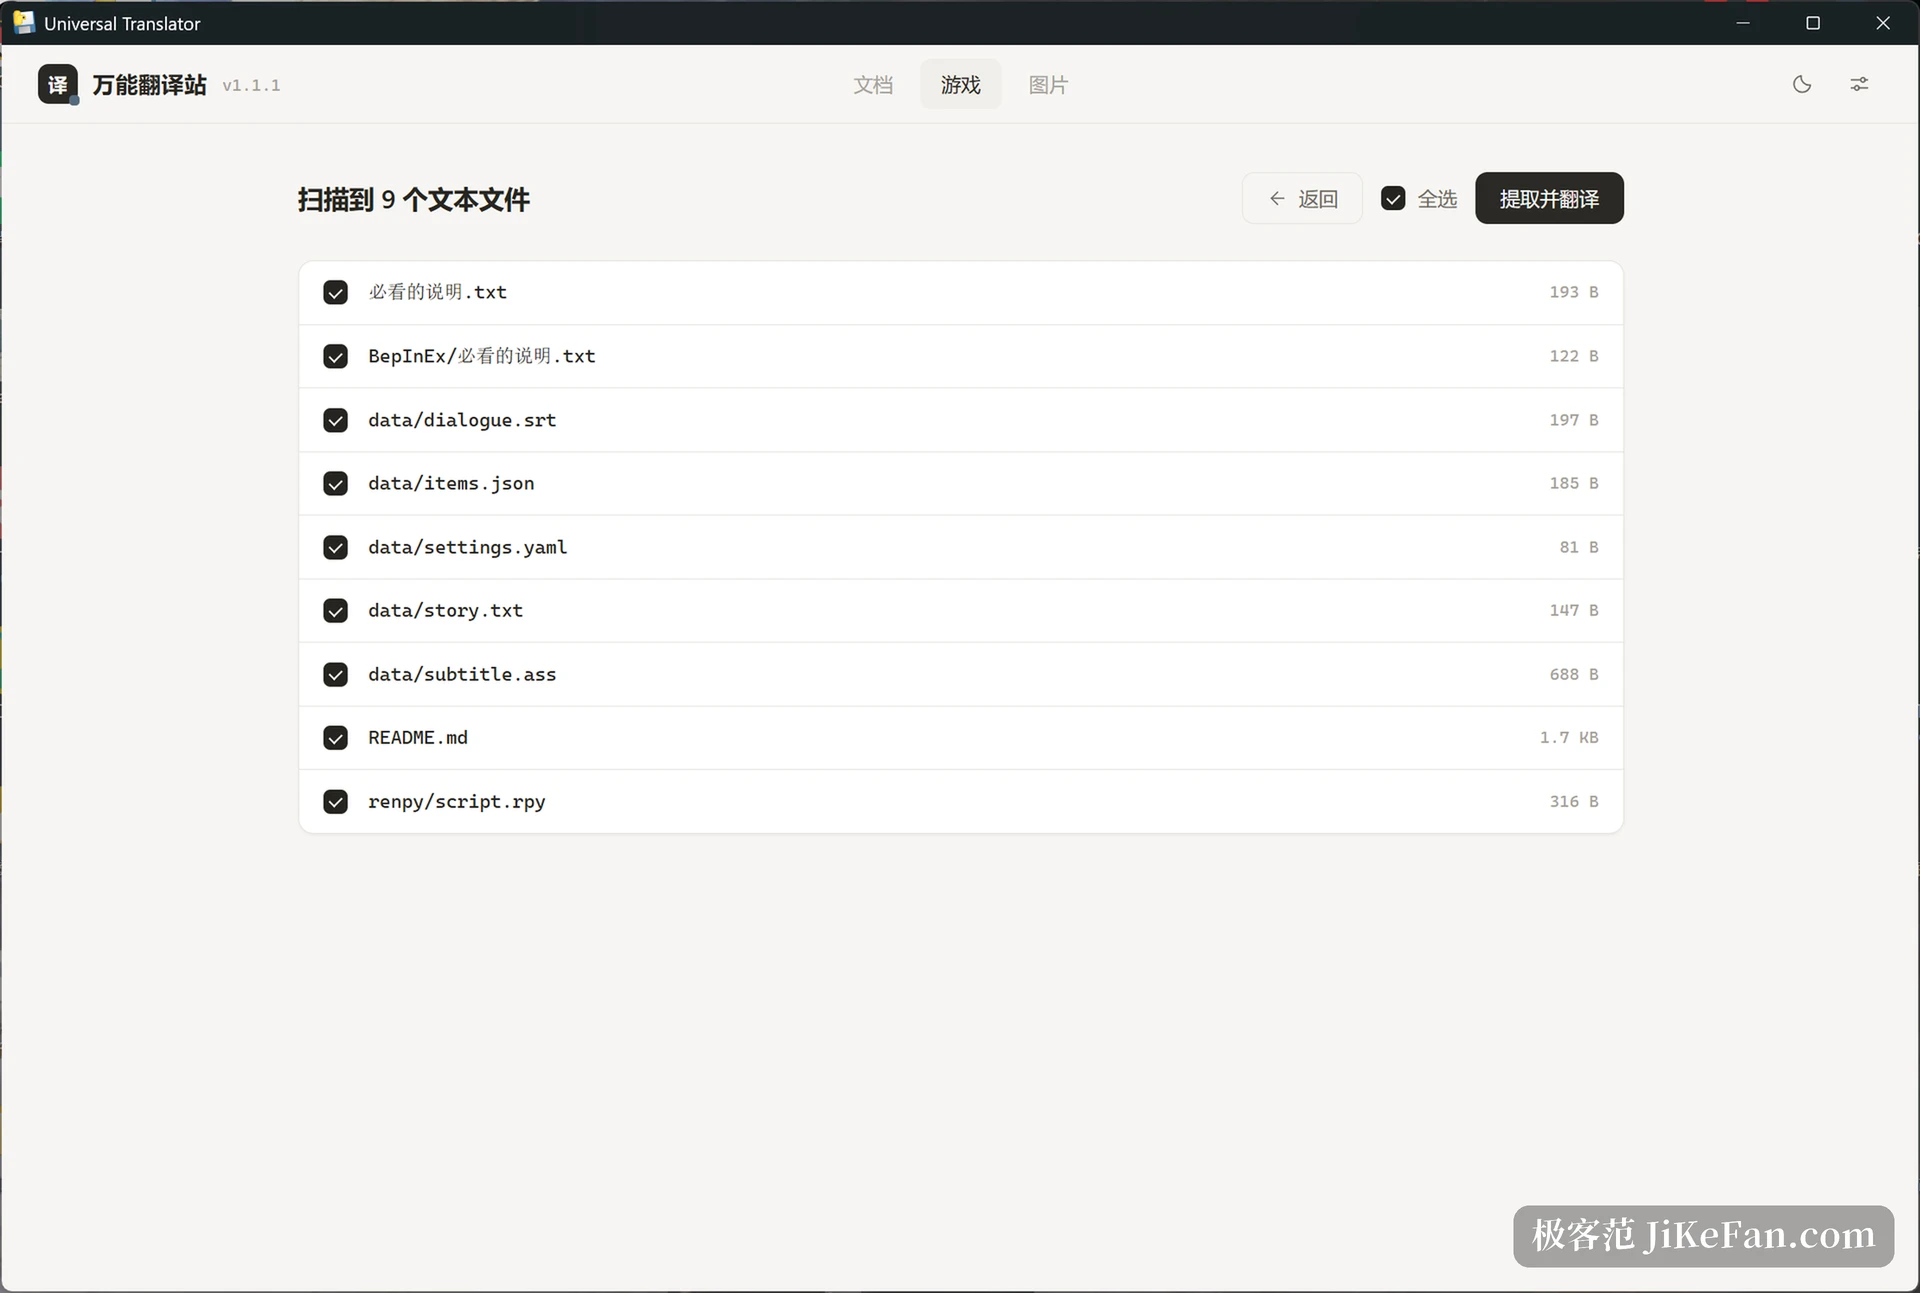
单个文件、一批文件或者一整个文件夹都能拖进窗口,程序递归扫过子目录,按扩展名把内容分成文本、文档、图片与游戏剧本四类。子目录里的同名文件用相对路径区分,不会互相覆盖。扫描结果先列成一张表,勾选要处理的部分,再决定是否开始翻译;单个文件的条目数、每条对应的原文与译文都能展开查看。
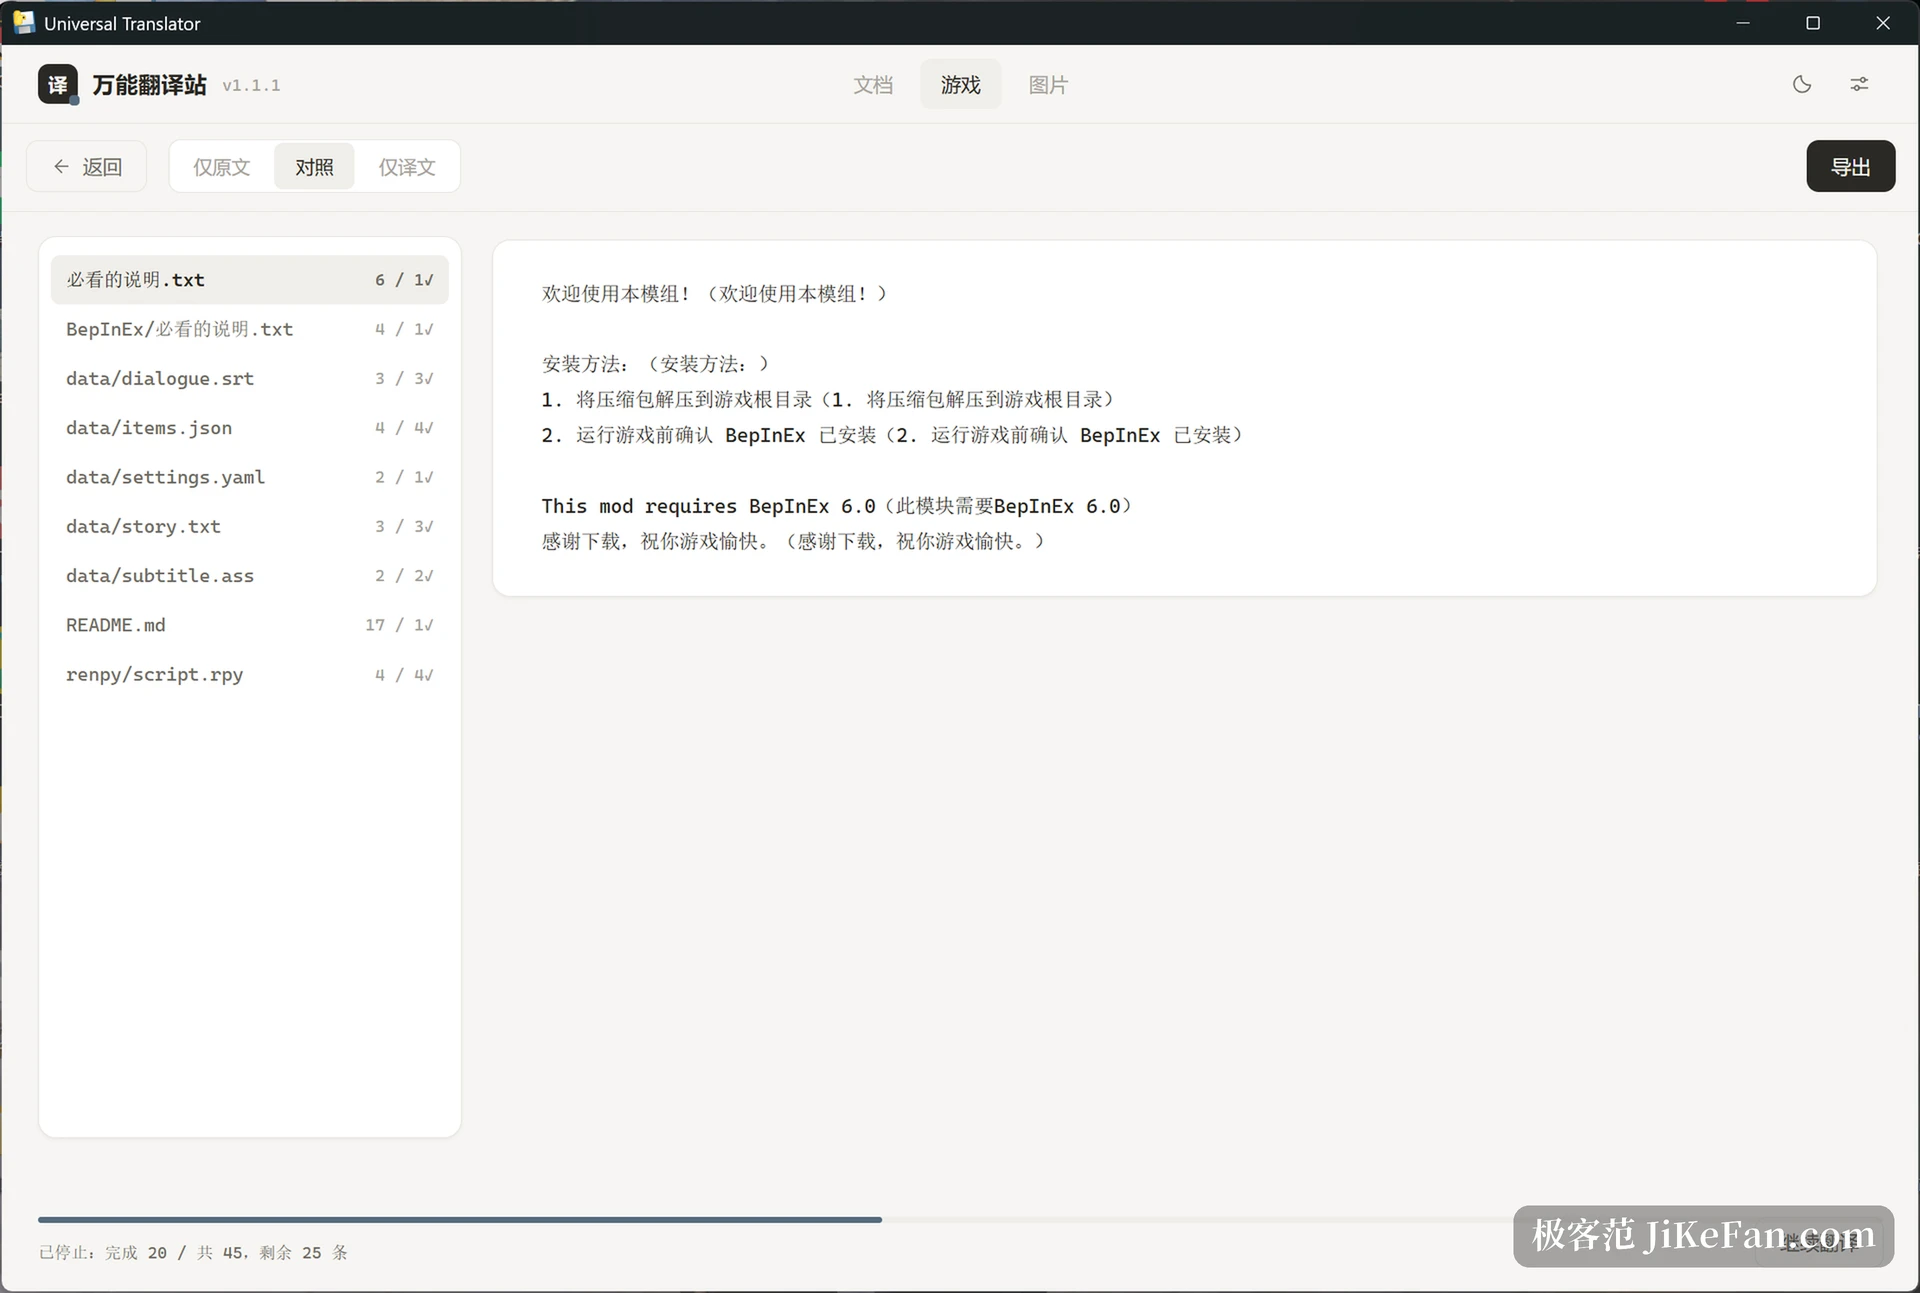
预览界面里原文与译文并排,可以切到只看原文或只看译文。逐条改过的内容会即时保存,导出用的是改过的版本,而不是机器直出的结果。深色与浅色两套主题按上一次的选择记住,下次打开还是那个样子。
文档:Office 与 EPUB 保格式,PDF 分两条路
万能翻译站支持的文档格式包括 Word、Excel、PPT、EPUB、HTML、Markdown 与 TXT,翻译后按原格式写回,字体字号与段落层次不因为换了语言而重排。PDF 的处理要看它本身是什么:带文字层的直接抽取,把原文位置擦掉换成译文,导出仍然是原来的版面;扫描件没有文字层,逐页做文字识别之后按图片的方式把译文覆盖上去,没识别到的区域保持原样。有些 PDF 的文字层是乱码,这时可以强制走图片识别那条路。
文档翻译真正难的地方不是把句子译对,而是译完之后版面还站得住。文本型原地替换、扫描件按图覆盖,两条路分开走,才不至于交出一份排版散架的译稿。
游戏剧本:先认引擎,再处理编码
视觉小说的文本常常是 Shift-JIS 编码的明文,或者锁在吉里吉里的 xp3 资源包里,手动转码、解包、逐句粘贴是件很磨人的事。工具会自动认出 Ren'Py 的 rpy 与吉里吉里的 ks 剧本,编码在 UTF-8、UTF-16、Shift-JIS 与 GBK 之间自行判断,日文剧本不需要先转一遍码;遇到 xp3 资源包,先解包取出剧本,翻完再封包写回原位。加密过的资源包打不开,这条边界写在使用说明里,不算隐藏的坑。导出时保持原编码,只有译文超出原字符集才转存成 UTF-8 并给出提示。
图片:先勾选,再识别
PNG、JPG、WebP、BMP 支持整个文件夹批量导入,识别之前可以把不需要的几张勾掉,省下识别时间。结果按文本平铺并带缩略图,点开缩略图能放大看译文覆盖到图上的效果,确认没问题再导出;覆盖图既可以打包成一个 ZIP,也可以逐张写进指定的文件夹。截图里的深色卡片这类复杂背景,译文会自动反色,不至于在深底上盖出一块白。
引擎、缓存,以及不联网这件事
万能翻译站默认用 MyMemory,不用配置,代价是每日额度有限;百度与 DeepL 需要自己的密钥;OpenAI 兼容接口可以指向本机的 Ollama 或 LM Studio,把翻译整条链路留在局域网里。译文带缓存,重复出现的句子不会反复请求,缓存涨到两万条按最久未用淘汰,也能在设置里一次清空。
所有处理都在本机完成,文件不出电脑,也不需要注册账号。边界同样写在明面上:Unity 与 UE 的资源包、程序里内嵌的字符串都还不支持;跨格式导出只保留文字,标题层级与表格结构不会跟着迁移过去。带文字识别的完整版接近 249MB,另有一个不带识别的精简版,体积小得多。它适合手上常有外文材料、又不愿把文件传到别人服务器上的人,先拿一份不太要紧的文档试一遍,再看要不要把它放进日常工作流。