
Docling 2.150:文档离线转成结构化数据,表格公式图注都跟着走
摘要
Docling 是 MIT 许可的开源文档解析工具,2.150.0 版可离线把 PDF、扫描件与录音转成 Markdown 和 JSON,表格、公式、图注都保留。
推荐- 软件名称
- Docling
- 版本
- 2.150
- 收费
- 免费
- 开源
- 开源
- 操作系统
- WindowsmacOSLinux
- 更新时间
- 2026-11-12 23:00
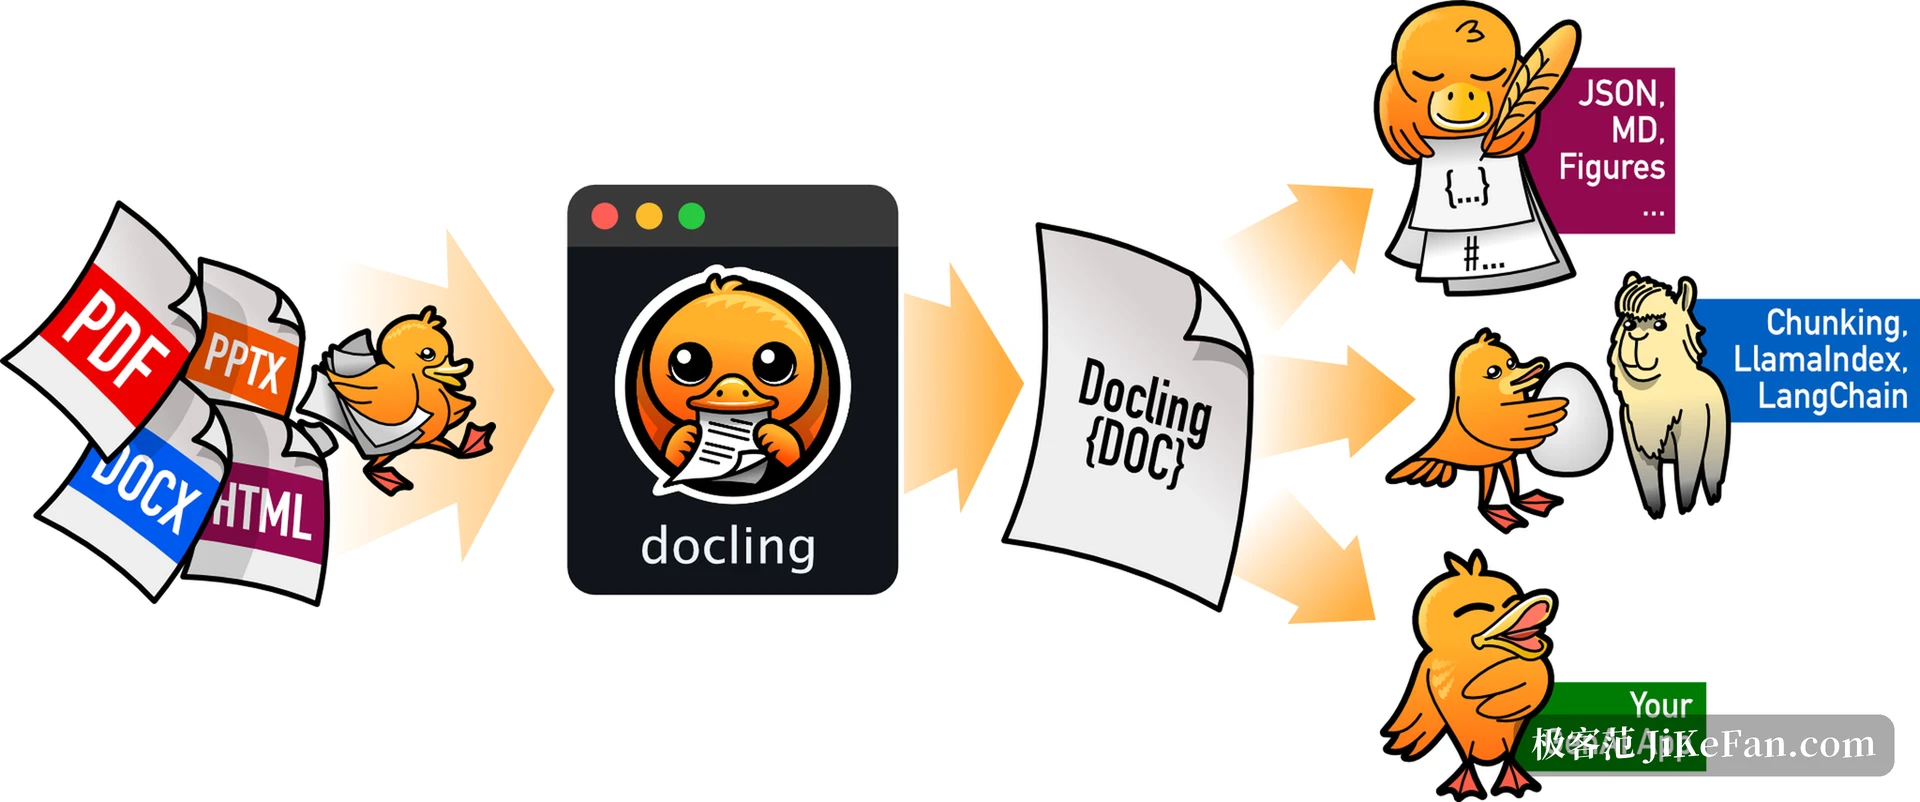
Docling 是一个开源的文档解析工具,装在自己电脑上跑,能把 PDF、Word、PPT、Excel、网页、扫描件乃至录音里的内容拆成带结构的文本,再导出成 Markdown、HTML 或无损 JSON。它最早由 IBM 研究院的团队发起,现由 LF AI & Data 基金会托管,采用 MIT 许可。2026 年 11 月 10 日发布的 2.150.0,把 iXBRL 财报也纳进了输入格式。
先认版面,再抽字
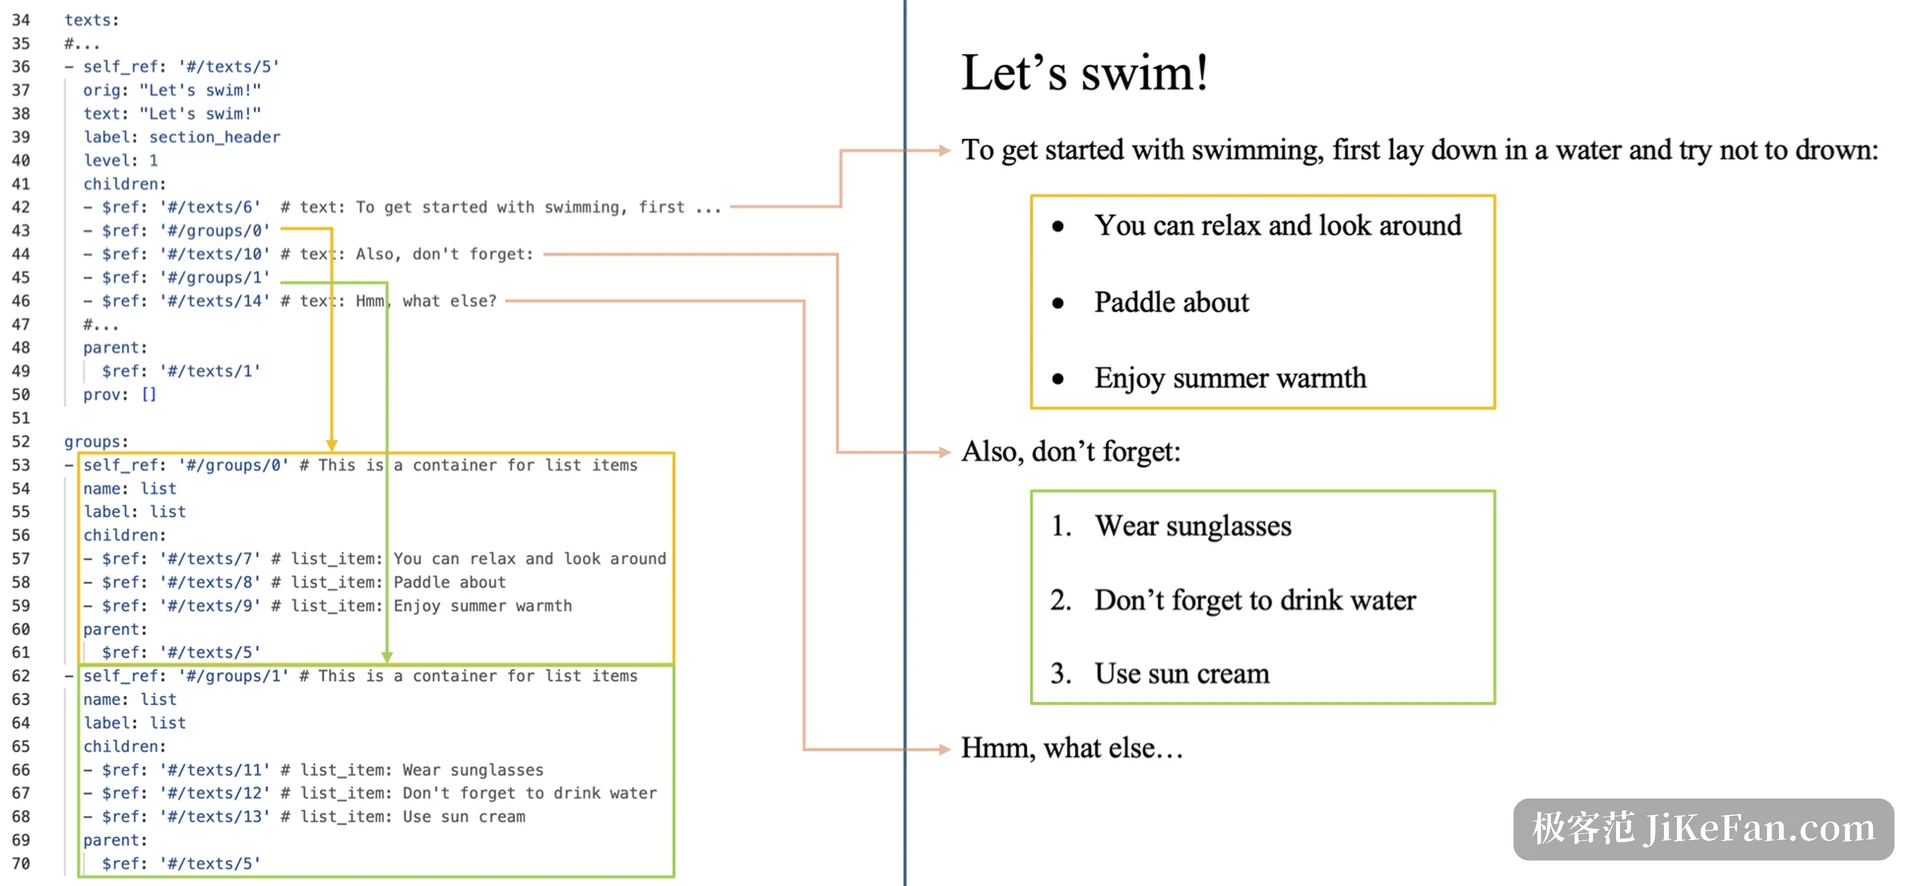
多数转换工具走的是抽字路线:把 PDF 里的文字流按顺序拉出来,拼成一段。Docling 反过来,先认版面。版面模型判断这一页有哪些区域——页眉、页脚、正文段落、列表、代码块、表格、图片、公式,各自边界在哪,然后再排阅读顺序。
双栏论文最能说明差别。按坐标从上往下扫,左右栏的句子会互相穿插;按阅读顺序排,先读完左栏再读右栏,句子才连得上。这个顺序被写进统一的文档模型,后面导出 Markdown 时直接照抄,不用重新猜一遍。
扫描件是另一条路径。整页都是图的时候没有文字流可抽,得走识别。它会先判断这一页有没有可用的文字层,没有才启 OCR;识别引擎可以换,也能挂视觉模型去读版面。模型下载一次,之后都在本机跑。
表格进去,还是表格出来
表格是 PDF 转换最容易翻车的地方。行列一旦被拍平成一行数字,检索和阅读都失去意义。Docling 用表格结构模型把单元格边界认回来,行、列、多层表头按原样保留,跨行跨列的合并单元格也不算丢。表标题不会散在正文里,它跟着表走。
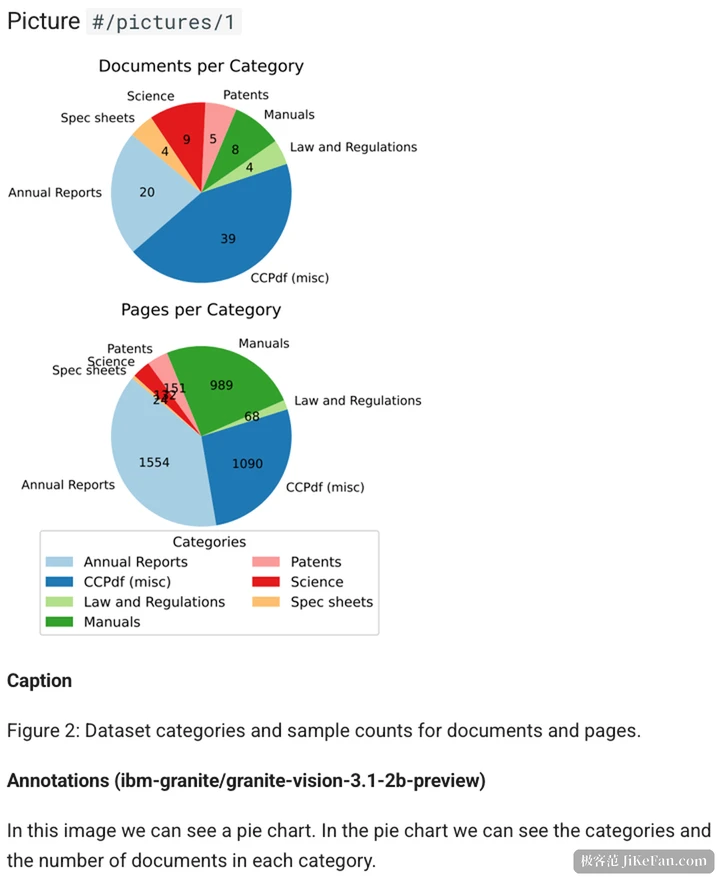
公式同理。行内公式与独立公式被识别成 LaTeX,而不是一串错位的字形。图片单独抽出来,附上它在页面上的坐标、原图注,还有一个内容分类——这张图是折线图、饼图还是照片,模型会给判断。
2.150 这一版改了什么
11 月的版本节奏很密,11 月 3 日到 10 日之间连发了几个版本,改动集中在输入面和抽取控制上。
- iXBRL 输入
- 财报里带内联标签的 XBRL 格式,此前只能当普通网页读,标签里的财务事实会掉;2.150.0 支持直接读入,还能按远程地址解析分类标准。
- 内嵌图片抽取
- PDF 里嵌着的图片改成按需打开,默认不落地,省掉一批不必要的磁盘写入。
- 命令行重排
- 批量转一个目录时参数更直观,输出格式可以一次指定多个。
离线是设计前提,不是附加功能
Docling 默认不联外网:模型第一次下载后缓存在本地,之后转换全程离线,不上传、不注册账号、不调远端接口。处理合同、财报、病历这类材料的人,这一条往往决定能不能用——文件不出本机,合规上就少一层解释。
同一套管线能换跑法。本地跑通之后,相同的文档模型和配置可以搬到局域网内的服务里,业务代码几乎不用改;再往上才是商业托管。对个人和小团队来说,前两档已经够用。
转完之后能接什么
输出比输入更宽。结构化走 JSON,人读走 Markdown、HTML、纯文本;给检索用则直接切成分块——按章节和表格边界切,不是按固定字符数硬切,每个分块带着页码和版心坐标,答案能指回原文的具体位置。
它还有个 MCP 服务端,智能体可以把「读文档」当成一次带类型的工具调用,而不是把 PDF 字节丢给模型去猜。LangChain、LlamaIndex 这类框架里也有现成的接入方式。
能读进来的东西比想象中杂。除了一串 Office 格式和 EPUB,邮件、日历、字幕文件都在支持列表里,录音与视频也能转成同一个文档模型——转写一次,后面按同一套结构取用。
如果只是把一份 PDF 转成文字,随手一个在线工具就能做。Docling 值得留下的理由是另一半:表格还是表格,公式还是 LaTeX,图注跟着图走,双栏不会读串行。这些结构在转换时保住,后面做检索、做知识库、喂给模型时,才不用重新猜一遍。