
KillerPDF 1.9.2:加密修复补上了,涂黑是把字删掉
摘要
KillerPDF 1.9.2 修好了受损加密文档被重写坏的问题,涂黑直接把字从页面删掉,OCR 二十种语言在本机跑,自研引擎替掉三个第三方库,界面十三套主题。
推荐- 软件名称
- KillerPDF
- 版本
- 1.9.2
- 收费
- 免费
- 开源
- 开源
- 操作系统
- Windows
- 更新时间
- 2026-11-11 23:56
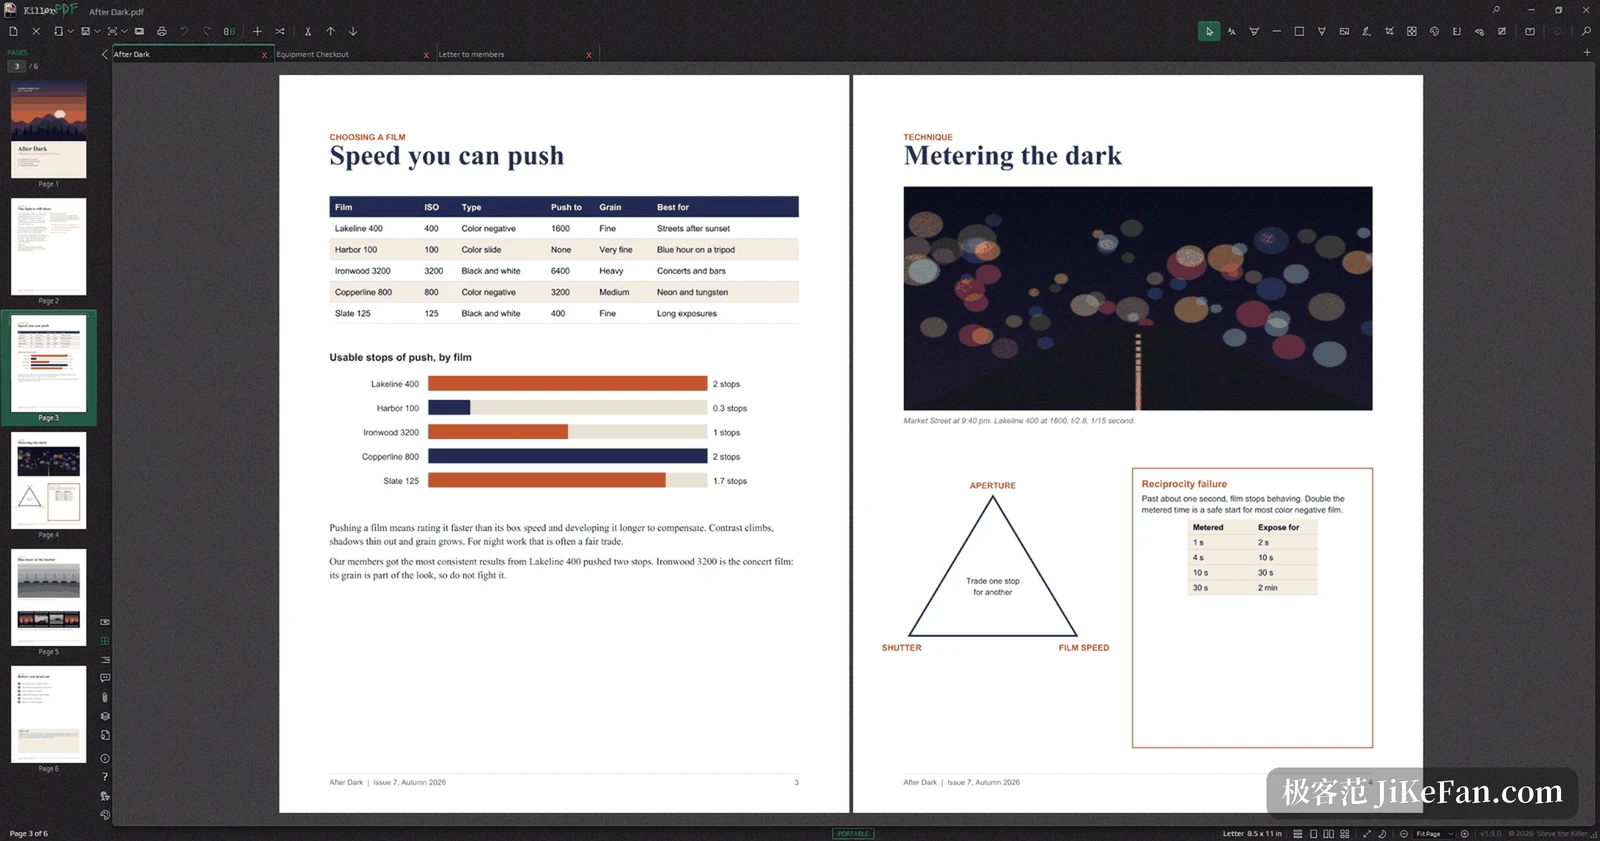
KillerPDF 是一个面向 Windows 的开源 PDF 编辑器,用 C# 和 WPF 写成,按 GPLv3 授权,不需要账号,不发送遥测,也没有广告位。它只支持 Windows 10 和 11 的 64 位系统,没有 macOS 与 Linux 版本。1.9.2 在 2026 年 11 月 2 日发布,安装包约 33.15 MB。这个版本号的改动集中在加密文档这条路上,读起来不像新功能,处理过加密文件的人却知道它躲开了哪种麻烦。
这次改的是加密那条路
更新说明写得很具体:缺少加密 trailer 的受损加密 PDF,现在会在保存前被拒绝,而不是被重写成一个看得到页数、却读不出内容的文件;无论 PDF 把加密条目放在哪个位置都能被识别,线性化文件与较大的交叉引用流也包括在内,这类文件不会再以未受保护的状态打开;渲染失败之后的恢复会保留原文档的加密,恢复出来的标签页继续保持原有权限,并能写回自己所属的文件。
最后那一句是整段说明里最关键的。文件改坏了,比文件打不开更难发现——它还在那儿,页数也对,只是内容空了。加密文档尤其容易走到这一步,因为加密结构一旦在重写过程中丢掉,剩下的页面就成了空壳。把「拒绝保存」放在「试着修好」前面,等于承认有些情况不该硬来。
涂黑之后,字是真的没了
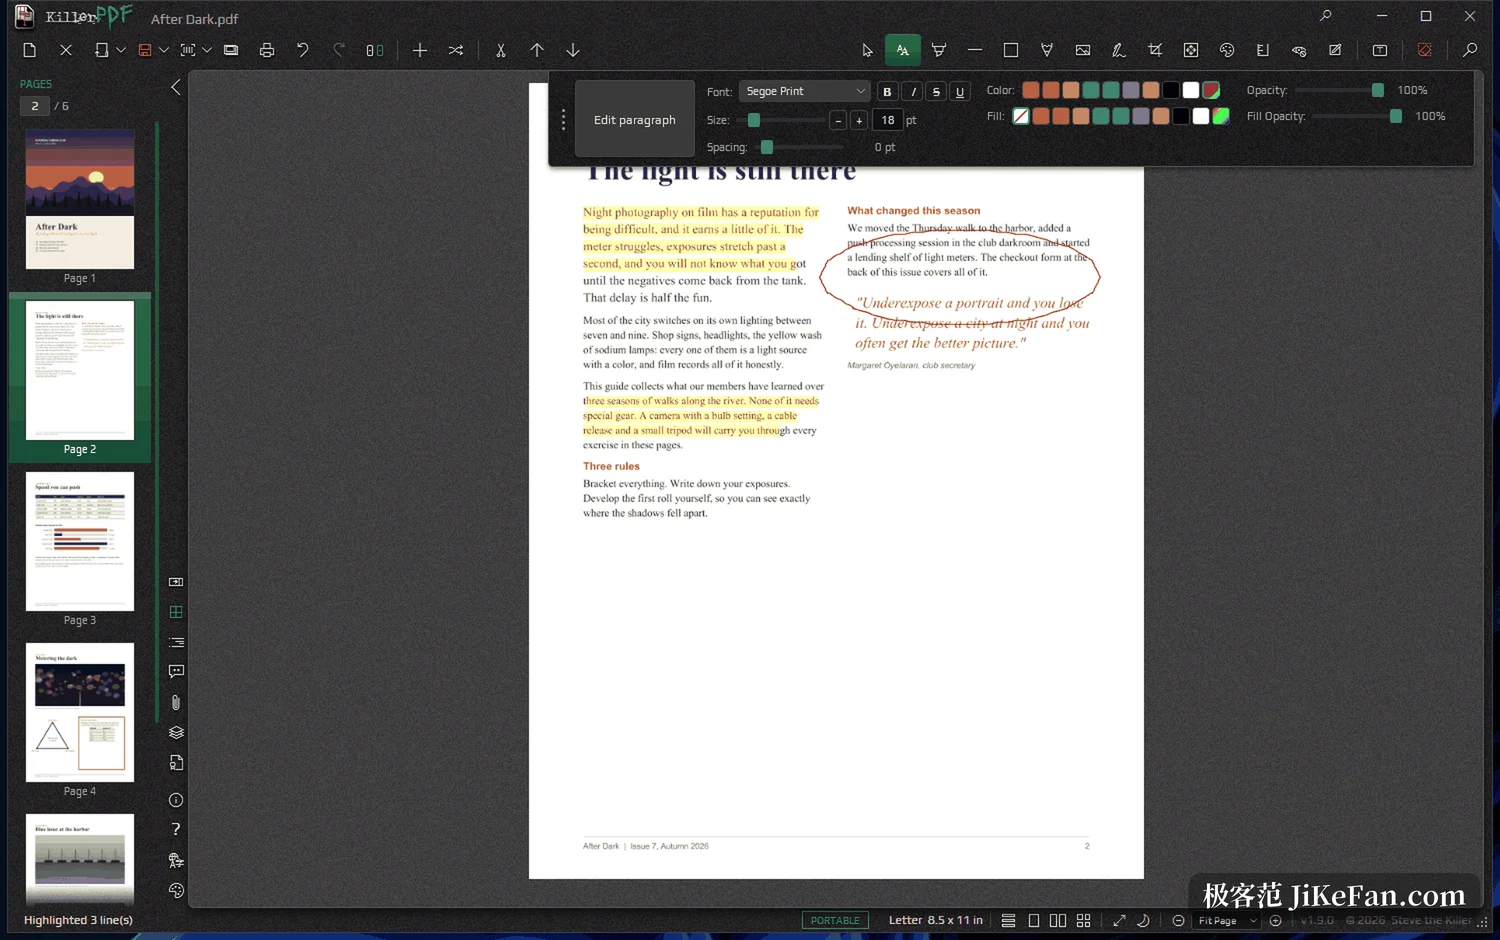
KillerPDF 的涂黑可以手绘圈出区域,可以按关键词搜索后批量标记,也可以按预设模式自动定位邮箱地址、电话号码、社会保障号、支付卡号与 IBAN 账号。它做的事情不是盖色块,而是把内容从页面里移除,表单字段里的文字与注释里的文字一并处理,保存之前会先校验一遍结果。
能区分工具好坏的地方在这里:把整页转成一张图片,涂黑当然有效,可文字层也一起没了,检索、复制、无障碍阅读全部失效。KillerPDF 把整页光栅化留作兜底,并且明确写了这一手绝不擅自执行。先真的删,删不干净再问人,这个顺序比结果本身更能说明态度。
1.9 把三个第三方 PDF 库换成了自己的引擎
从 1.8 起,KillerPDF 开始用自研的 KillerPDF.Engine 替掉旧的文档管线,1.9 把这件事做完了。现在渲染每一页、提取和选中每一个词、读取与校验、创建与编辑、签名与加密、写出文件,全部走同一个公开 API,其他应用调用它也是同一条路。PDFium、Docnet.Core 与 PdfPig 已经不在依赖清单里。
规模写在官网首页:145,562 行物理 C# 代码,8,508 个引擎测试,47,024 份语料 PDF。语料是开放且带版本的,真实文档、标准文档、畸形文件与刻意加压的文件混在一起,每个集合跑五次,记录里是零崩溃、零超时。换引擎的风险从来不在写代码,而在敢不敢让结果这样量一遍。愿意把测试规模和崩溃数摆在前页的项目,通常是心里有数的。
OCR 在本机跑,语言模型按需取
文字识别由 Tesseract 驱动,二十种语言全部在本机运行。每个模型包括英文在内,都是首次使用时才下载并留在本地缓存,所以基础安装包不必为用不到的语言付出体积。它有三种用法:对一页或拖出来的区域识别后直接进剪贴板,把扫描版 PDF 变成可搜索的文件,或者把扫描件里的字换成真正可编辑的文本,并把没认准的那几个词交给你复核。
把识别放到云端是最省事的做法,可合同、证件、体检报告这些东西,很多人卡在上传这一步就过不去。按需下载语言模型是个挺实际的折中,既不把包撑大,也不要求先联网才能开始用。
它没打算做成全能选手
KillerPDF 支持十三套主题,其中四套各能取八种强调色,合计四十一种外观,界面语言十几种。这些是加分项,真正需要提前知道的是几条边界。源码文本与段落编辑只在受支持的版式与字体下工作,扫描页得先做 OCR;导出的 Office 文件可能改变原有排版,分享之前要自己看一遍;签名报告会把校验失败的签名,与证据拿不到、尚未校验的情况分开列出,这个区分比一个「有效」标签负责得多。
官方对涂黑的描述没有留余地:把内容从页面本身移除,表单字段和注释里的文字也算在内;结果在保存之前会先验证,整页光栅化的兜底方案绝不擅自执行。1.9.2 修的则是另一头——受损的加密文件宁可拒绝保存,也不重写成一个读不出内容的壳。