
Umi-OCR 2.1.5:解压即用的离线文字识别,截图、批量与 PDF 都能读
摘要
Umi-OCR 把识别引擎放在本机,截图后能直接划选文字,批量图片与扫描版 PDF 都能转成可搜索的文本,还能用命令行和 HTTP 接口接进自己现有的流程里去。
推荐- 软件名称
- Umi-OCR
- 版本
- 2.1.5
- 收费
- 免费
- 开源
- 开源
- 操作系统
- WindowsLinux
- 更新时间
- 2026-11-14 23:00
扫描件、截图、别人发来的图片,里面明明有字,却只能一个字一个字敲进文档——这种活干过一次就记得。在线识别能省事,代价是把文件传给别人服务器;断网、涉密、或者只是嫌麻烦,这条路就走不通。Umi-OCR 换了个位置:识别引擎装在本机,不联网也能跑。它是一个用 Python 与 Qt 写的开源项目,MIT 协议,发布包解压即可使用,不必另装运行库。官方按系统分别出包,Windows 与 Linux 各有对应版本,界面语言也覆盖了十几种。
免费、开源、可批量的离线 OCR 软件——项目首页把自己的定位写得很克制,没有形容词,只列了三个属性。
截图之后,字就能划选
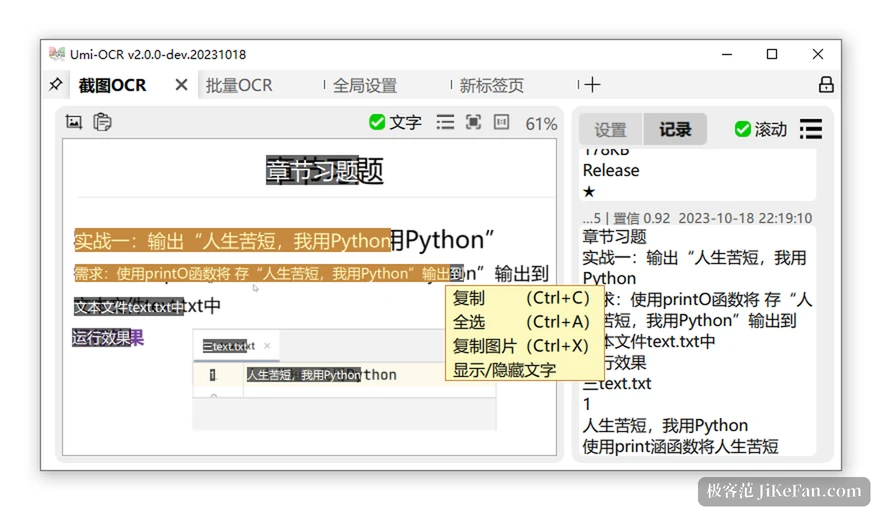
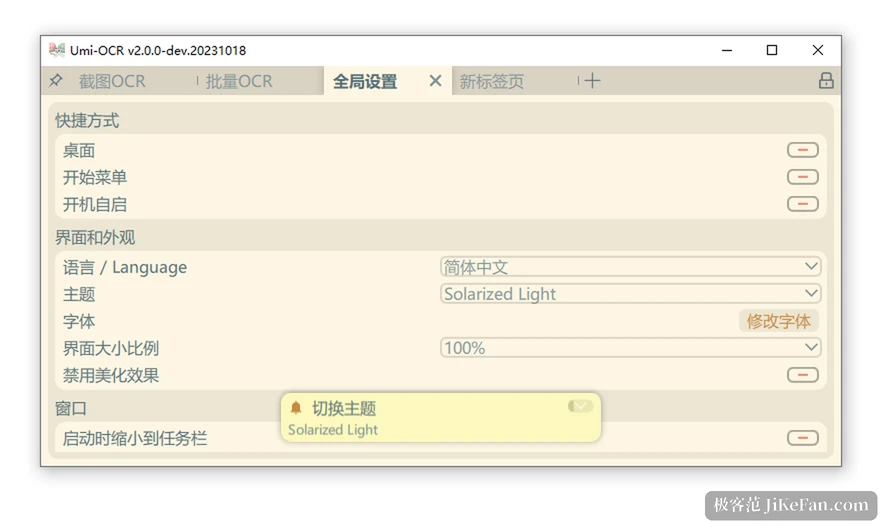
主界面是标签页结构,截图识别、批量识别、全局设置各占一页,可以再开新标签。截图页左边是刚抓下来的画面,右边一栏分设置与记录:识别完成后,左边的图里可以直接用鼠标划选文字,右边记录区按时间倒序列出每次结果,每条都标着置信度——0.92 这种数字算不上好看,但它诚实地告诉你这一行识别得把握有多大,需要人工复核的地方一眼能找到。2.1.5 之后多数标签页能切成左右或上下双栏,屏幕窄的时候把记录压到下方,图的显示面积能多出一截;按 Esc 直接隐藏主窗口,是给频繁截图的人留的快捷键。
排版解析:把乱序的方块排回人话
OCR 的原罪不是认错字,而是把两栏的段落按识别顺序堆成一锅粥。Umi-OCR 在文本后处理里放了排版解析,可以按多栏、单栏、单行几种方案重排识别结果,让输出的文字顺序贴近原文的阅读顺序。单栏单行方案还处理了另一种常见情况:两个相隔较远的文本块之间补一个空格,避免句子被粘连。这类细节不出现在功能列表里,但你复制一大段文字出来、发现不用再手动断句的时候,能感觉到差别。
批量那页,是一个小型流水线
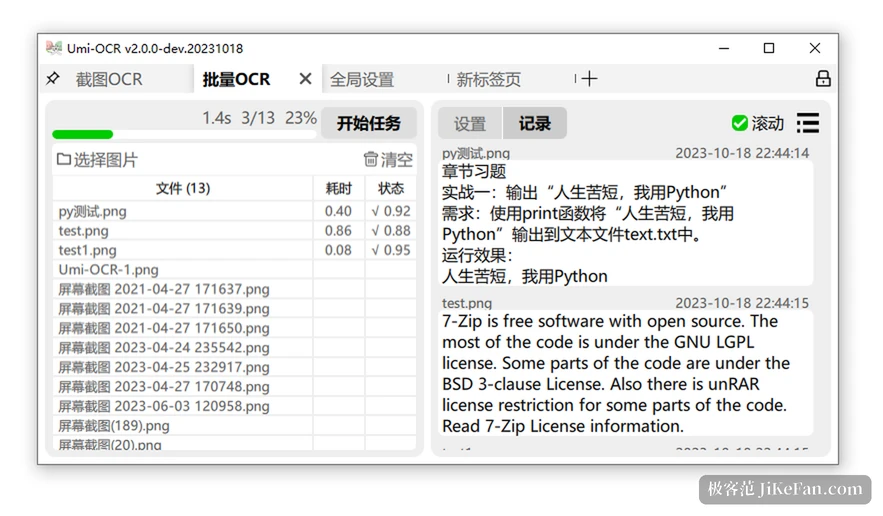
批量识别页左边是文件列表,每行给出文件名、耗时与状态,状态栏里那个勾后面跟着的同样是置信度;顶部一条进度条,跑起来会显示已完成张数与百分比。右边记录区按文件分组,点哪张图就看哪张的结果,往下滚能看到同一批里其他文件识别出来的正文。真正省时间的不是并发,而是可以一边跑一边翻——识别完的文件先进列表,不必等整批结束。2.1.5 把图片与文档的加载改成异步,几万个子文件的文件夹也能流畅展开,进度条跟着走。同一个页面还有忽略区域:框出一块矩形,那块里的文字就不参与识别,截图自带的角标、水印、时间戳可以被整片跳掉。
扫描版 PDF 也能读
文档识别处理的是 PDF:一类是扫描件,页面里根本没有文字层,只能靠识别补出来;另一类本身就带文本层,可以直接抽取,省掉识别的功夫。输出有两种去向,提取成纯文本,或者生成一份双层可搜索 PDF——原件样子不动,底下压一层看不见的文字,之后用阅读器搜索、复制都正常。2.1.5 修了两个与这相关的毛病:页面旋转时自带文本被漏掉,以及生成单层 PDF 时原文本没写进去。对需要归档的合同、说明书这类文件来说,这两处比新功能重要。
能给别的程序调用,才是它真正的用法
界面之外,它留了两个入口。命令行可以在启动时带指令,也能在运行时远程下达任务;HTTP 接口则把它变成一个本地服务,截图、图片、PDF 都能通过请求提交,返回结果里带每行的坐标与置信度。Linux 版本还能以容器方式跑起来,接在自己的流程里。2.1.5 补上的日志机制就是为这条路准备的:带命令行参数启动可以看到实时日志,指定级别以上的记录落到日志目录,排查一次识别失败不用再靠猜。2.1.5 还加了重新加载配置的指令,改完参数不必重启整个程序。
两个需要提前知道的边界
识别引擎是插件形式,发布时按引擎分成两个包:性能好的那个对 CPU 指令集有要求,奔腾、赛扬、凌动这类老处理器跑不起来,遇到初始化失败要换成兼容版。这不是缺陷,是推理框架本身的限制,项目文档里写得很直接。另一条边界是它只做识别,不做版面还原——表格识别出来是文字流,想要保结构得自己再排。界面语言覆盖了十几种,通过社区翻译平台维护,中文与英文都在里面。
把 Umi-OCR 2.1.5 放回使用场景里看,它解决的问题很窄:把图片和扫描件里的字,变成可以复制、可以搜索、可以喂给别的程序的文本,而且这个过程不出本机。截图划选、批量排队、忽略区域、双层 PDF、命令行与接口,这几件事凑在一起,够覆盖从偶尔用一次到接进自动化流程的全部距离。免费开源、不要账号、不联网,对需要处理敏感材料的场景来说,这三点本身就构成了选择理由。