
-
LocalAI:後端按需拉取,沒有顯卡也能先跑起來
一個執行檔、一套相容端點:把用戶端指過來,程式碼一行不動,模型就回到自己機器上。引擎只在真的需要時才拉下來,每個功能都有一條能在處理器上跑的路,再加一台機器就是更多容量。
-
vLLM:把顯示記憶體當記憶體來管,吞吐量翻幾倍
把鍵值快取切成區塊而不是整塊預留,記憶體利用率從三、四成拉到九成以上,同一張卡能同時服務兩到四倍的請求——這就是展示品與線上服務之間的差別。
-
AnythingLLM:把私有 AI 工作台裝進桌面,資料不出機
把 PDF、文書檔與表格拖進工作區,就得到一位讀過你全部資料的助手,每則回答都附引用;模型、向量庫與儲存預設全部跑在這台機器上。
-
llama.cpp:純處理器也能推理,本機部署的最後一道保險
以純 C 寫成、不帶任何依賴,它定下了讓量化模型小到能塞進普通筆電的檔案格式,也是好幾款熟悉桌面工具安靜踩著的那一層。
-
GPT4All:沒有顯卡也能在自己電腦上跑本機模型
不必獨立顯卡、不必帳號、不必碰終端:量化過的開放模型在普通處理器上就能跑,把一個資料夾指定為資料集合之後,跟自己的資料對話全程不出這台機器。
-
Jan:斷網照樣能對話的開源本機助手
對話視窗、模型管理、本機服務的每一行程式碼都攤在寬鬆的開放許可之下,於是網線拔掉照樣能聊,而隱私這件事不必靠信任,靠的是讀得到的原始碼。
-
Ollama:一行指令,把開源模型接進日常工作流
它是執行環境而不是聊天程式:一行指令就把開源模型拉下來跑起來,本機端點講的是通用請求格式,你手上任何腳本或編輯器外掛都能指向它,完全不必碰外網。
-
NextChat:五 MB 的客戶端,把你付費的模型全收進一個窗
約五 MB 的客戶端,把你本來就在付費的模型收進同一個視窗,對話留在瀏覽器本機,六個端都能跑;它自己不收錢,費用直接付給模型供應商。
-
Open WebUI:自架模型缺的那層介面,它補上了
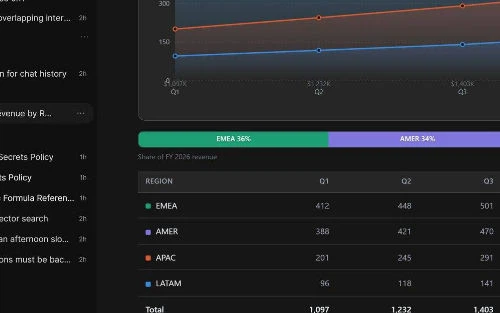
把它指向你原本就在跑的本機模型服務,或任何相容的 API,一個瀏覽器視窗就成了工作臺:多模型並排、文書知識庫、角色權限與單一簽入,必要時完全斷網也能跑完流程。
-
LibreChat:自己架一層對話介面,把模型帳單改成按用量計費
軟體免費、機器自備:一個視窗接上多家模型服務,不寫程式就能組出代理,還有隔離的程式執行環境與 MCP 連接,每個人的用量在後台看得見,不再糊成一筆固定訂閱。
-
Mistral Vibe:把工作與編碼併成一份訂閱,資料預設不出歐洲
一份訂閱同時涵蓋日常幹活與寫程式:先出計畫、再跨連接的工具執行,回答速度約每秒一千詞,資料預設託管在歐盟境內。
-
Kimi 換了一代:讀得進只是半套,做得完才是這回的重點
百萬字的資料丟進去,它自己拆任務、自己找人分工,最後交回來的是一份能直接用的成品。讀得進是上一代的事,做得完才是這一代真正想解決的事。
-
DeepSeek 的新模型:看圖不必先解釋,百萬字一次讀完,權重還開放出來
五千五百二十億參數的模型,不必先描述就能看懂你丟過去的截圖,一口氣吃得下一百萬 token,而快取命中的輸入價壓到每百萬 token 一元的五十分之一。真正值得看的不是體量,而是成本跑到哪裡去了:讀與寫現在走兩套不同的參數。
-
Cherry Studio:一個視窗放進多個模型,旁邊再放一座知識庫
Cherry Studio 是一套跨平台的 AI 對話與知識庫桌面工具:同一個問題可以並排問多個模型,自己的材料放進本地知識庫,繪圖與翻譯就在同一個視窗裡。
-
第 1 / 1 页