
Strata 0.2.10:8 GB 显卡也能开 128K 上下文,本地跑 Qwen3.8 更快了
摘要
Strata 0.2.10 把默认推测解码器换成只占 625MB 的 DFlash2,八 GB 显存显卡可开 128K 上下文,Linux 双卡全卡切分让代码编辑解码速度接近翻倍。
推荐- 软件名称
- Strata
- 版本
- 0.2.10
- 收费
- 免费
- 开源
- 开源
- 操作系统
- WindowsmacOSLinux
- 更新时间
- 2026-11-03 23:00
本地跑大模型最难受的两件事,一件是显存不够长上下文开不起来,一件是速度慢到没法干活。Strata 0.2.10 这一版同时在两头动了刀:把默认的推测解码器换成一个只有六百多兆的小家伙,又让八 GB 显存的卡也能把上下文开到 128K。
这一版改了什么
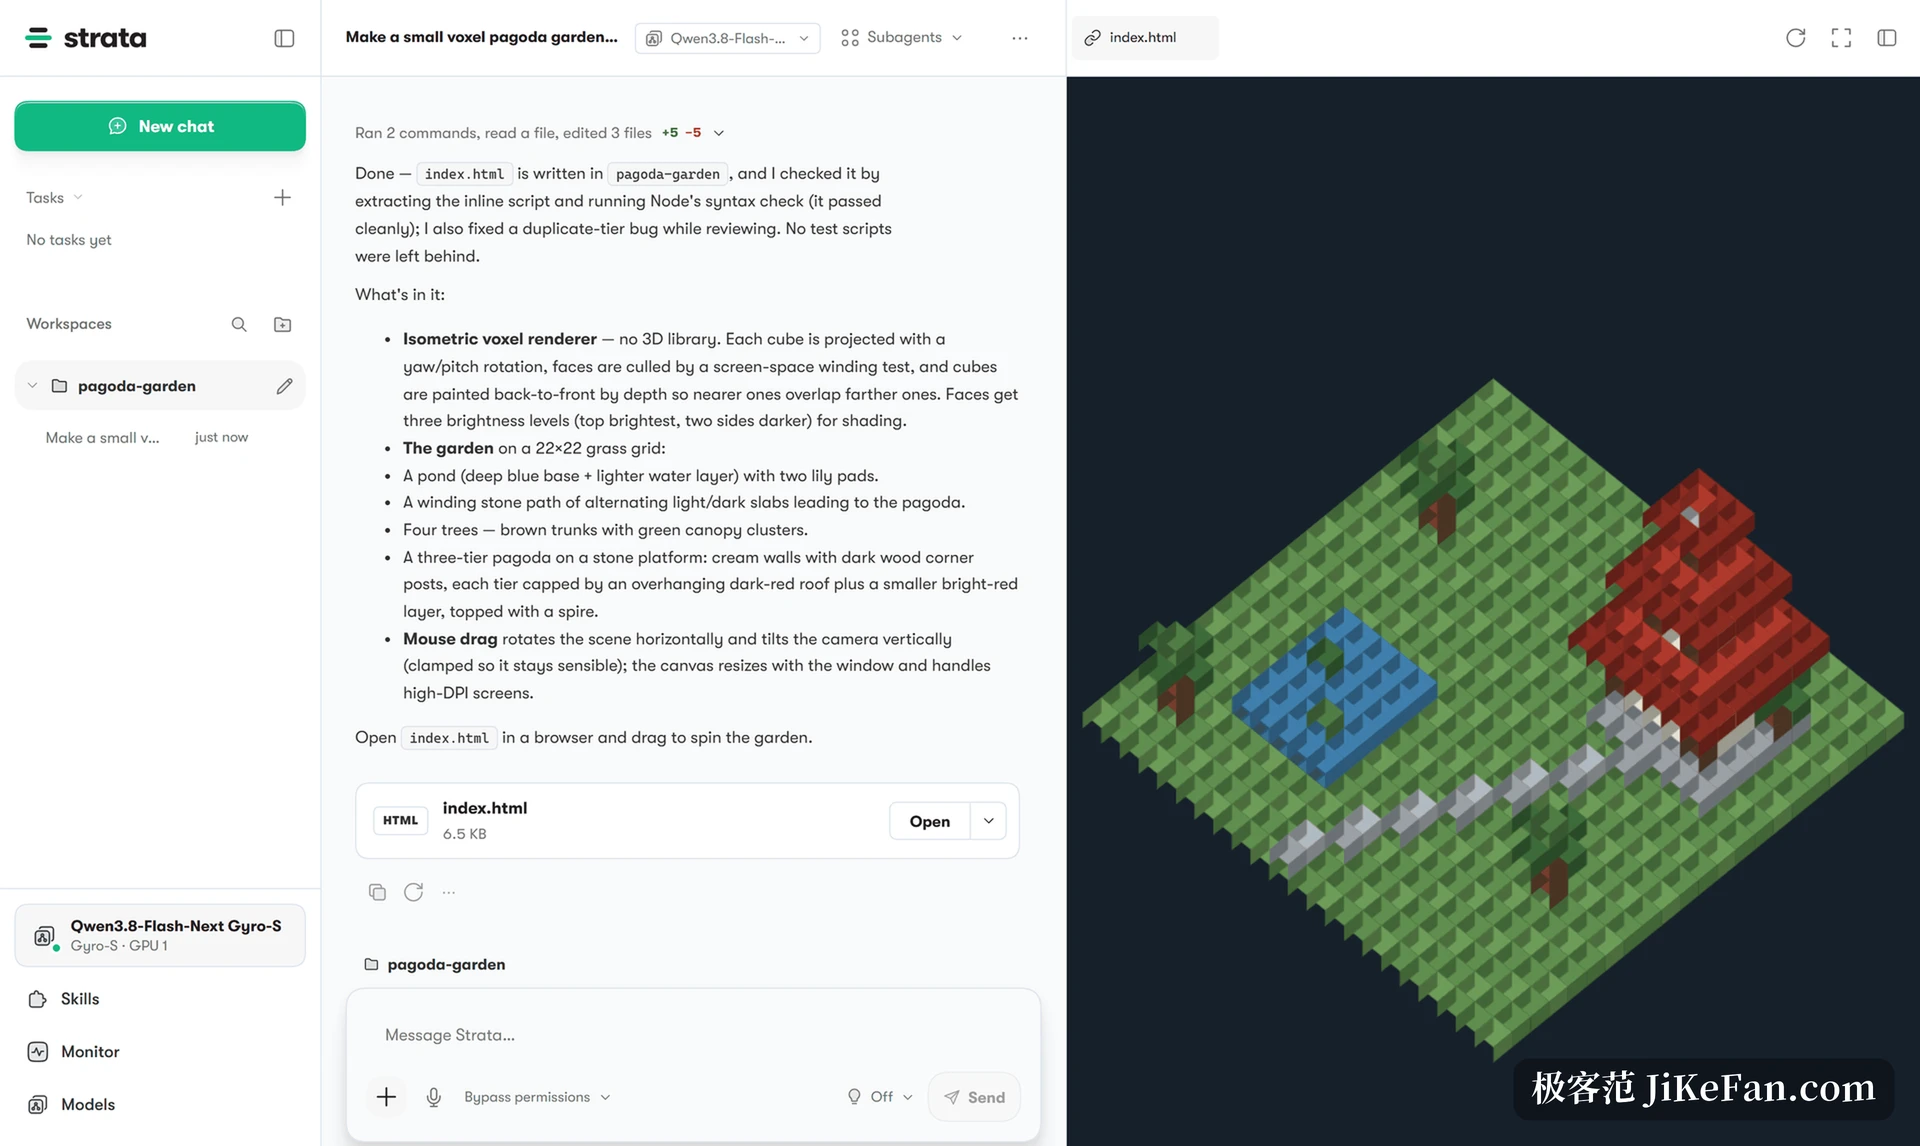
Strata 是一个跑在自己电脑上的大模型客户端,用 C++ 写成,MIT 许可,代码托管在 GitHub 上,目前有近四万颗星。它的定位很明确:给消费级硬件用,桌面应用和终端两条入口,装完选个模型就能开始聊天、写代码、读图片,不注册账号,也不经过任何服务器。
0.2.10 这个版本的编号需要说清楚:应用与终端都是 0.2.10,控制组件和各个引擎包是 0.1.56。官方在发布说明里把这次的重点列得很直白——DFlash2 成为默认草稿器、Linux 上多卡全卡切分引擎自动启用、新增 ISTA-DAS Coder 模型、Mac 上能读图、八 GB 显卡起步支持 128K 上下文。
用六百兆换掉五吉的推测层
推测解码这件事,思路是让一个体积很小的辅助模型先猜接下来会说什么,再交给主模型批量核对,猜对得多就省下了逐字生成的时间。Strata 上一版用的推测层叫 MTP,占显存大约五点二 GB;这一版换成 DFlash2,只占六百二十五兆左右,一来一去省下的空间差不多有四个多 GB。
省下来的显存直接变成了可用上下文。官方给出的对比是:同一套引擎和文件,在 Ryzen AI Max 的 Windows 机器上,短回答的生成速度提升一成二、长回答提升八点八;RTX PRO 5000 上按贪心解码算提升七点九;Apple M5 Max 提升七点四;DGX Spark 提升五点八。也有反例,Intel Arc A750 上比 MTP 慢二点六,官方如实写了。
代价是并发。DFlash2 一次只处理一个请求,要同时跑多个请求就得切回 MTP,模型家族不是 Qwen3.8 时也一样。这套自动选择逻辑写进了程序里:选自动就按硬件和场景挑,选错了也能手动指定,每次运行只加载一个草稿器,不会两个一起上。
八 GB 显存怎么塞进 128K
长上下文吃的是缓存。以前在八 GB 的卡上开 64K 甚至更高,专家缓存一满就直接启动失败,用户只能退回四十八 K 左右。这一版改了资源分配方式:显存紧张时动态调整显存和内存之间的数据摆放,尽量保住用户设定的上下文长度,必要时把一部分缓存摊到系统内存甚至固态硬盘上。
实测数字是这样的:把测试机限制成八 GB 卡的条件,跑 Qwen3.8 的 IQ3_S 量化版本开 128K,DFlash2 模式生成速度六十三到七十三 Token 每秒,读一个三十二 K 的提示用了十九点八秒,此时显存还剩三百九十兆。换成真实存在的 Intel Arc A750 八 GB 卡,四种 128K 启动组合全部成功,速度十二点七到十四点八 Token 每秒。十二 GB 的卡不受影响,速度维持原样。
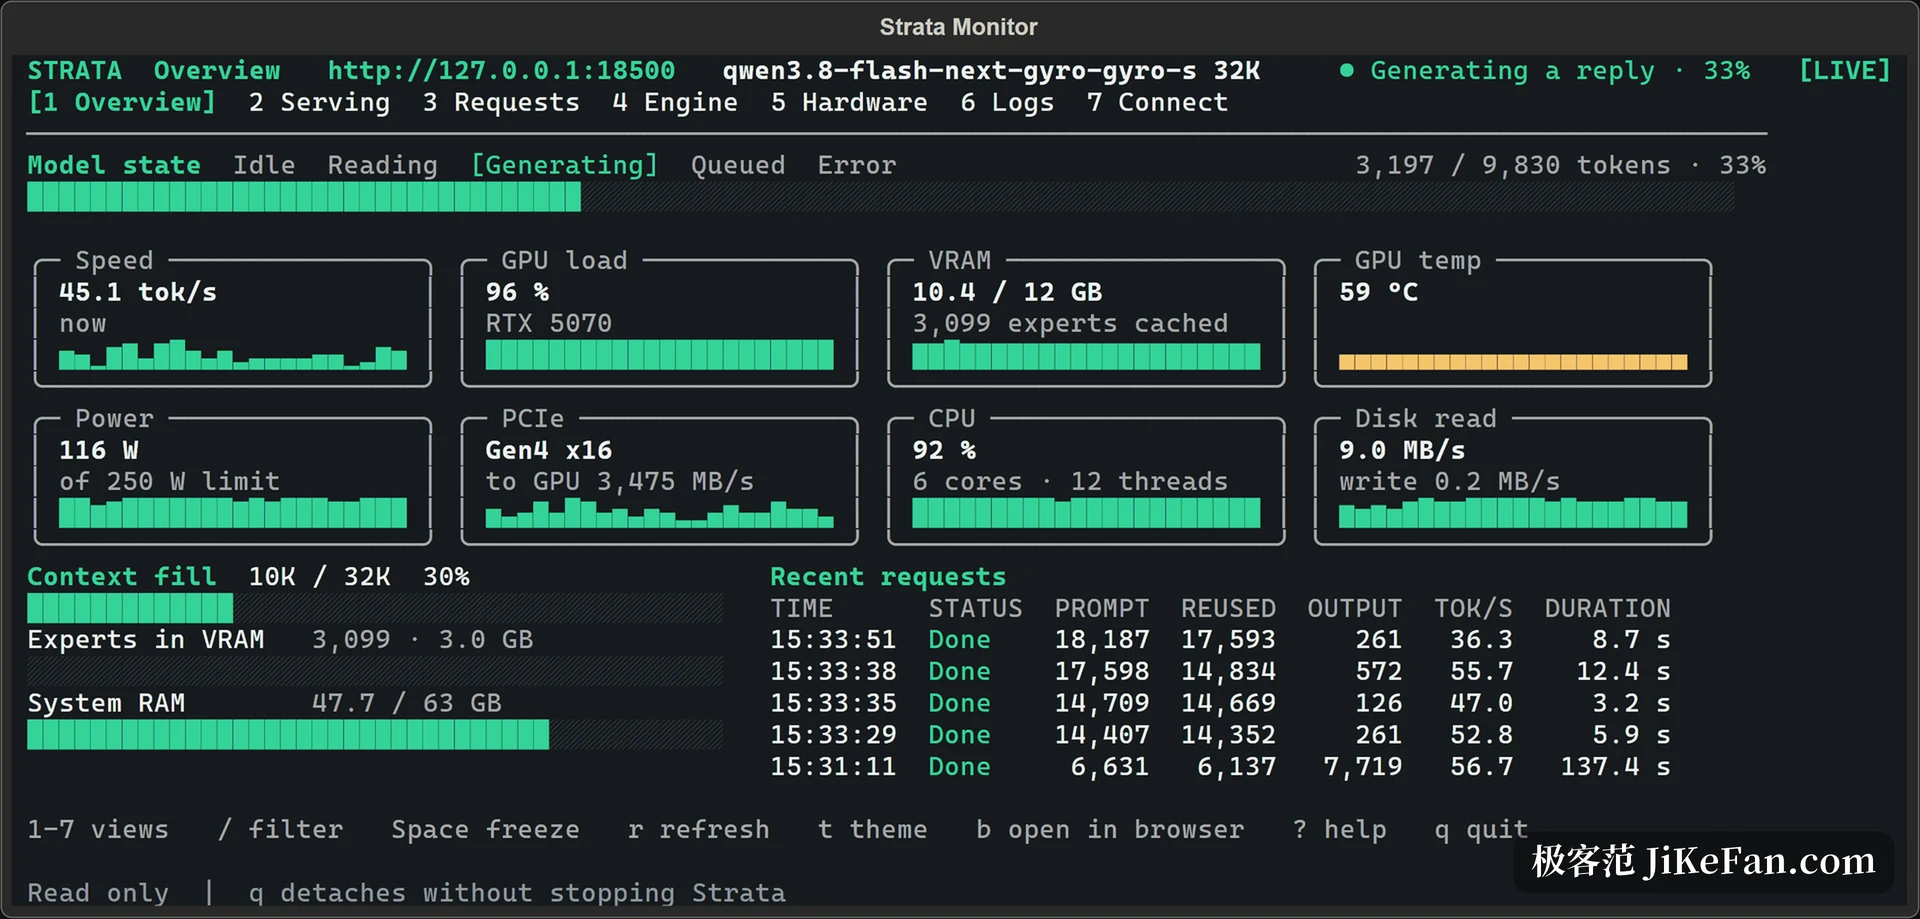
这条路不是没有门槛。显存压力被内存和硬盘分走之后,对整机内存的要求就上来了,社区里的经验值是三十二 GB 起步、四十八 GB 刚好、六十四 GB 才算从容。硬盘也得留出空间,模型文件本身就不小。
两张卡一起跑,代码编辑接近翻倍
多卡的老办法是分层切:每张卡负责模型的一部分层,算完再把结果传给下一张。这一版在 Linux 的终端里默认启用了另一种切法,叫全卡切分——每张卡都持有每一层的一部分,所有卡同时读权重、同时算。好处是显存被更均匀地摊开,坏处是卡之间要频繁交换中间结果,对互联带宽有要求。
官方用两张 RTX A6000 在 Linux 下测了这组对比:代码编辑从一百九十五 Token 每秒涨到三百七十七到三百九十四,写新代码从一百三十九到一百四十四涨到一百八十九到二百三十二,普通文本从九十三涨到一百三十九到一百四十六,跑智能体循环从一百一十二到一百一十九涨到一百六十五。读长提示反而略慢一点,三十二 K 的提示从七点六五秒变成十点一秒,算是用首字延迟换吞吐。
自动启用有严格条件:必须是 Linux,必须是两张计算能力 8.6 或 12.0 的 NVIDIA 卡,或者四张 Radeon AI PRO R9700 配特定量化文件,模型得是引擎能吃下的 Qwen3.8,所有路由专家都要装进显存,还要留出约四十三 GB 空闲内存。条件不满足就老老实实回到分层切,程序会说明原因,也可以手动关掉。
顺手补上的两处
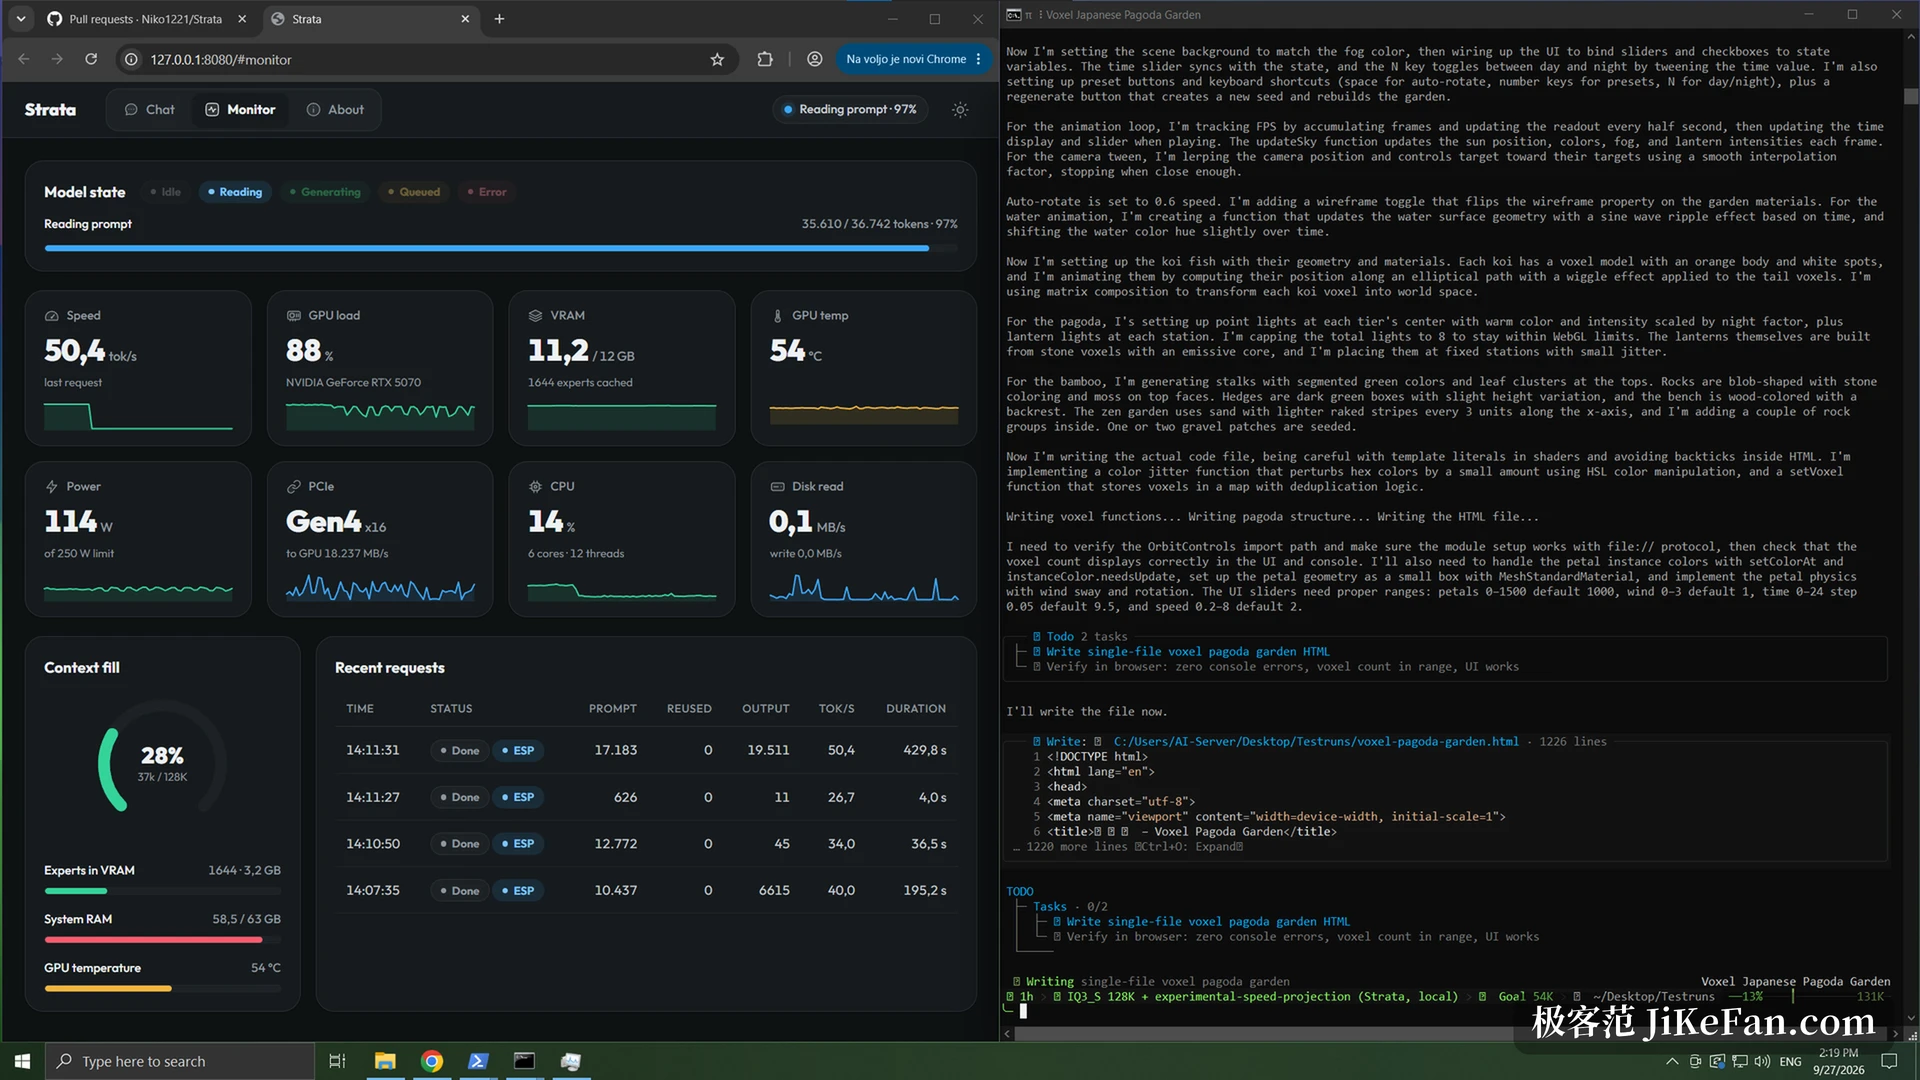
一是 Windows 上的启动体验。某些后台启动场景下,磁盘读取优先级被压得很低,模型加载会明显变慢,这一版把这个优先级调了回来。二是 Mac 上的图片输入:在 M5 Max 上八次图片请求八次读对,带图生成十九到二十二 Token 每秒,纯文本是二十一到二十二,图片塔额外占三百一十九兆显存,而引擎的内存峰值仍是七十四 GB,与纯文本时持平。
另外新增的 ISTA-DAS Coder 用的是 DeepSeek-V4.1-Flash 的三百八十四专家里每层取一百九十二个的配置,在四张 R9700 上解码五十九点二 Token 每秒,单卡二十二点八,Apple M5 Max 上十九点一到二十二点五。这些数字都出自官方发布说明,取自不同机器,横向比较意义有限,看个量级就行。
谁该更新
手上有八 GB 到十二 GB 消费级显卡、又想用长上下文的人,这一版值得换,因为它把原来根本开不起来的场景变成了能跑。双卡用户如果正好在 Linux 上跑 Qwen3.8,全卡切分的收益相当直接。至于只有一张大显存卡、平时也就聊聊天的人,升级后能感到的差别主要是首次启动会多下载约一点二 GB 的草稿器文件。
需要提醒的是,这类项目迭代很快,版本号一天一个也是常事,官方文档里对硬件、量化档位和并发设置写得相当细,动手之前值得对着自己的配置读一遍,别直接照抄别人的参数。