
Scrapling 0.5.1:把整站抓成 Markdown,还给 AI 一副浏览器
摘要
Scrapling 是开源的 Python 网页抓取框架,整页和整站都能转成干净 Markdown,页面改版后元素能自己找回,0.5.1 版补上了远程会话与拖拽。
推荐- 软件名称
- Scrapling
- 版本
- 0.5.1
- 收费
- 免费
- 开源
- 开源
- 操作系统
- WindowsmacOSLinux
- 更新时间
- 2026-11-10 20:25
Scrapling 是一个用 Python 写的网页抓取框架,把发请求、开浏览器、解析页面、整站采集和导出放进同一个库。11 月 4 日发布的 0.5.1 版干了两件事:把浏览器会话开放给外部程序接管,让智能体学会看动效和拖拽;顺手把「整站转成干净 Markdown」这条路修得更顺。需要给自己攒语料、或者想让 AI 自己去读公开网页的人,值得花十分钟了解它。Windows、macOS 与 Linux 上都能跑。
先把网页洗成 Markdown,再交给模型
大模型读原始 HTML 吃亏。导航栏、脚本、样式、广告位全在里面,真正有用的正文夹在中间,按字数计费的时候,这些噪声照样付钱。Scrapling 的减法做在转换阶段:调用 markdown() 之后,脚本、样式、隐藏元素一律清空,页面上用 CSS 藏起来的白字、标了 aria-hidden 的区块、HTML 注释和零宽字符也一并剔除。
这一步不经过任何大模型,纯本地字符串处理,抓一万页也不产生模型费用。省下的不只是钱。喂进去的语料干净,下游切块的质量才稳,检索出来的片段不会带着半屏菜单项。
整站转 Markdown 有现成模板。设好允许的域名、指定正文选择器、给一个页数上限,跑完得到一个文件夹的 .md 文件,外加一份 JSONL,每条记录带来源、标题和正文,可以直接倒进知识库。文档站、博客、产品手册这类结构规整的站点,用它整理语料最省事。
元素带指纹,页面改版不用重写选择器
抓取脚本最脆的地方是选择器。站点换一套 CSS 类名,昨天还能跑的代码今天就返回空列表,一层层翻日志才发现是类名变了。Scrapling 的自适应元素追踪换了个思路:第一次定位时把元素的位置、属性、文本特征记成指纹,页面结构变动之后,它按相似度重新找那个「换了位置但还是同一个东西」的节点。
配套的相似元素匹配对付另一个常见场景。一页几十张结构相同的卡片,要挑出特定的那一个,先找到参照元素,再按结构相似度往外扩,比手写 nth-child 稳。
一次请求和一整个站,写法是同一套
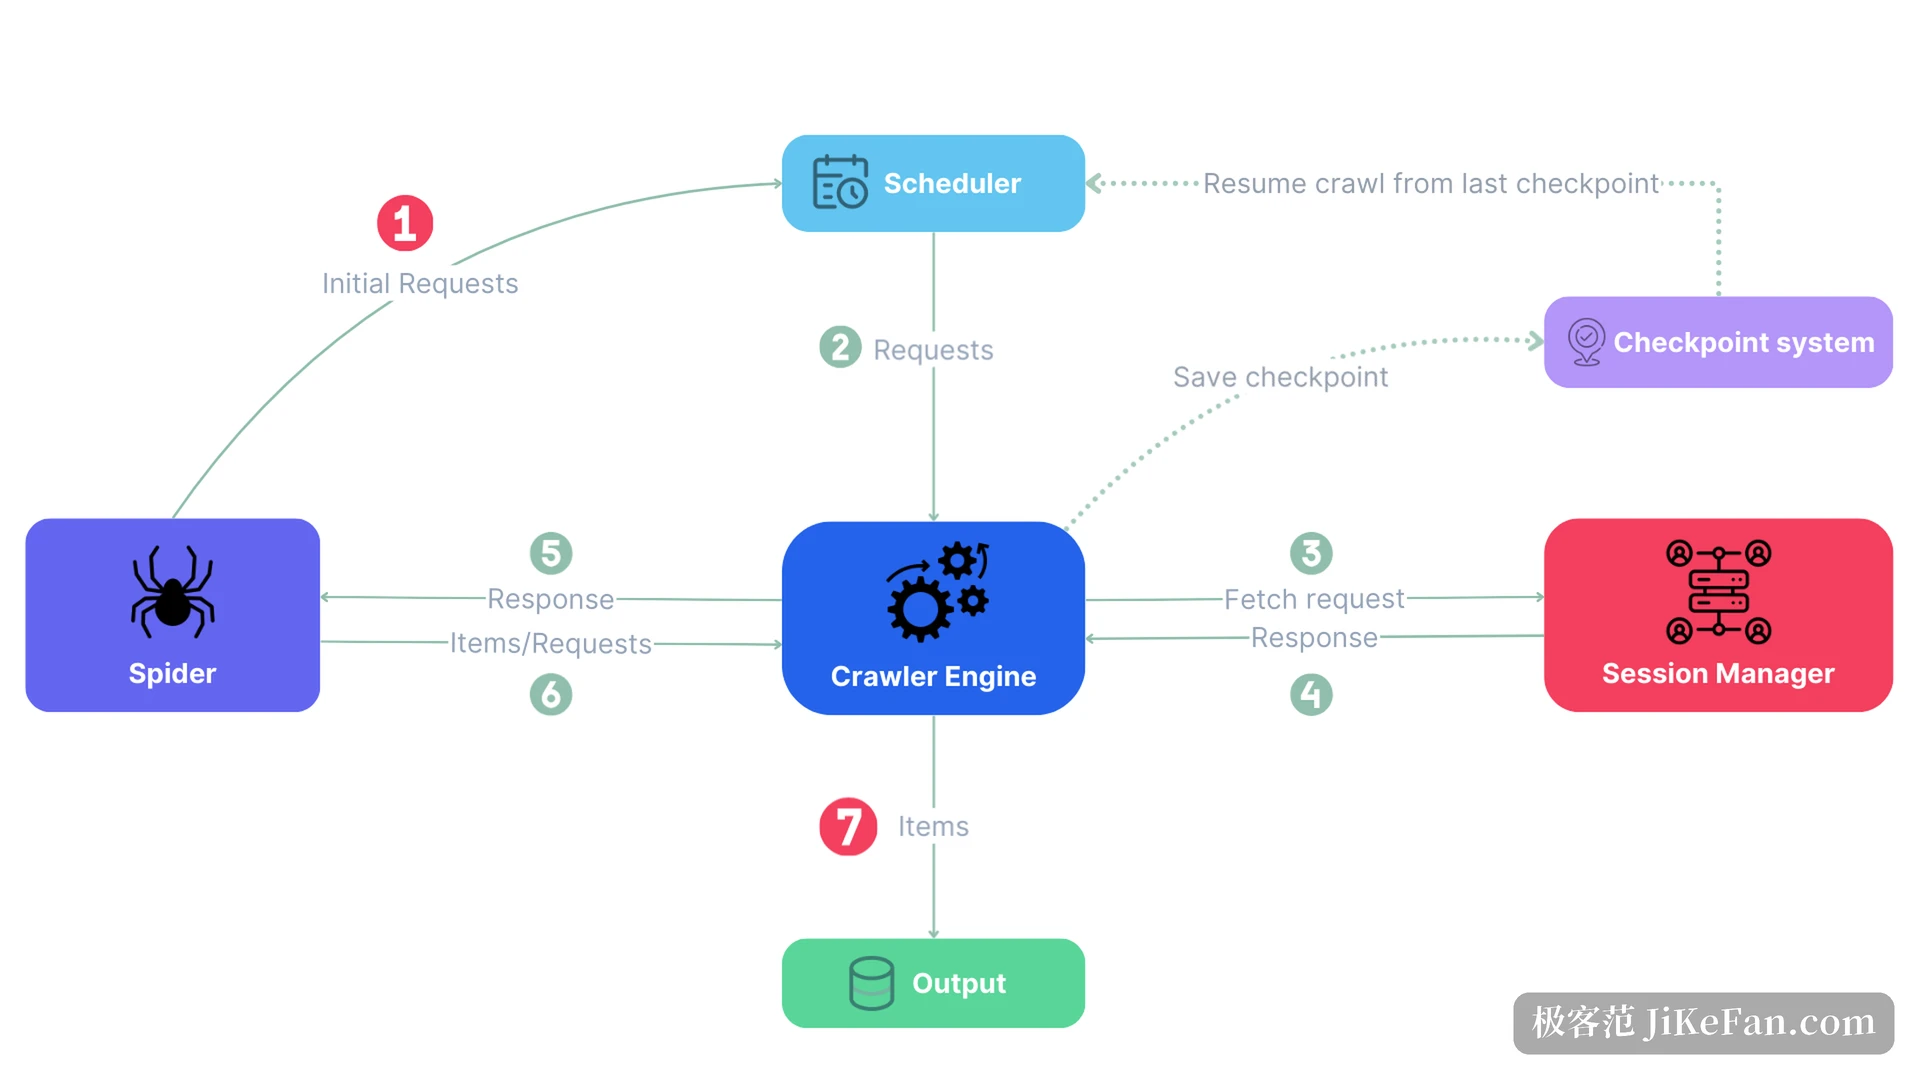
- Fetcher
- 发普通 HTTP 请求,带上与真实浏览器一致的 TLS 指纹和请求头,静态页、公开接口够用
- 浏览器类抓取器
- 用 Playwright 驱动 Chromium 渲染,等 JavaScript 执行完再取内容,也能挂在已经开着的浏览器上
- Spider
- 并发采集,自动限速,按 Ctrl+C 存下进度、下次接着跑,结果导出成 JSON、JSONL、CSV 或 XML
三种抓法共用同一套解析接口。同一份选择器代码,换一个 fetcher 就能从静态页搬到动态页,不必为了渲染 JavaScript 另起一套写法。页面背后那些 XHR 请求也能录下来,接口返回的数据往往比渲染后的 HTML 更规整。
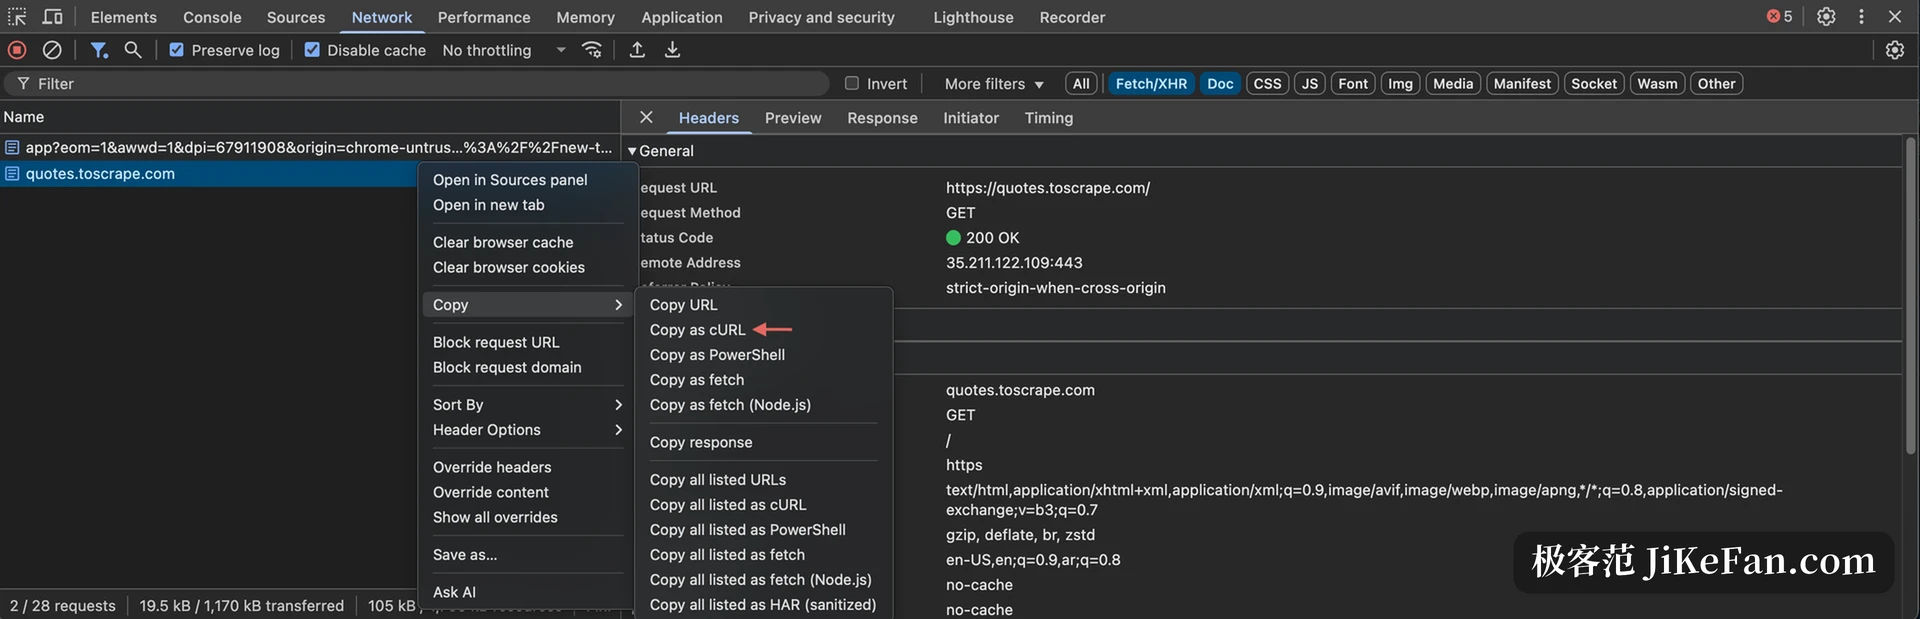
还有一个顺手的小细节。平时在浏览器里调试接口,右键「复制为 cURL」能得到一条完整的请求;这条命令贴进 Scrapling 的交互式 shell,会自动转成可复用的采集语句,先跑通,再改写进脚本。省掉了从零拼请求头那一遍。
0.5.1 补上的三个口子
| 版本 | 时间 | 主要变化 |
|---|---|---|
| 0.5 | 2026-10-17 | MCP 服务器补齐完整浏览器流程,新增网络请求录制与登录状态存取,支持开放的 Shadow DOM,爬取可选广度或深度优先 |
| 0.5.1 | 2026-11-04 | 新增远程会话类,可直接接管已在运行的 Chromium;智能体能看动效、能按住鼠标拖放 |
远程会话这一项,意义在把浏览器和采集进程拆开。它通过 CDP 端点连上一台已经开着的 Chromium,默认复用原有上下文,登录态直接继承,断开会话时已开的标签页还留在那里。以前要带着登录信息跑采集,只能在脚本里反复存取状态文件。
动效和拖拽是给智能体准备的。单张截图只记录一瞬间,动画、滚动之后的位置变化、滑块这类控件,静态图看不出前因后果。0.5.1 让它按一组连续画面理解页面在动什么,也能按住鼠标、移动、中途停下来检查、再松开。工具描述同时做了压缩,同样的能力占掉更少的上下文预算。
给智能体的入口不止一个
MCP 服务器负责动手。打开页面、点击、填表、滚动、截图、读接口响应都做成了工具,客户端接上之后,一句「把这一页的参数整理成表格」就能跑完。Agent 技能负责另一件事:它是一份随版本更新的手册,编码助手写 Scrapling 代码时按需查阅,省得凭旧记忆拼错接口。命令行和交互式 shell 是第三条路,适合先把一次请求跑通,再落回脚本。
这三条路对应三种人。做数据管道的人多半只用 Python 接口;习惯在终端里试错的人喜欢 shell;把采集交给智能体的人,碰的是 MCP。
边界还是那条边界
能力越强,越要先想清楚抓什么。公开文档、公开报价、公开发布的政策文件,属于常规用途。对方站点明确写了不许自动访问,或者内容要登录才看得到,那就别碰。Scrapling 的 Spider 可以选择遵守 robots.txt,也支持按域名限定范围,把采集留在目标站内,不跑偏。频率同样值得克制,一天一两次足够看清变化,没必要把对方服务器当成压力测试的对象。
Scrapling 0.5.1 的价值不在「能抓」,而在「抓完还能直接用」:网页进它就变成干净的 Markdown,元素换了位置它自己认回来,智能体也能接手操作。整套东西开源、可本地跑,代价是它终究是个需要写代码的工具,指望开箱即用的人会失望。真正吃得上这份便利的,是已经在自建知识库,或者正在给智能体搭取数链路的人。