
Auto-Ontology:先给数据立一本词典,再让 AI 报数
摘要
Auto-Ontology 是 NVIDIA 开源的语义层工具,先从数据库里长出业务词典,再让智能体照词典回答,每个答案都附上 SQL 与执行步骤,可以逐条核对。
推荐- 软件名称
- Auto-Ontology
- 版本
- 0.1
- 收费
- 免费
- 开源
- 开源
- 操作系统
- LinuxWeb
- 更新时间
- 2026-11-10 20:25
Auto-Ontology 是 NVIDIA 开源的一套语义层工具,用来自动从数据库里长出一份「业务词典」,再让智能体照着这份词典回答问题。它解决的是问数场景最常见的那种翻车:模型把「营收」理解成另一列,SQL 跑得通,数字却是错的。需要用自然语言查业务库、又不敢直接相信模型输出的团队,可以看看它怎么把这一步变成可校验的流程。项目以 Apache 2.0 协议开放,前端是网页界面,后端跑在容器里,配一个模型接口就能起来。
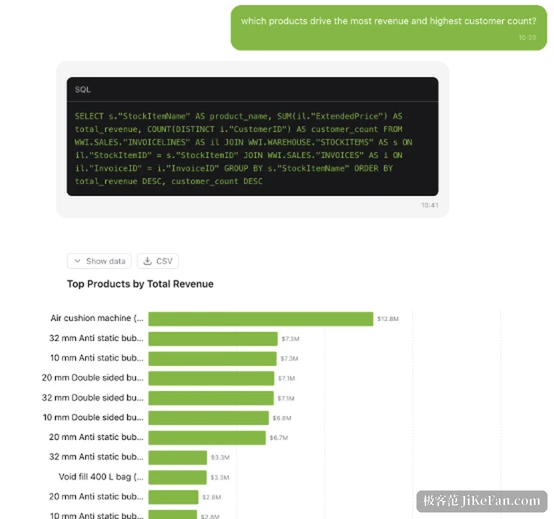
问数这件事,缺的是一本词典
把自然语言翻成 SQL,技术上早就能做。难的是含义。同一个「客户数」,在订单表里数是下单过的账号,在客户表里数是建档过的公司;「营收」可能含税也可能不含税,可能是已开票金额也可能是应收。模型不知道你们公司按哪个口径算,它只会挑一个看起来合理的列。
Auto-Ontology 的思路是先补上这层上下文:数据在哪、叫什么、能不能用、该怎么用、从哪来、哪些跟它相似。这些信息平时散在数据字典、SQL 脚本和老员工脑子里,它做的事是把它们收进一个可以查询的结构里,再交给智能体。
词典里装三类东西
- 术语
- 业务概念,如「客户」「发票行」,带描述与同义词,映射到具体列
- SQL 属性
- 挂在术语下、经人审核的 SQL 表达式,如毛利率;智能体复用同一种算法
- 关系
- 表之间怎么连,含桥表,从键与数据结构推断
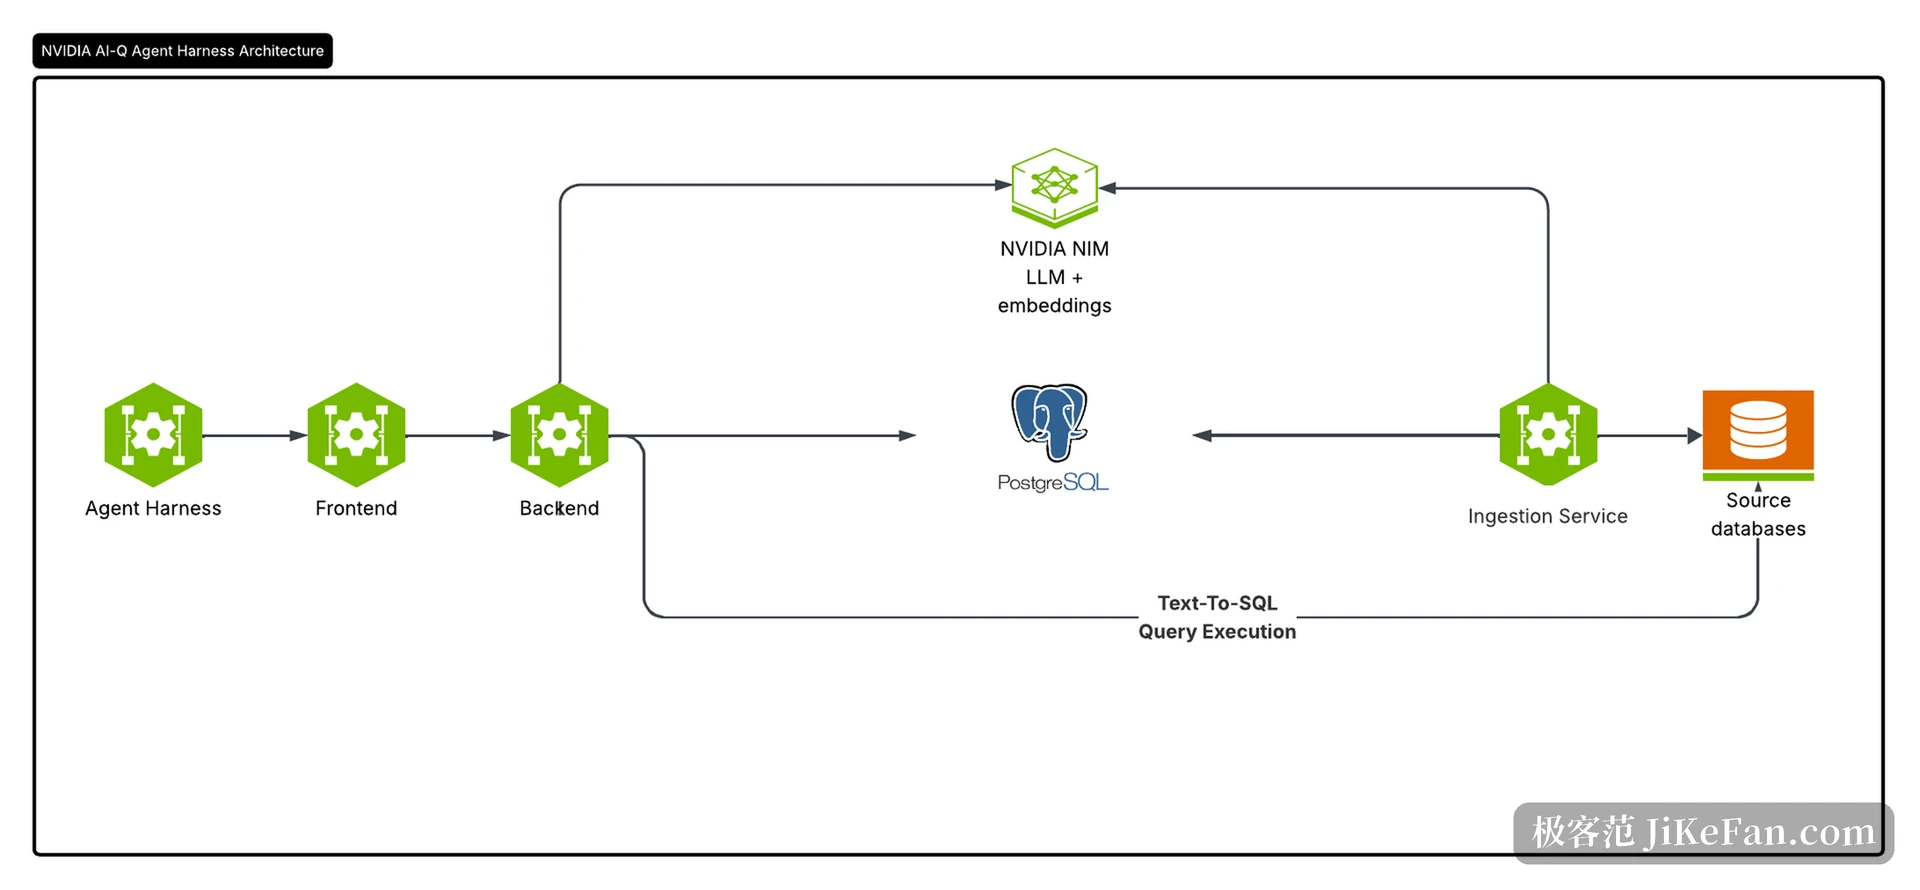
生成过程分四步:读源库,抽取模式、给列做画像、采样值;逐表抽取术语并映射到列;推断表之间的连接关系,并从历史查询里建议 SQL 属性;最后把术语、关系、属性写进 Postgres,同时把向量存进 pgvector 供检索。
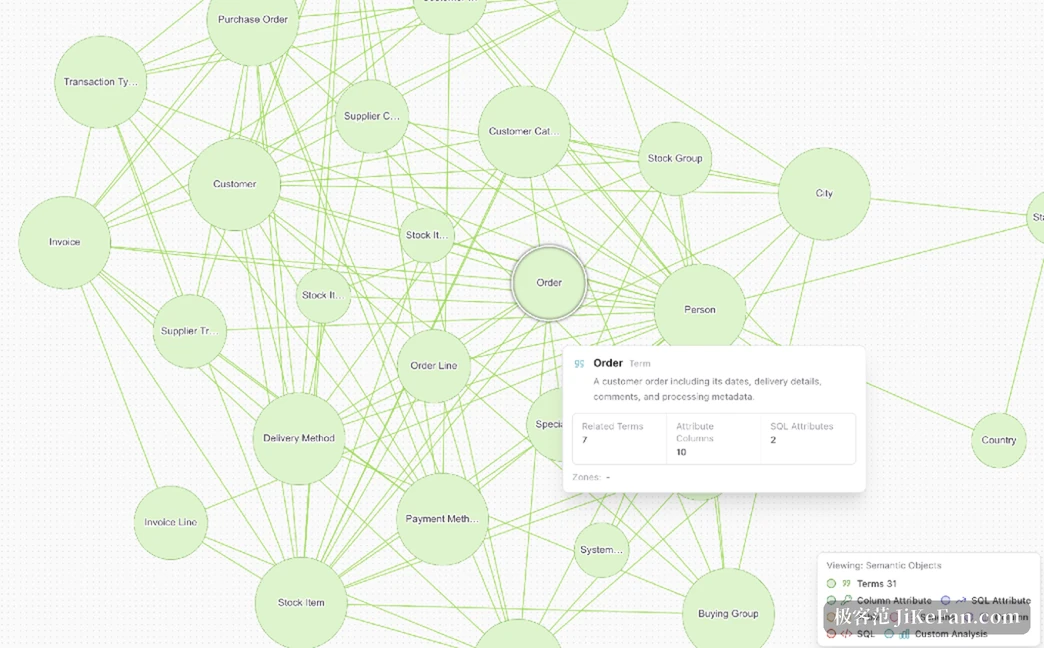
跑完之后,你在界面上看到的是一张可以点开的语义图。官方给的样例用的是微软那套 Wide World Importers 示例销售库,一次编译产出 31 个术语,选中「订单」,右侧会列出它的描述、关联术语、映射到的列和 2 条 SQL 属性。数字不大,但足够说明这套结构长什么样。
机器起草,人签字
自动生成的东西不能直接用。项目把「认证」做成了独立环节:你先在对话里拿真实问题试,或者通过 MCP 调检查工具;发现术语描述不对、SQL 属性算错,就在界面上改;改完再逐个认证。只有认证过的名称、描述和算式,才会被当成可信定义参与后续回答。
这一步看着笨,其实是整件事的关键。语义层的价值不在于自动生成得多快,而在于每条定义背后有人负责。认证状态就是这个负责的标记。
报数时多走一步校验
回答一个问题的流程有五步:判断意图、抽出问题里的实体;用向量检索找出候选术语、列、属性;据此写 SQL;把过滤值和整条查询拿去数据库里试,不通过就修;最后执行,并把答案、SQL 和执行步骤一起返回。
第四步是它跟普通问数工具拉开距离的地方。很多工具写完 SQL 就直接跑,跑出空结果或者离谱数字也照发。这里会先验证「宾夕法尼亚州」这类过滤值在库里到底存不存在、写法对不对,查询本身也先试一遍。
还有一层是拒答。官方样例里问「某产品 2015 年 6 月的广告投放回报」,样例库没有广告数据,覆盖度只有 0.5,它不会硬编一个数,而是回一句「这份数据里没有广告花费,要不要改看那个月的营收,或者广告数据存在别的库里」。这种回答比一个看起来精确的错数字有用得多。
接进智能体,走 MCP
项目自带一个基于 FastMCP 的服务器,对外只提供只读工具:查部署是否就绪、搜术语、取术语的列和 SQL 属性、判断某个问题在现有本体里能不能答、以及直接提问拿回答案与数据行。每次调用按登录用户的权限执行,不是一把万能钥匙。
它同时支持 Apache Ossie 这个语义模型交换标准,能导入导出 YAML。也就是说,你已有的语义模型不必推倒重来,两边可以互转——这一点对已经有数据仓库治理体系的团队比较友好。
代价和适用面
它不是装完就能用的那种工具。部署走 Docker Compose 或 Helm,需要一套 Postgres 17,还需要接上 NVIDIA 的模型接口(托管版或自建都行),推理与向量化都从那里走。默认配置里连模型都是预置好的,换模型要改环境变量。
适合的场景很明确:库多、口径乱、又想让业务方自己问数。先把一两个核心库接进来,编译一遍本体,人工认证几十个术语,再放开给智能体用,这条路径是通的。不适合的场景同样明确:只有一个库、字段名本身就清楚的小团队,这套东西的维护成本会超过收益。
Auto-Ontology 值得关注的地方,不是它能把问题翻成 SQL,而是它承认「模型不知道你们公司的口径」,于是先把口径做成人能审、机器能查的一层。数字对不对,最终仍要人点头;它做的是让点头这件事有地方落笔。