
GPU 显存被谁吃了?gputaskman 0.4.0 把每一兆都算清楚
摘要
gputaskman 是一款开源的终端系统监控工具,把 GPU 显存按进程拆开,还能把本地大模型的权重、KV 缓存与计算缓冲区分别报出来,新版补上了 Intel 与昇腾。
推荐- 软件名称
- gputaskman
- 版本
- 0.4
- 收费
- 免费
- 开源
- 开源
- 操作系统
- WindowsLinuxmacOS
- 更新时间
- 2026-11-11 23:00
任务管理器里那行显存数字,通常只有一个总数:已用多少、还剩多少。可这十几 GB 里哪一块属于浏览器、哪一块属于本地跑的大模型、哪一块被驱动和内核悄悄占住,界面上没有任何交代。gputaskman 就是冲这个空白做的一款终端系统监控工具,上中下三块界面分别给整卡读数、逐进程显存和选中进程的构成明细。0.4.0 版在 2026 年 11 月 11 日发布,把 Linux 下 Intel 整卡的负载、视频与功耗读数补了进来,也接上了华为昇腾 NPU 后端。
一条进程一行,先把显存归到名字上
界面沿用的是终端进程监控器那一套排布,一行一个 PID,列名成排往下拉,用起来和 htop 看 CPU 的习惯差不多。gputaskman 换掉的是统计口径:它不回答「显卡满了没有」,而是把显卡当成一份被瓜分的资源逐项记账。仓库截图里那张 16 GB 的 RTX 4080 SUPER 已用 5.01 GB,顶部彩条把这点空间切成了几段——桌面合成器 2.18 GB、LLM 1.31 GB、浏览器 977 MB、AI 进程 599 MB、应用 399 MB、系统 181 MB、内核 4 MB,另外还有 10.98 GB 空闲、1.56 GB 被标记为共享内存。
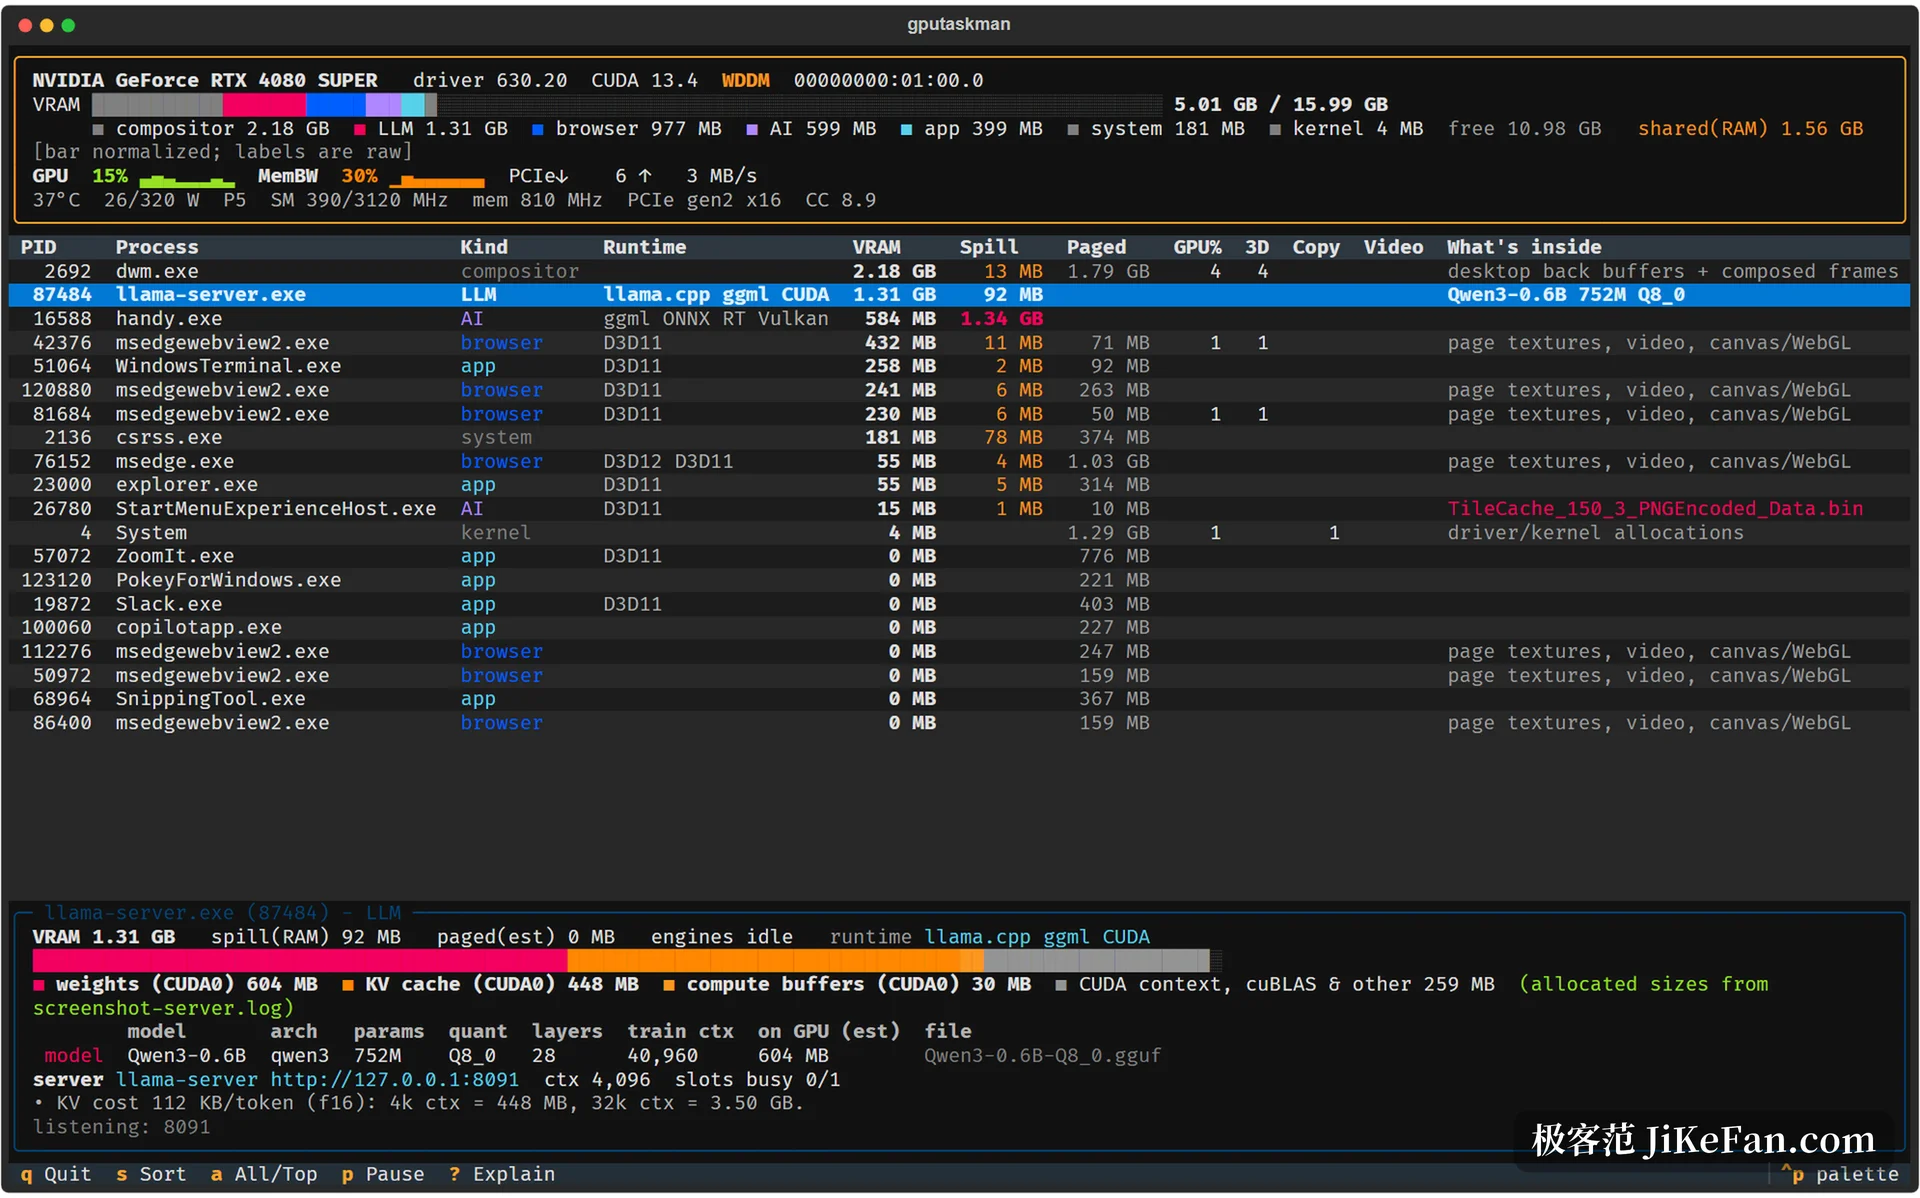
进程表里每一行都摆了 VRAM、Spill、Paged 三列显存数字,后面跟 GPU%、3D、Copy、Video 四列引擎负载,最右侧一列写明这个进程在干什么,比如「桌面后端缓冲与合成帧」「页面纹理、视频、canvas 与 WebGL」。想把显存让出来的人,看的就是这几列:谁拿了大头,谁只是碰了一下显卡。
权重、KV 缓存、计算缓冲区,各占多少
本地跑模型的人最需要下面那块详情面板。选中 llama-server 那一行后,gputaskman 报出模型名 Qwen3-0.6B、架构 qwen3、参数量 752M、量化 Q8_0、28 层、训练上下文 40960,模型文件 604 MB,然后把这 1.31 GB 显存拆成四份:权重 604 MB、KV 缓存 448 MB、计算缓冲区 30 MB,剩下 259 MB 归给 CUDA 上下文与 cuBLAS 一类的固定开销。
这四份里最容易被忽略的是 KV 缓存。它按每个 token 112 kB 记账,4k 上下文吃掉 448 MB,换到 32k 上下文就是 3.50 GB——同一个模型、同一个量化,只因为上下文长度不同,显存账单差了近 7 倍。很多人以为「只是开了个 0.6B 的小模型」,实际被这块按最大上下文预留的缓存占去一大截,gputaskman 把它单列出来才看得清。
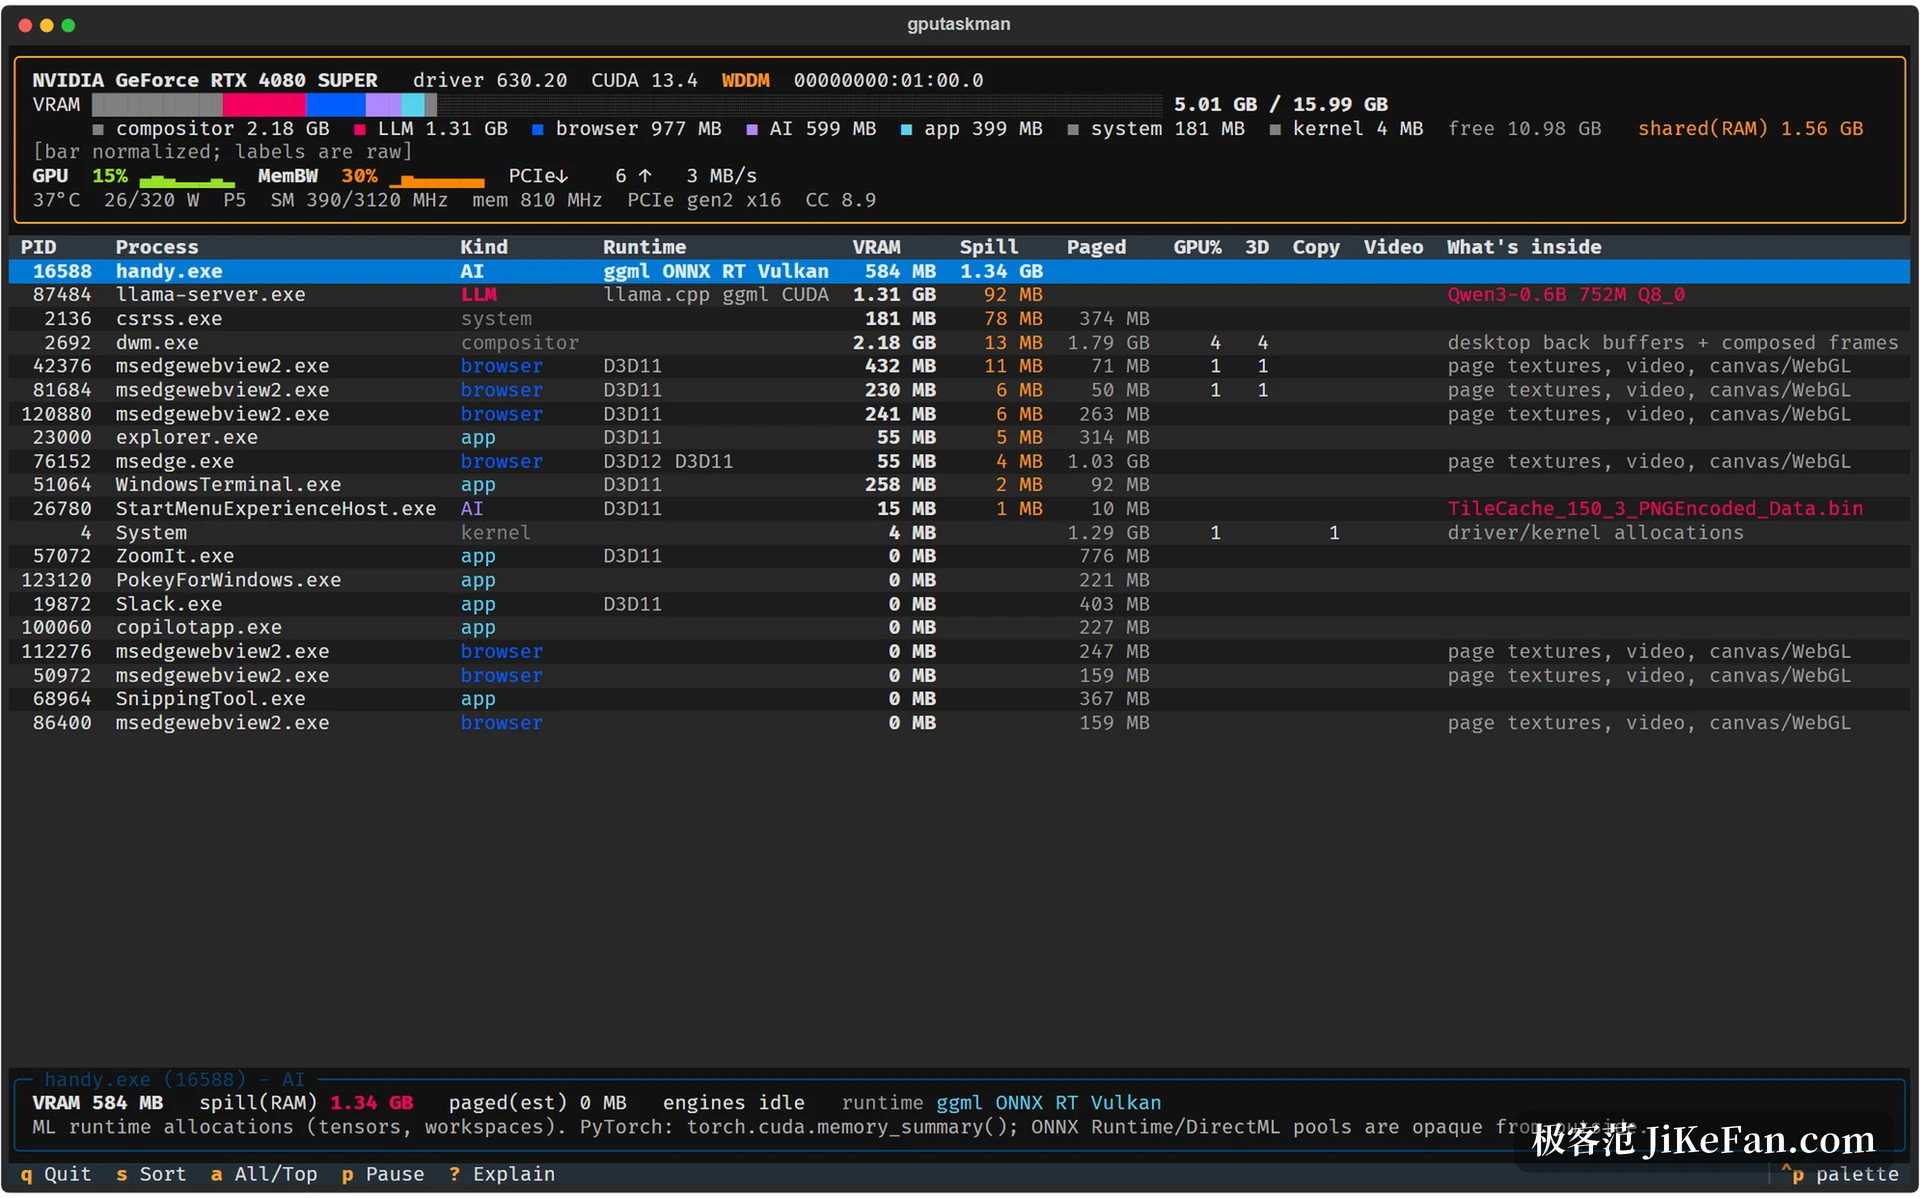
进程表里的 Spill 一列则指向另一种浪费。它记的是分给了 GPU、物理上却落在系统内存里的那部分,显卡够不着本地显存,只能通过总线来回搬。截图里 handy 这个进程占 1.34 GB Spill,比它占用的 584 MB 显存还多;这种状态一旦出现,推理速度会忽然往下掉一大截,而总数看起来纹丝不动。
哪些数字是量出来的,哪些是算出来的
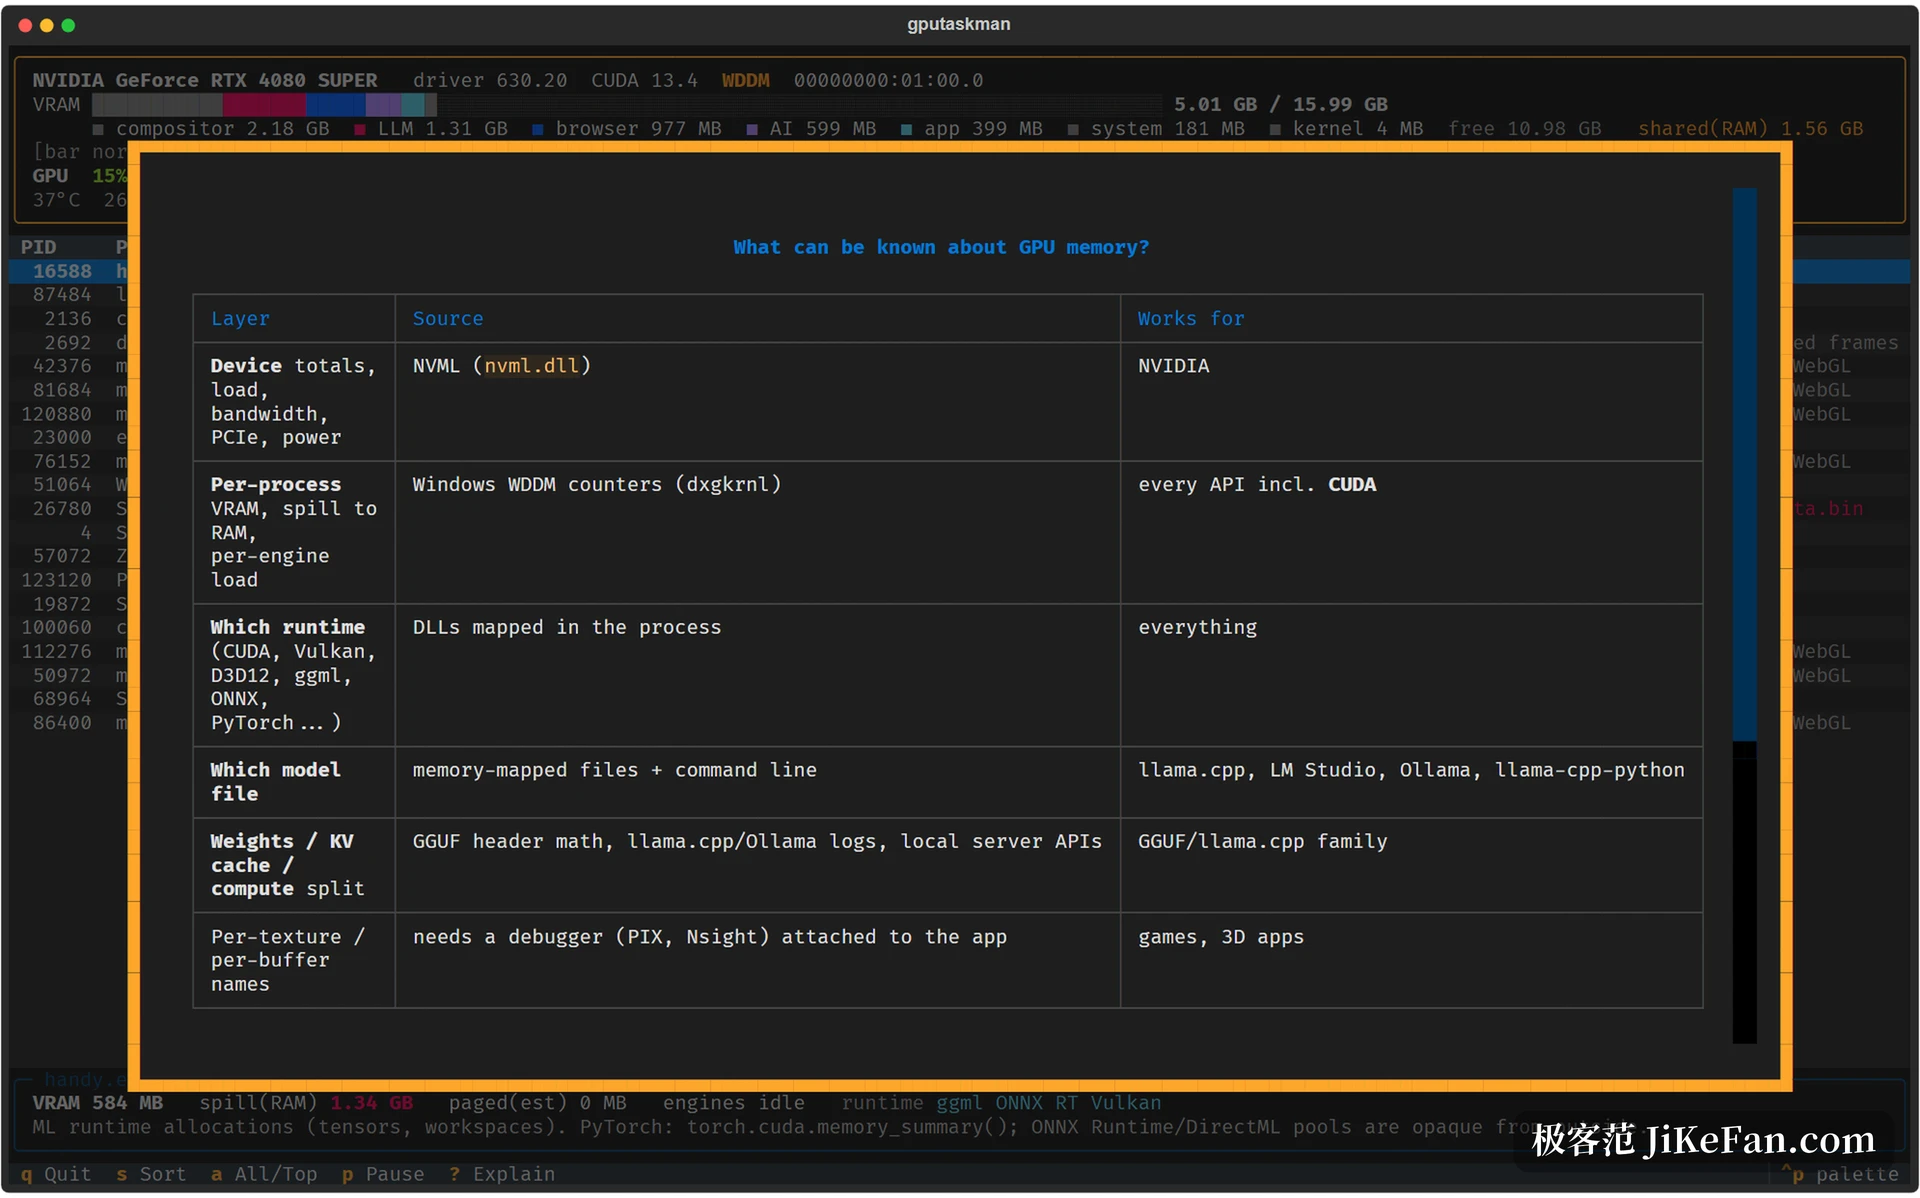
工具的可信度不在于能不能显示,而在于它敢不敢说自己哪部分在猜。gputaskman 的说明面板把数据来源分成六层摆开。最上面一层是设备的显存总量、负载、带宽、PCIe 与功耗,由驱动接口提供,因此只覆盖对应厂商的卡。第二层是逐进程显存、溢出到系统内存的那部分和单引擎负载,取自操作系统的显卡调度计数器,对所有图形接口都成立。
再往下是判断进程在用哪套运行时——CUDA、Vulkan、D3D12、ggml、ONNX 还是 PyTorch,依据是它加载了哪些动态库;模型文件认的是哪一份,则靠内存映射和命令行参数推断。权重与 KV 缓存的拆分来自模型文件头部结构、推理框架启动日志和本地服务接口。至于每张纹理、每个缓冲区叫什么名字,得等调试器挂上去,普通运行状态下拿不到。
这个分层直接决定了三个列名的含义,仓库文档把它们写得很直白:
- VRAM
- 进程真正压在显卡本地显存上的字节数,来自计数器,属于实测。
- Spill
- 显卡能够访问、但实际落在系统内存里的部分。它是「可达」不是「已溢出」,不能当成显存不够的铁证。
- Paged
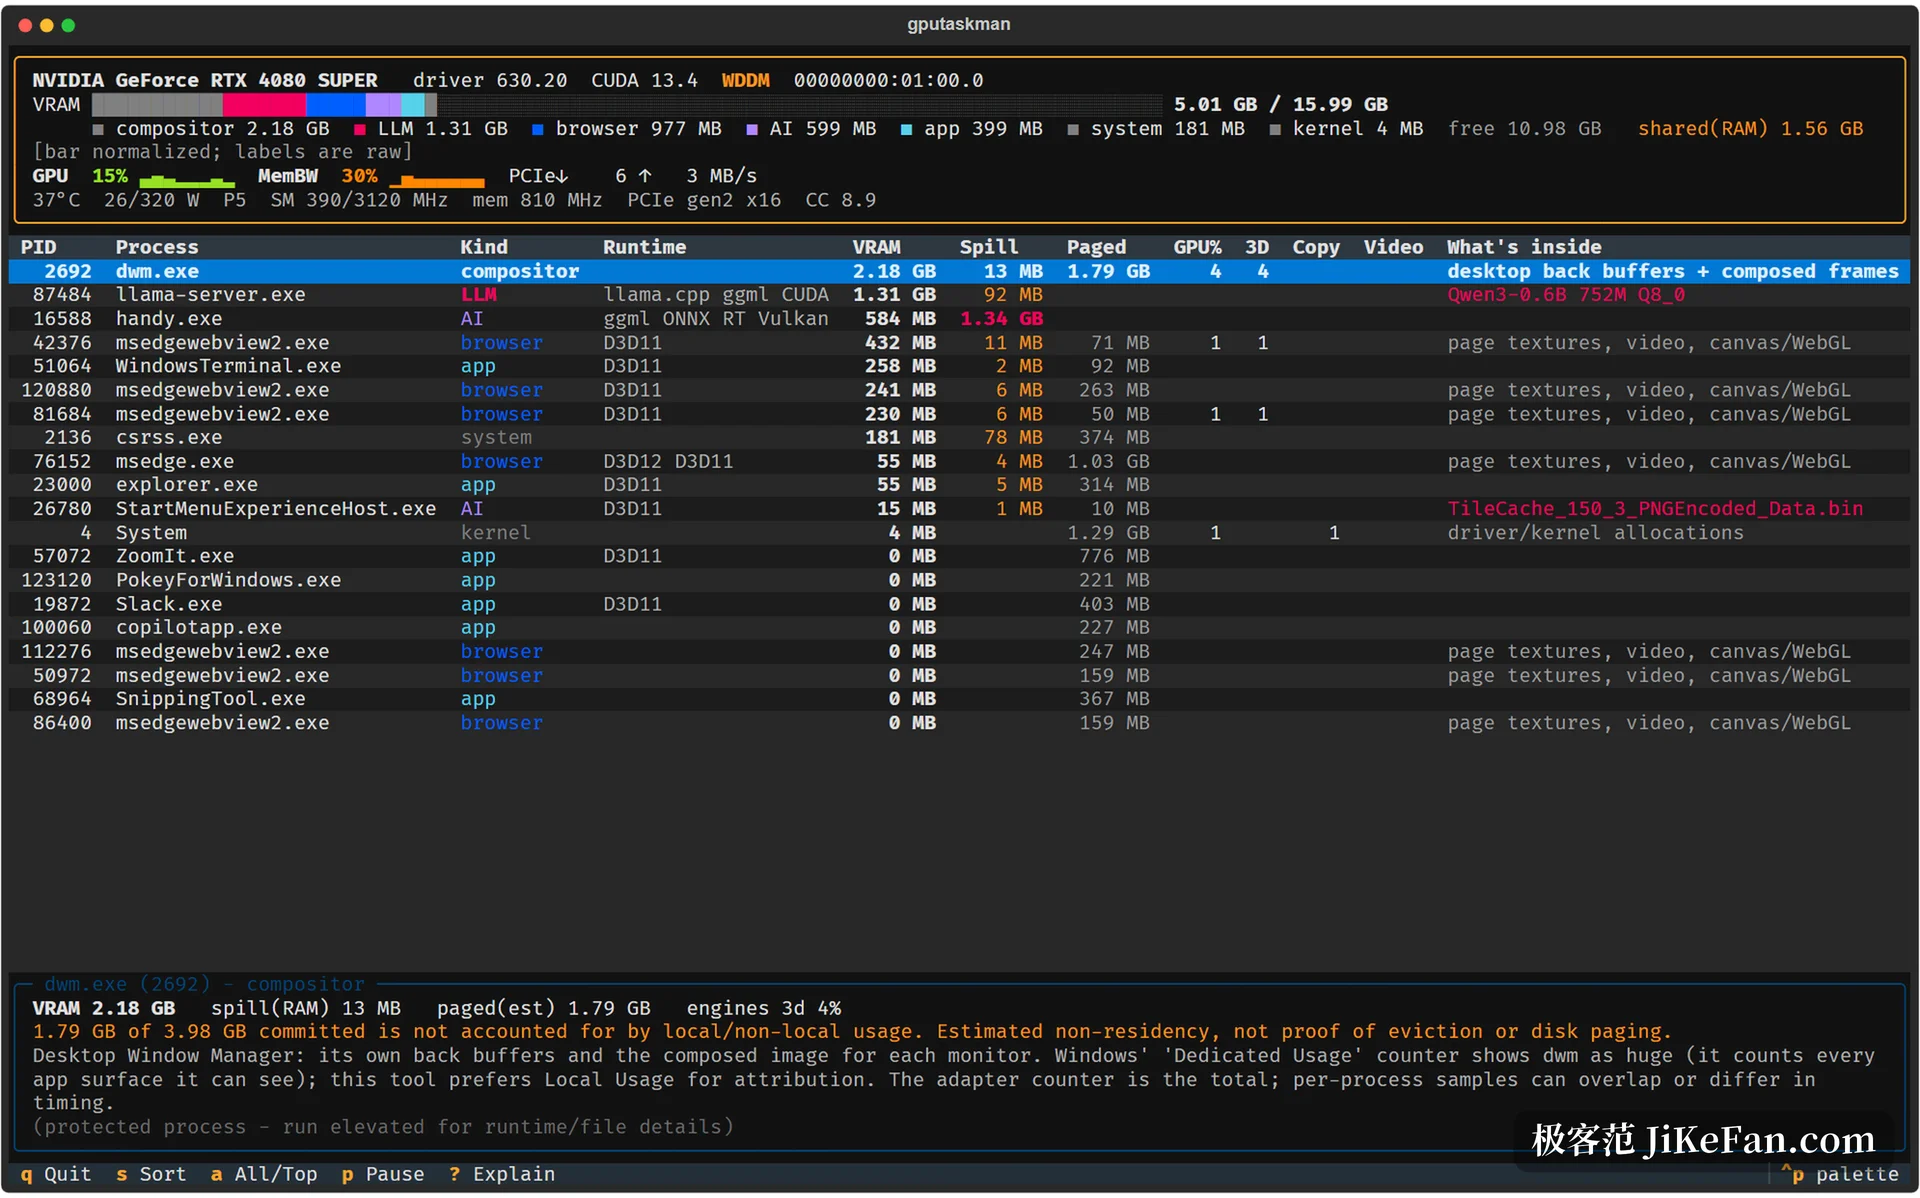
- 未驻留内存的估算值,用来提示有多少提交量没有压在实物上,不等于页面文件里的实测数字。
同一个约定延伸到输出接口:屏幕上取不到的读数显示为 N/A,导出成 JSON 时记作 null,而 null 从不代表「量到了零」。这类把边界写在明面上的做法,比给一个漂亮但来路不明的进度条更经得起追问。
0.4.0 补上 Intel 与昇腾两块
这个项目从第一版到现在只走了八天。11 月 3 日 v0.1.0 落地,同一天 Linux 与 WSL 支持由外部贡献者补上,AMD 显卡随后跟进;11 月 7 日一天之内连发三个版本,把 Apple Silicon 的 macOS、原生 Linux 下的 AMD 与快照对比一并塞了进来。到 11 月 11 日的 v0.4.0,Linux 下 Intel 显卡终于能报出整卡负载、视频负载与功耗,代价是需要 root 权限才能读到;同一天还合并了华为昇腾 310P 的 NPU 后端,让昇腾加速卡也进了这张进程表。跟着修的还有 vLLM 探测逻辑:原来拓扑参数写法特殊时会直接跳过接口发现,现在改成先求值再决定。
从终端到脚本,快照能对比也能落盘
除了盯着界面看,gputaskman 还能把同一批读数导出:一次性的 JSON 快照适合塞进脚本,两个快照之间可以对比差异,记录模式则按固定间隔把读数追加成逐行的 JSON,长跑推理时想回看显存是怎么一步步涨上去的,靠的就是这份流水。快照对比只认同型号适配器,PID 被系统复用的行也不会被硬凑成同一个进程。
平台覆盖方面,64 位 Windows 10 与 11 上 NVIDIA 和 AMD 显卡都有完整读数,Linux 与 WSL 里 NVIDIA 是原生支持,原生 Linux 下 AMD 与 Intel 也各有自己的采集路径,Apple Silicon 的 macOS 目前需要从克隆下来的仓库运行,暂时没有可直接执行的打包版本。纯 CPU 负载不在它的覆盖范围里,各平台能拿到的指标也不完全一致——同一列在不同机器上可能是数字,也可能是 N/A。项目自己给的定位是早期实验性软件,这个标签值得当真:它现在够用,也还在快速变。
显存监控最难的部分从来不是画一条进度条,而是说清楚哪一段数字来自驱动、哪一段来自对文件的推算。gputaskman 把这条界线写进了界面和 JSON 里,用起来会比一个笼统的占用百分比更花时间,但至少每个数字都能找到出处。