
Auto-Ontology, 데이터에 사전을 세운 뒤 AI 가 답한다
요약
Auto-Ontology 0.1 은 데이터베이스에서 업무 사전을 키우는 NVIDIA 의 오픈소스 의미 계층입니다. 답에는 SQL 이 붙습니다.
추천- 이름
- Auto-Ontology
- 버전
- 0.1
- 요금
- 무료
- 오픈소스
- 오픈소스
- 운영체제
- LinuxWeb
- 업데이트
- 2026-11-10 23:00
Auto-Ontology 는 NVIDIA 가 공개한 오픈소스 시맨틱 계층이다. 이미 있는 데이터베이스에서 업무 용어 사전을 키우고, 그 사전에 따라 에이전트가 답하게 만든다. 겨냥하는 것은 데이터를 직접 보는 자리에서 흔한 실패다. 모델이 '매출'을 다른 열로 읽고, SQL 은 돌지만 숫자가 틀린다. 자연어로 업무 데이터를 다루고 싶지만 모델 출력을 그대로 믿지는 못하는 팀을 위한 구조다. 코드는 Apache 2.0 이고 화면은 웹, 뒷단은 컨테이너에서 돌며, 모델 끝점 하나를 붙이면 시작할 수 있다.
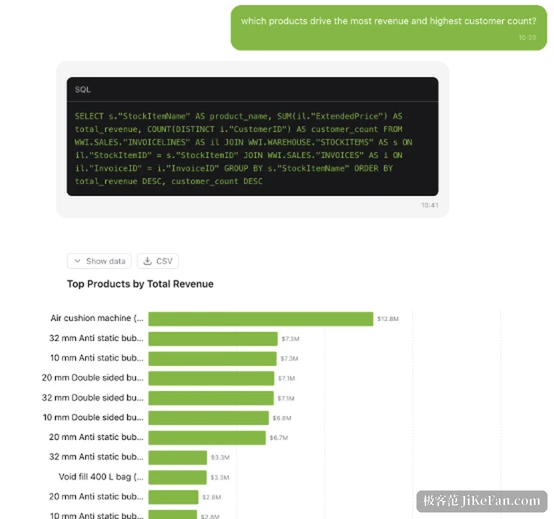
없는 것은 번역이 아니라 사전이다
자연어를 SQL 로 바꾸는 일은 오래전부터 기술적으로 가능했다. 어려운 쪽은 뜻이다. '고객 수'는 주문 표에서 주문한 계정을 세고, 고객 표에서 등록된 회사를 센다. '매출'은 세금을 포함할 수도 빼고 셀 수도 있고, 계산서가 발행됐을 수도 아직 받을 돈일 수도 있다. 모델은 그 회사가 어느 정의로 세는지 알지 못하므로 그럴듯해 보이는 열을 하나 고른다.
Auto-Ontology 는 먼저 그 문맥을 채운다. 데이터가 어디 있고, 무엇이라 불리며, 써도 되는지, 어떻게 써야 하는지, 어디서 왔는지, 무엇과 비슷한지. 이런 정보는 보통 데이터 사전과 SQL 스크립트, 오래 일한 사람의 머릿속에 흩어져 있다. 이것을 질의할 수 있는 구조로 모아 에이전트에 넘기는 것이 이 프로젝트의 일이다.
사전에 들어가는 세 가지
용어는 업무 개념으로 '고객', '청구 행'처럼 설명과 동의어를 가지며 구체적인 열에 대응한다. SQL 속성은 용어 아래에 매달리는 검토된 식으로, 예를 들어 매출총이익률이다. 에이전트는 같은 계산을 다시 쓰지 않고 재사용한다. 관계는 표와 표가 어떻게 이어지는지를 기록하며, 연결 표도 포함하고, 키와 데이터의 모양에서 추론한다.
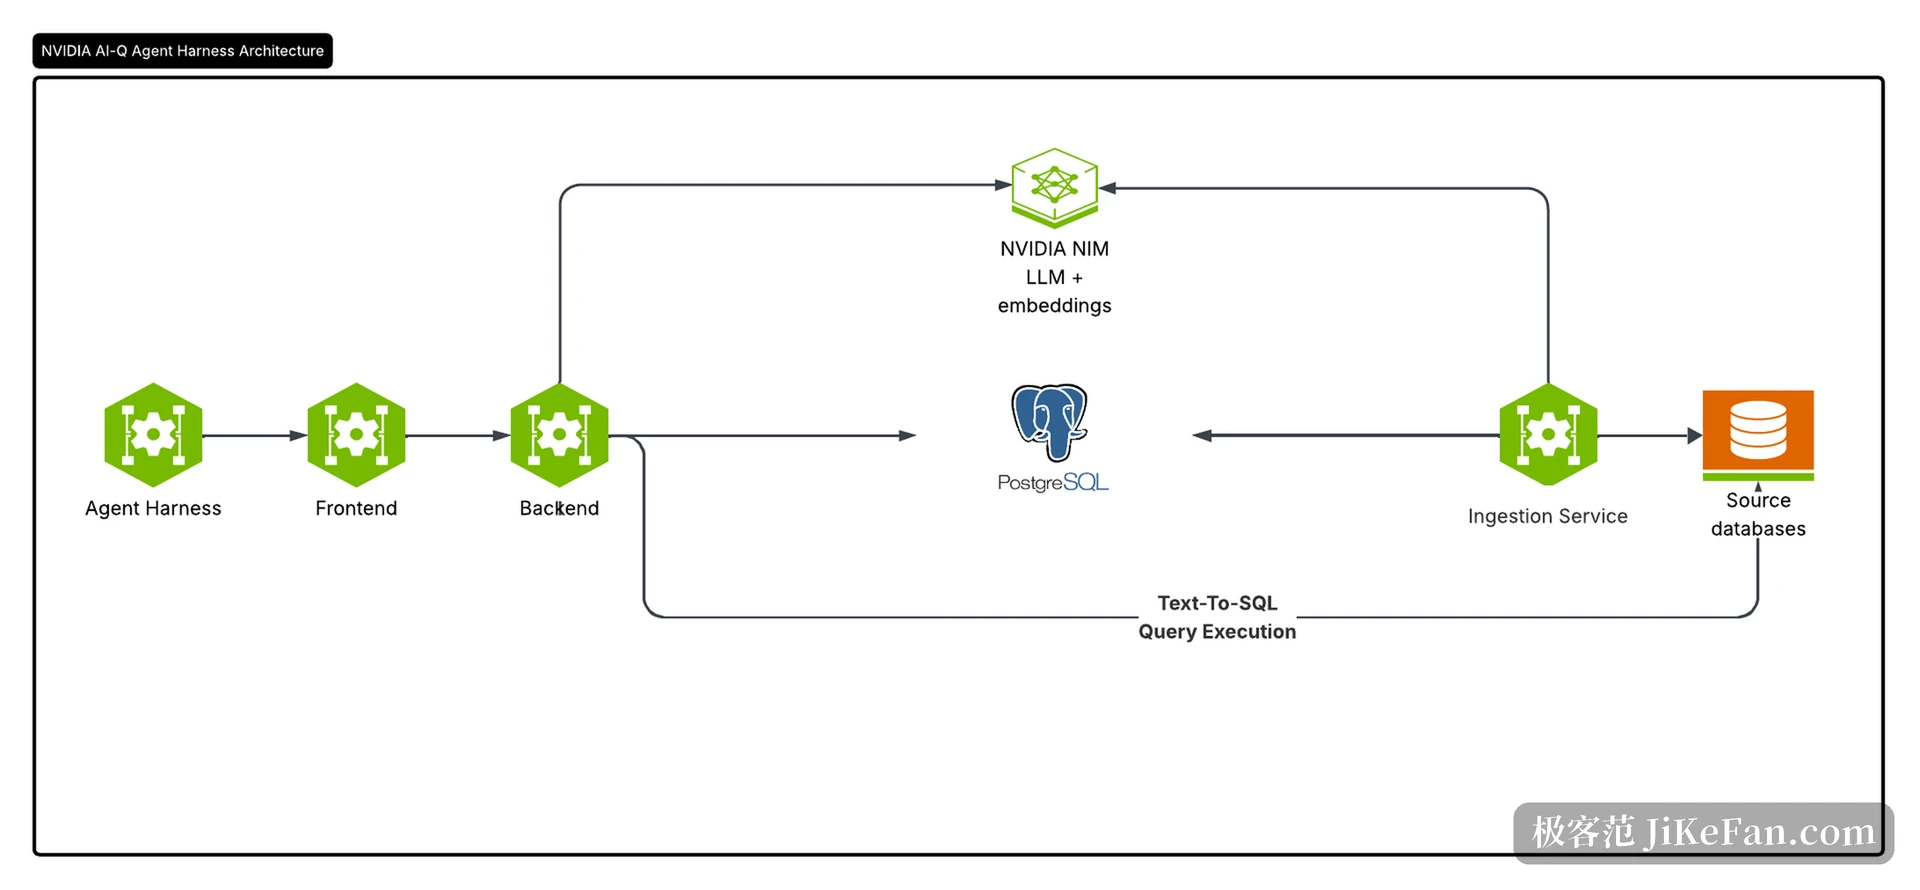
생성은 네 단계로 진행된다. 수집 서비스가 원본 데이터베이스를 읽고 구조를 뽑아 열의 분포와 값 견본을 만든다. 다음으로 표마다 용어를 뽑아 열에 대응시키고, 표 사이의 연결을 추론하며, 지난 질의에서 SQL 속성을 제안한다. 마지막으로 용어와 관계와 속성을 Postgres 에 쓰고 검색용 벡터를 pgvector 에 넣는다.
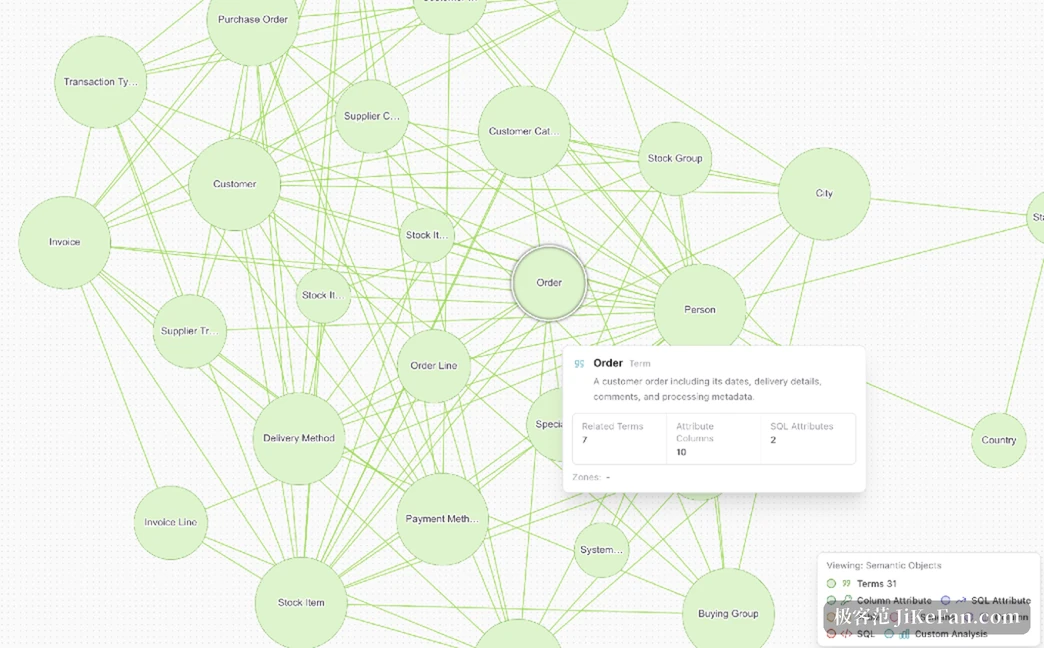
돌리고 나면 화면에 눌러 볼 수 있는 의미 그래프가 나온다. 공식 견본은 Microsoft 의 Wide World Importers 판매 데이터베이스를 쓰며, 한 번 컴파일해 31 개 용어가 나온다. '주문'을 고르면 설명과 관련 용어, 대응하는 열, 그리고 2 개의 SQL 속성이 오른쪽에 나열된다. 숫자는 작지만 이 구조가 어떤 모양인지 보여 주기에는 충분하다.
기계가 초안을 쓰고 사람이 서명한다
자동으로 나온 것을 그대로 쓸 수는 없다. 이 프로젝트는 '인증'을 별도 단계로 두었다. 대화에서 실제 질문을 던져 보거나 MCP 로 검사 도구를 부른다. 용어 설명이 틀렸거나 SQL 속성 계산이 틀렸다면 화면에서 고치고, 고친 뒤 하나씩 인증한다. 인증된 이름과 설명과 식만 이후 답변에서 신뢰하는 정의로 쓰인다.
번거로워 보이지만 여기가 핵심이다. 시맨틱 계층의 값은 얼마나 빨리 생성하는지가 아니라 정의마다 책임지는 사람이 있다는 데 있다. 인증 표시는 그 책임을 적어 두는 자리다.
숫자를 내기 전에 검증을 한 단계 더
질문은 다섯 관문을 지난다. 의도를 읽고 질문에 나온 개체를 뽑는다. 벡터 검색으로 후보 용어와 열, 속성을 모은다. 그것으로 SQL 을 쓴다. 거르는 값과 질의 전체를 데이터베이스에 대 보고 고치며 시험한다. 마지막으로 실행하고 답과 SQL 과 단계를 함께 돌려준다.
네 번째 관문이 보통 질의 도구와 갈라지는 지점이다. 많은 도구는 SQL 을 쓰면 그대로 돌리고, 빈 결과나 터무니없는 숫자도 그냥 내보낸다. 여기서는 '펜실베이니아' 같은 거르는 값이 데이터베이스에 실제로 있는지, 표기가 데이터와 맞는지를 먼저 확인하고 질의 자체도 미리 돌려 본다.
거절하는 길도 있다. 공식 견본에서 '어느 제품의 2015 년 6 월 광고 효과'를 물으면 견본 데이터에 광고가 없다. 커버리지가 0.5 로 나오고, 숫자를 지어내는 대신 '이 데이터에는 광고비가 없습니다. 그달 매출을 보시거나 광고 데이터가 다른 데이터베이스에 있는지 확인해 보시겠습니까'라고 답한다. 이런 답이 정확해 보이는 틀린 숫자보다 훨씬 쓸모 있다.
MCP 로 에이전트에 연결
FastMCP 로 만든 서버가 함께 오고, 밖으로 내놓는 도구는 읽기 전용이다. 배포가 준비됐는지 확인하고, 용어를 검색하고, 용어의 열과 SQL 속성을 가져오고, 지금 본체로 답할 수 있는 질문인지 판단하고, 질문을 던져 답과 데이터 행을 받는다. 호출은 모두 로그인한 사용자의 권한으로 돌기 때문에 만능 열쇠가 아니다.
시맨틱 모델 교환 표준인 Apache Ossie 도 지원해 YAML 을 넣고 뺄 수 있다. 이미 있는 시맨틱 모델을 버리지 않아도 되며, 데이터 웨어하우스 통제를 이미 갖춘 팀에 유리하다.
비용과 맞는 자리
설치하고 잊어버릴 도구는 아니다. 배포는 Docker Compose 나 Helm 으로 하고 Postgres 17 이 필요하며, NVIDIA 모델 끝점에 닿아야 한다. 추론과 임베딩이 모두 그리로 가므로 관리형이든 직접 운영이든 상관없다. 기본 설정에는 모델까지 들어 있어 바꾸려면 환경 변수를 고쳐야 한다.
맞는 자리는 분명하다. 데이터베이스가 많고 정의가 들쭉날쭉하며, 업무 쪽에서 직접 숫자를 보고 싶어 하는 경우다. 핵심 데이터베이스 한두 개를 붙이고 본체를 한 번 컴파일하고, 수십 개 용어를 사람이 인증한 뒤 에이전트에 열어 주는 길이 통한다. 맞지 않는 자리도 똑같이 분명하다. 데이터베이스가 하나이고 열 이름만 봐도 뜻이 통하는 작은 팀에는 유지 비용이 이득을 넘는다.
Auto-Ontology 가 눈여겨볼 만한 이유는 질문을 SQL 로 바꾼다는 데 있지 않다. 모델이 우리 회사의 정의를 모른다고 인정하고, 그 정의를 사람이 검토하고 기계가 질의할 수 있는 층으로 만든 데 있다. 숫자가 맞는지는 결국 사람이 고개를 끄덕여 정해지고, 이 도구는 그 끄덕임에 자리를 마련해 준다.