
SD WebUI Forge:A1111 的界面不变,显存更省、新模型跟到 Qwen-Image
「本地 AI 绘画」这个词被搜索得最多的那套界面,几乎就是 Stable Diffusion WebUI 的样子:左边一列参数,右边一块出图区,模型和 LoRA 一键切换,提示词框上写着正负两栏。这套界面积累出的教程、插件和模型资源,至今是它最难被替代的部分。麻烦在于后台。原版 WebUI 对新一代模型的支持基本停在 2024 年,此后只有零星修补;由它衍生出的 Forge 曾把资源管理重做过一遍,原版 Forge 的最后一次代码推送停在 2025 年 7 月。这条线上真正还在持续维护的,是接手了原版 Forge 的 forge-classic 分支,它选择保留原有界面,把力气花在显存、速度和模型支持上。
界面还是那一套,模型和扩展接着用
它不是另起炉灶的新界面,而是把原来的操作习惯整套留下来:同样是左参数右出图,同样是 txt2img、img2img、Extras、PNG Info 这些标签页,内置模块也改成了一排可点亮的开关。已有环境的迁移成本因此很低——把新界面装到另一个目录,再把模型、LoRA、VAE、ControlNet、embedding 的路径指回老目录即可,权重文件不需要任何转换就会原样出现在下拉框里;扩展也照旧装原来那些,多数可以直接工作。
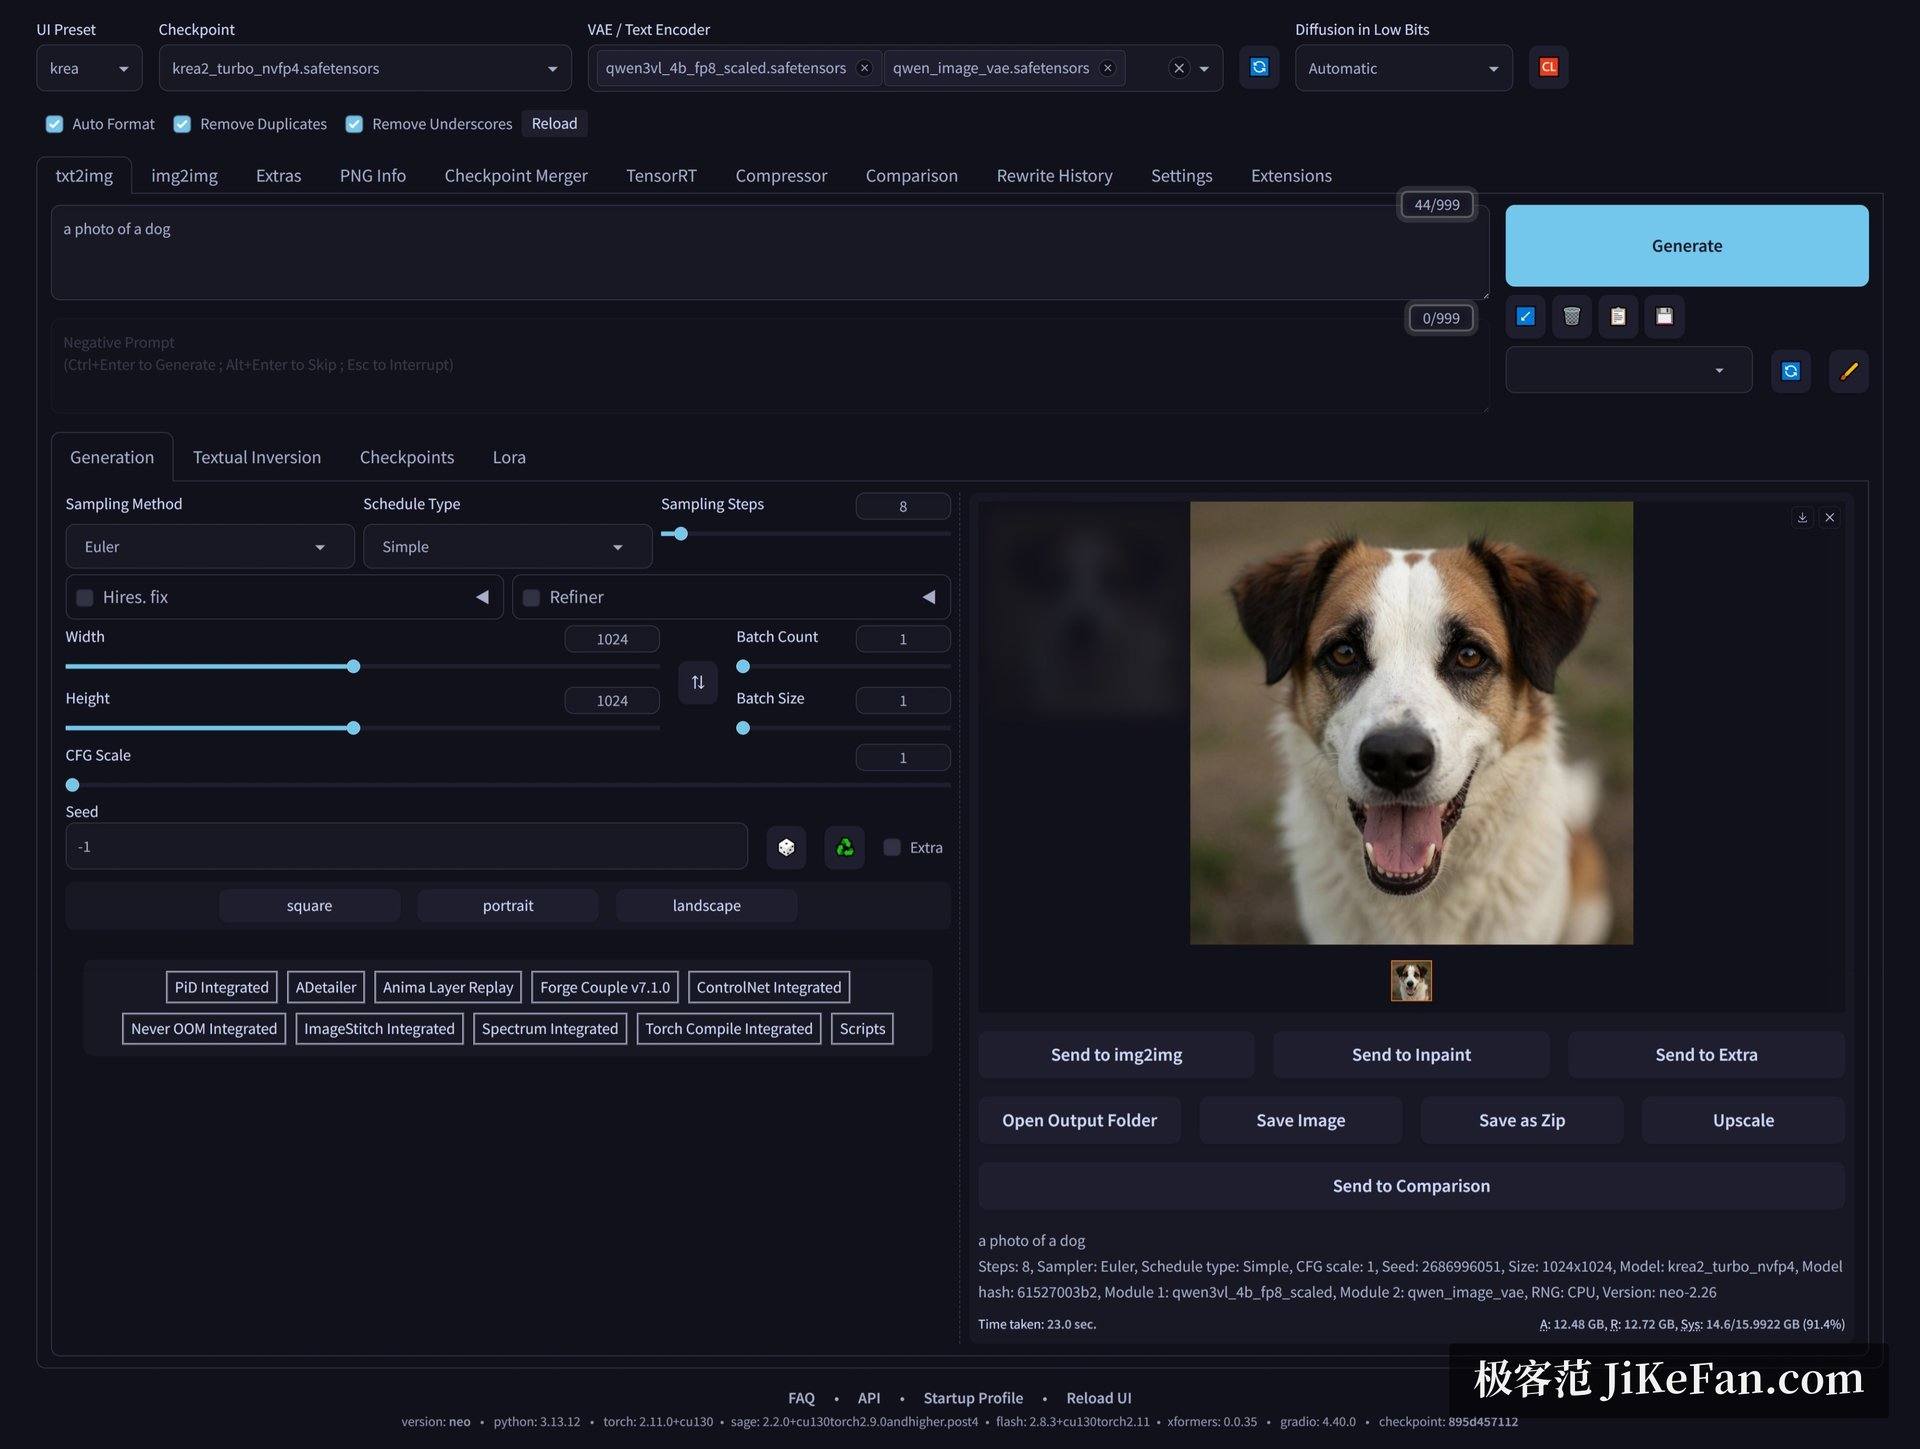
界面底部那行小字是判断版本最直接的地方,会写明当前是哪个版本、Python 与 torch 的版本号、注意力后端是否加载成功,出问题时不用翻日志。
省显存靠的是按需卸载,不是一刀切
原版省显存的办法是开关式的:要么全部卸载到内存,要么更激进地卸载,代价是速度明显下降。Forge 把这部分重写成了一套实时跟踪显存的机制,按层判断哪些权重先留在显存、哪些暂时挪到内存,用完再换回来,一般不需要用户手动去猜该开哪个模式。
实际差距可以量化。在一张 12 GB 显存的卡上跑同一份 Flux FP8 权重,原版开最低显存模式大约 25 秒一张,Forge 默认设置下大约 12 秒一张,显存占用和出图速度是同时改善的。它也保留了低比特加载的选择,量化过的权重能把大模型的显存门槛继续往下压。
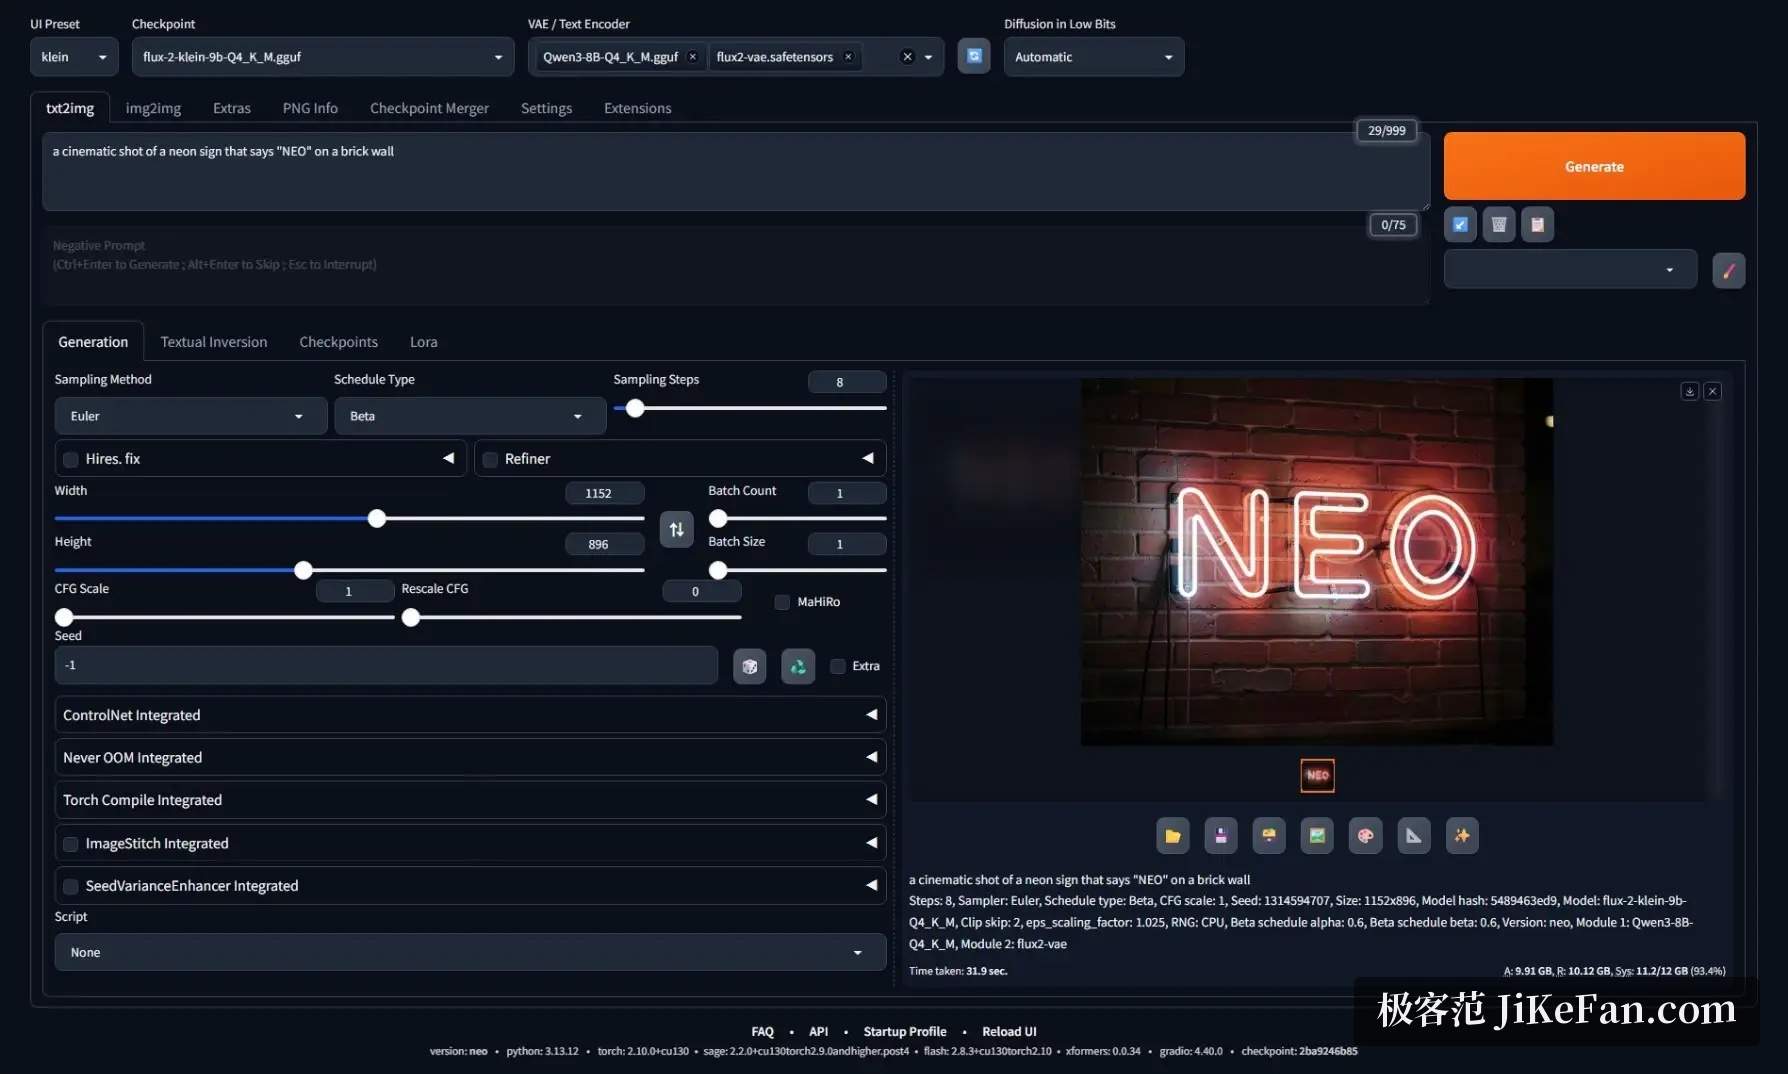
截图里跑的是一个九字节量化的大模型,右下角会实时报出已分配、已预留与系统显存占用比例。照着这个读数判断「还能不能再加一个 ControlNet」,比凭经验试要靠谱得多。
新模型不必等官方排期
分支维护者的取向是「轻量、把最新模型跑起来」。目前支持列表已经覆盖了当前主流的一批:Qwen-Image 与 Qwen-Image-Edit 做生成和局部重绘、Flux 系列的 Kontext 与 Klein 版本、Z-Image 与它的加速版、Chroma1-HD、Lumina-Image-2.0 等。部分模型的类型是靠文件名关键词识别的,想让它正确认出编辑模型,文件路径里需要同时出现对应关键词。
视频方向也接进来了,Wan 2.2 的 14B 版本可以在界面里直接做文生视频与图生视频,用 Refiner 切换高低噪声;要导出成视频文件,需要先自行装好 FFmpeg。量化与加速的开关也做了不少:除低比特加载外,还有混合精度选项、可选装的注意力加速后端与编译加速,以及对视频模型的径向注意力支持。使用前需要装一个叫 uv 的包管理器来加快首次环境安装。
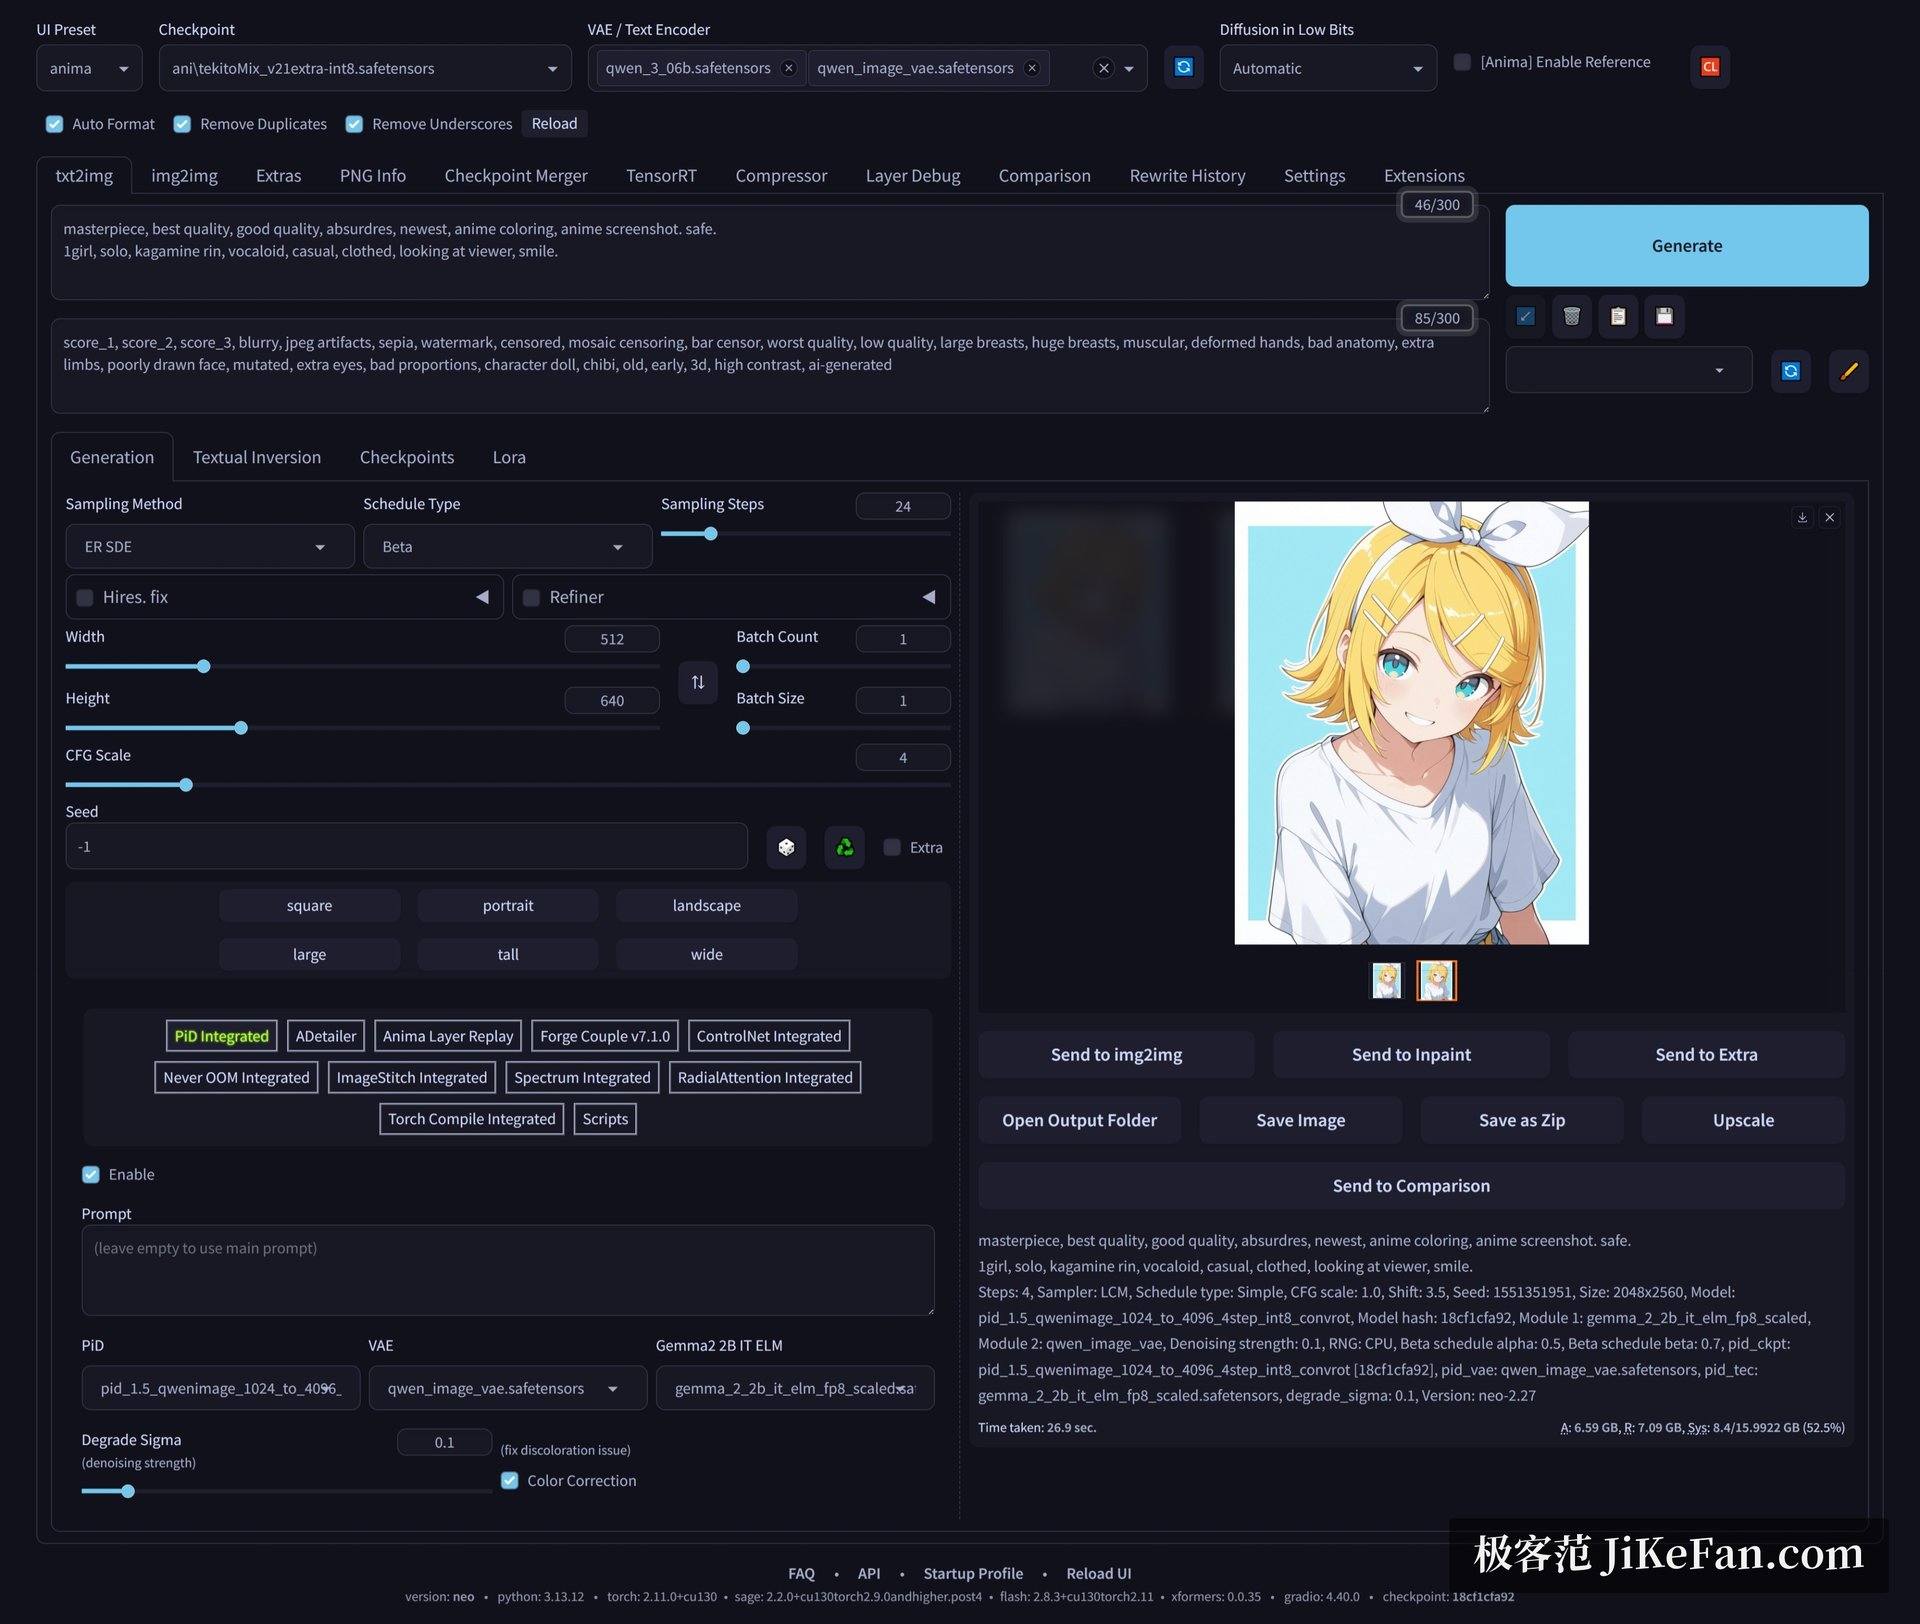
这类模块新方案的迭代速度明显快于原版,用不上的人也可以完全不碰。
权限、成本与要留意的地方
项目采用 AGPL-3.0 许可证,可以免费下载、自行部署,也不按张计费。分支把定位收得更窄——它被做成了一个纯推理环境,因此砍掉了原版的部分能力:不再支持 SD2 与 SD3,移除了超网络与文本反演的模型训练功能,也去掉了 CLIP Interrogator、Deepbooru 这类打标工具。这几项如果正好是日常流程需要,得回头用原版 Forge。
运行环境上,主安装流程面向 Windows 加 N 卡,Linux 与 macOS 另有单独的 Wiki 步骤,Docker 也给了官方说明。AMD 显卡需要照社区指南自行配置,官方明确表示不处理相关 issue——用 A 卡的人要先接受这一点。torch 方面官方跟着最新稳定版走,显卡较老时需要自行降级安装。另外,界面迭代快,网上大量旧教程截图与当前版本已经对不上,遇到不一致时以界面底部的版本号为准。
一句话概括:如果你早就习惯了这套界面、手里又有现成的模型库,它是把「继续用下去」这件事续上的最省事方案——界面不用重新学,模型不用重新下,省下的显存和跟得上的新模型是白拿的。想训练模型、或者需要 SD2 与 SD3 这类老底子的人,留在原版更合适。