
Fooocus:不调参就能出图的 SDXL 前端,内置离线提示词引擎
本地出图这件事,难点往往不在装,而在调。采样器、步数、CFG、分辨率、重绘幅度,一屏参数看下来,光是弄明白它们之间的关系就要花掉一个周末,出图效果还未必对得起这份折腾。Fooocus 的出发点正好相反:把这些参数整层藏到预设背后,界面上只留一个提示词框和一个生成按钮。官方给的演示很具体——提示词只写「forest elf」,出来的是四张完成度已经很高的精灵人像。
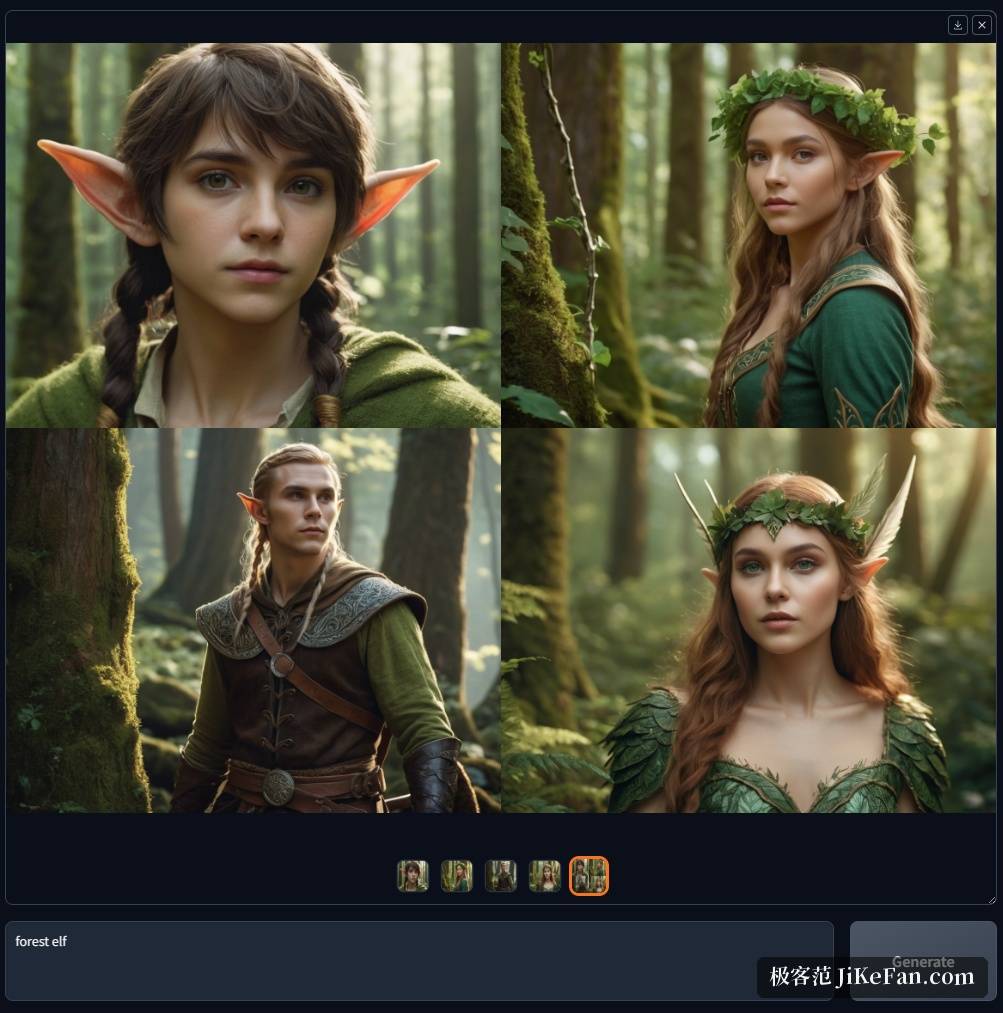
它是什么
Fooocus 是 Lvmin Zhang(GitHub 上的 lllyasviel)发起的开源项目,完全构建在 Stable Diffusion XL 架构之上,程序采用 GPL-3.0 许可证,可以免费下载、完全离线运行,出图不联网、不按张计费。它的定位和在线出图服务很像:用户只需关注提示词和图像,不必先学会采样器是什么。有一点要提前说明,这个项目没有官网——搜索出来的同名站点大多是假的,一切以它的 GitHub 仓库为准。
提示词写一句也够
支撑「不调参」的关键,是内置的一套离线运行的、基于 GPT-2 的提示词处理引擎,在界面上对应的是 Fooocus V2 风格。你写一句「花园里的房子」,引擎会自己把缺失的风格、光线、材质和构图细节补齐,再交给模型去画;提示词写得很长也能用,官方给出的适用范围是短到一句话、长到一千字。风格选择同样不用瞎猜,官方仓库为每种内置风格都配了一张样张,风格文件超过两百个,从写实摄影、电影质感到动漫插画都覆盖到了。
装好它一共三步
Windows 用户拿到的是一个整合包,里面已经自带独立的 Python 环境:解压到任意目录,双击 run.bat,第一次启动会自动把默认的 SDXL 检查点下载进模型目录。官方把「从点下载到出第一张图」的鼠标操作次数控制在三次以内,这个说法与实际流程是对得上的。
想换成别的模型,把 SDXL 检查点文件放进 models/checkpoints 目录,重启后就能在界面上选到。除了默认的通用预设,官方还提供动漫与写实两个独立启动脚本,各自配了一套默认模型。
显卡一般也能跑
官方给出的最低要求是 4 GB 显存的 N 卡加 8 GB 系统内存,更老一些的显卡建议 8 GB 显存。这个门槛在本地出图工具里属于偏低的,官方演示里就用一台 6 GB 显存的笔记本显卡完成了出图,任务管理器里能看到显存占用被压到了很小的区间。
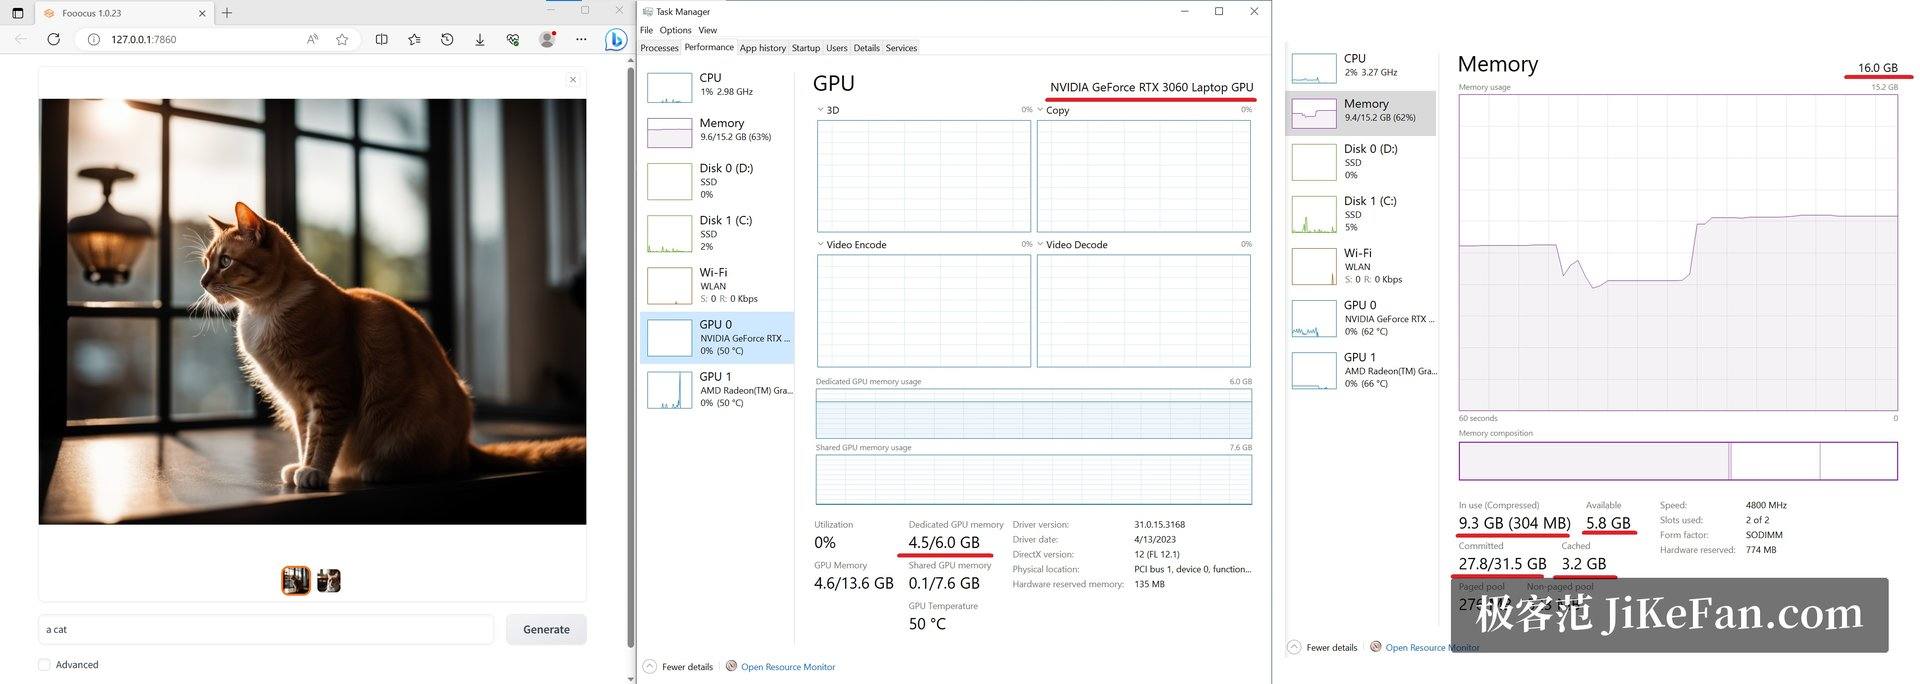
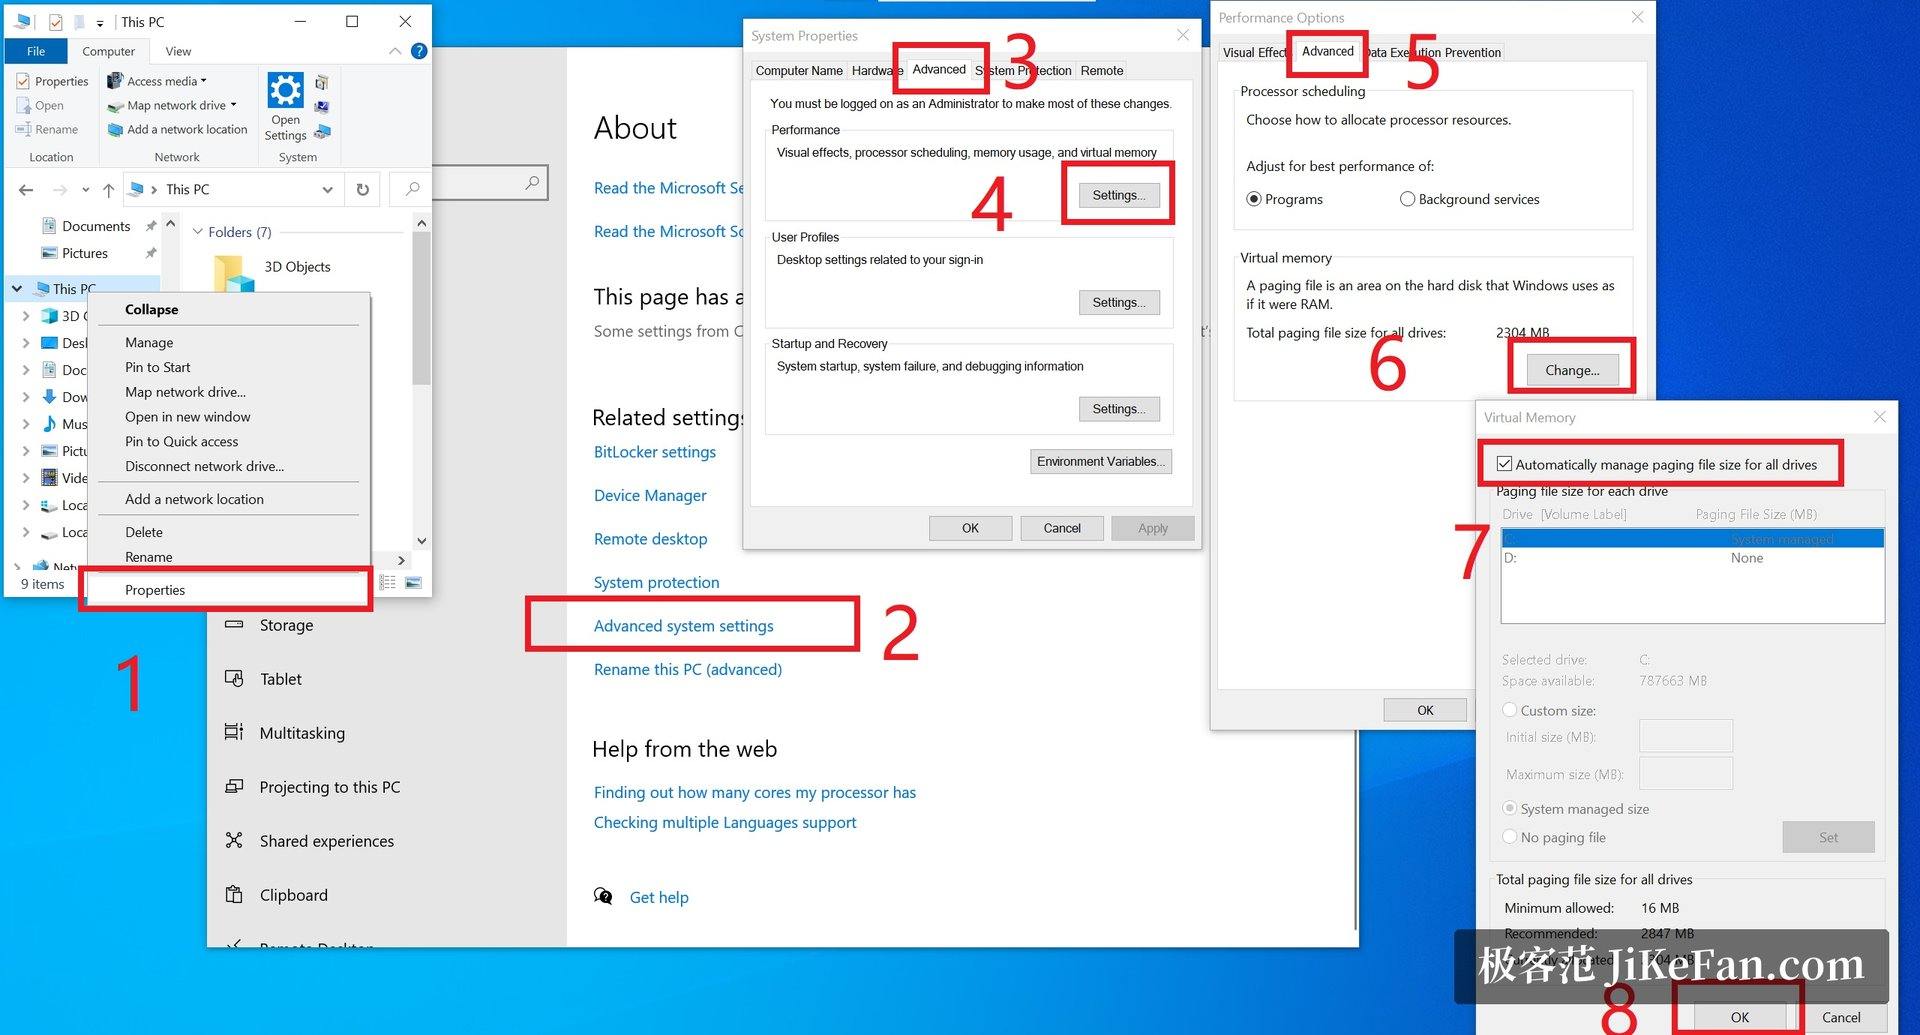
更需要注意的是系统内存。官方文档专门写了一节虚拟内存的设置步骤,内存吃紧时它会借用硬盘上的分页文件,如果系统把这项功能关掉或者分页文件太小,出图会直接失败。这是新手最常踩的坑,装机时顺手把虚拟内存打开,能省掉很多莫名其妙的报错。
图生图、重绘与扩图都是内置的
输入图像之后,可以选「放大或变化」:轻微变化和强烈变化两种幅度,以及 1.5 倍、2 倍放大。局部重绘用的是自研的重绘算法与重绘模型,扩图支持向上、向下、向左、向右四个方向。另有图像提示词功能,允许用一张参考图去影响生成结果的风格与内容;人脸替换也做成了内置项,不需要额外搭建环境。
它现在的状态
官方仓库里有一节专门讲项目状态:Fooocus 目前处于有限长期支持、只修 bug 的阶段,完全基于 SDXL 架构。官方认为现有功能已经基本完善,后续更新主要处理可能出现的问题,目前没有迁移到更新模型架构的计划;但如果社区最终在某个方向上收敛,这个计划也可能改变。把这件事说清楚反而有好处——它意味着你装好之后不会每个星期都被新版本推着走。最后再提醒一次:搜索时优先认准 GitHub 仓库,其余同名站点都不可信。
一句话概括,它把 SDXL 这条成熟路线做到了最省心:不追新模型,但把「写一句话就出好图」这件事做得稳定可预期,只修 bug 的状态也顺带免去了频繁升级的打断。想立刻上手、显卡又不算顶配的人,它是最不容易出错的那个选择。