
-
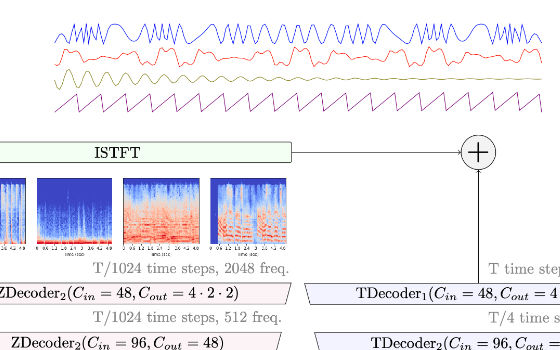
Demucs:开源音源分离模型,命令行一行拆出四条音轨
Demucs 是一个开源的音源分离模型,能把一首歌里的鼓、贝斯与人声分别拆出来;命令行一行即可运行,也能从 Python 直接调用,代码以 MIT 许可证开源。
-
Ultimate Vocal Remover:开源人声分离,干声与伴奏一键提取
UVR 是一个开源的人声分离工具,用先进的音源分离模型把音频拆成人声与伴奏两条音轨;官方安装包已内置界面、Python 与 PyTorch,下载后装上就能用,不需要额外配环境。
-
WhisperX:70 倍实时的开源转写工具,输出词级时间戳与说话人标签
WhisperX 把转写串成流水线:先用 faster-whisper 批量转写,再用 wav2vec2 强制对齐拿到词级时间戳,最后由 pyannote 区分说话人。
-
Buzz:离线转写与翻译音频的桌面工具,由 Whisper 提供支持
Buzz 是一个能在个人电脑上离线转写与翻译音频的桌面工具,由 Whisper 驱动;支持转写音视频文件、麦克风实时转写与说话人识别,结果可导出 SRT 与 VTT 字幕。
-
Whisper:从 3900 万参数到 15.5 亿参数,六种尺寸按显存和精度挑
Whisper 是一个通用语音识别模型,同一个模型就能做多语言转写、翻译与语种判断;提供从 3900 万到 15.5 亿参数的六种尺寸,代码与权重都是 MIT 许可。
-
F5-TTS:开源语音合成模型,代码是 MIT 许可而预训练模型限非商用
F5-TTS 是一个用流匹配做语音合成的开源项目,提供 pip 安装、命令行推理与 Gradio 网页界面;代码是 MIT 许可,预训练模型因训练数据限制只能非商用。
-
CosyVoice:零样本克隆声音的开源语音合成,覆盖九种语言与十八种中文方言
CosyVoice 是一个开源的语音合成模型,最新版本 Fun-CosyVoice 3.0 支持零样本跨语言克隆声音,覆盖九种外语与十多种中文方言,以 Apache 2.0 许可证开源。
-
GPT-SoVITS:1 分钟语音数据就能微调出 TTS 模型,5 秒样本即可零样本合成
GPT-SoVITS 是一个开源的语音合成 WebUI:输入 5 秒人声就能零样本合成,1 分钟语音数据即可微调出相似度更高的音色,还支持跨中英日韩粤五种语言推理。
-
第 1 / 1 页