
通义万相 Wan:开源视频模型从 8.19GB 显存的 1.3B 一路走到 27B 双专家 MoE
通义万相(Wan)是阿里云的开源视频生成模型线,权重与推理代码以 Apache-2.0 许可公开。这条线从 2025 年 2 月的 Wan2.1 起步,到 Wan2.2 引入 MoE 架构把总参数推到 27B,再分出音频驱动、角色动画、音乐舞蹈几个专项模型,同时保留了一条能在消费级显卡上跑的轻量分支。
Wan2.2 的关键变化:把 MoE 搬进视频扩散模型
Wan2.2 的技术报告把核心创新写在第一段:它把混合专家架构引入视频生成扩散模型。A14B 系列采用双专家设计——一个高噪声专家负责去噪早期、关注整体布局,一个低噪声专家负责后期、细化视频细节;两个专家各约 14B 参数,合计约 27B,但每一步只激活约 14B,因此推理计算量和显存占用与单专家模型基本持平。两个专家之间的切换点由信噪比决定:去噪刚开始时噪声水平高、信噪比处于低点,此时激活高噪声专家,阈值步长取在信噪比低值的一半处。
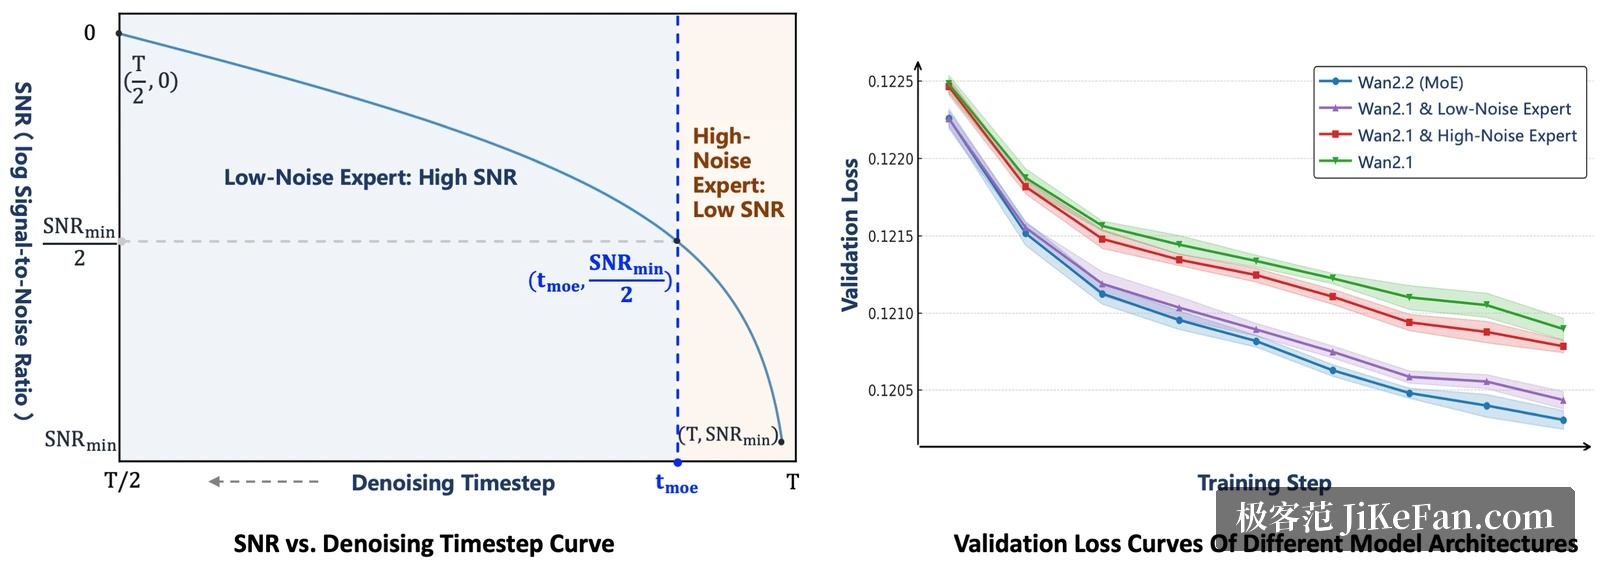
除了架构,训练数据也是这一代的变量:官方写明相比 Wan2.1,Wan2.2 增加了 65.6% 的图像和 83.2% 的视频,用来提升模型在运动、语义与美学等维度上的泛化。另外,官方把美学数据单独标注了光照、构图、对比度、色调等维度,让电影感的生成风格变得可指定。
5B 的 TI2V:720P 24fps 与消费级显卡
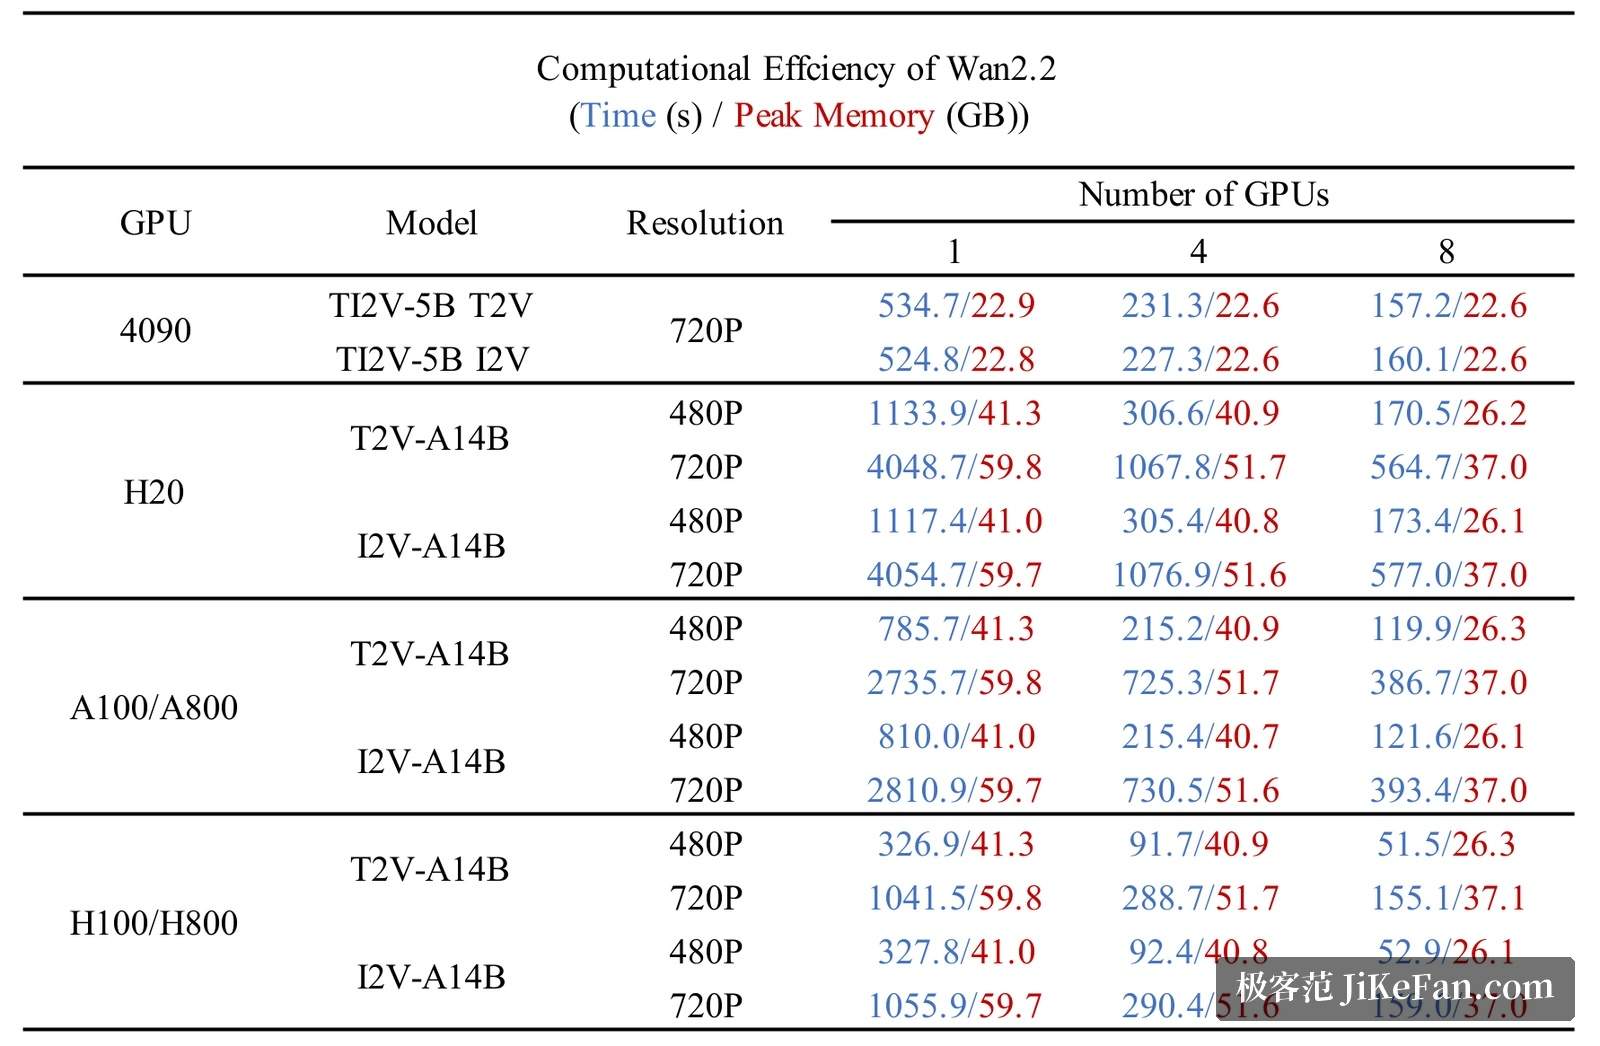
Wan2.2 里有一条对个人开发者更友好的分支:TI2V-5B。它把文生视频与图生视频合进同一个模型,支持 720P 分辨率下的 24fps 输出,并且可以在 4090 这类消费级显卡上运行。官方给出的效率数据可以直接换算成本:在单张 4090 上,一段 720P 的文生视频耗时约 534.7 秒、峰值显存约 22.9 GB;图生视频约 524.8 秒、峰值显存约 22.8 GB。如果把推理扩到 8 张卡,两项任务的耗时分别降到约 157.2 秒与 160.1 秒。
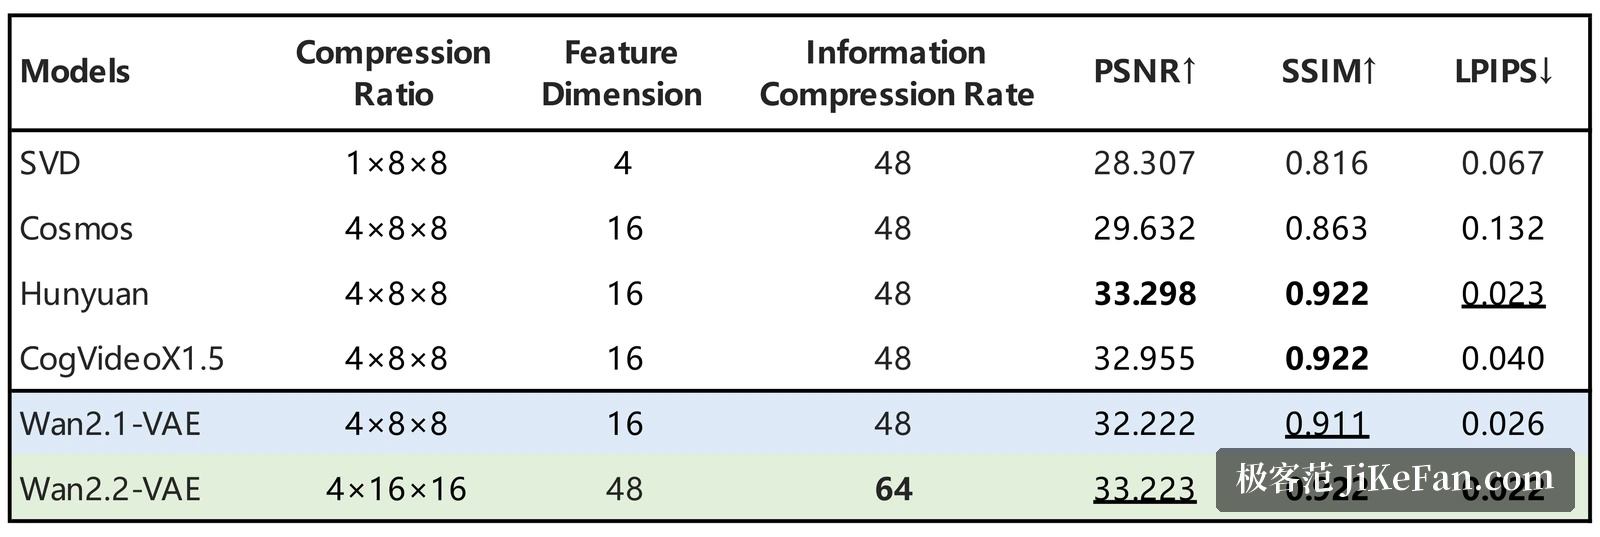
压缩 VAE:16×16×4 换来的显存空间
5B 模型能塞进消费级显卡,关键之一是视频 VAE 的压缩比。Wan2.2-VAE 做到 16×16×4,也就是在时间与空间维度上给出更高的压缩倍数;官方给出的对比表里,Wan2.1-VAE 与部分同类方案是 4×8×8,Wan2.2-VAE 在信息压缩倍数为 64 的同时把重建指标 PSNR 从 32.222 抬到 33.221,SSIM 与 LPIPS 也同步小幅改善。压缩比更高、重建质量不降,才是同一张显卡能跑更高分辨率的直接原因。
效率表:不同 GPU 上的耗时与显存
官方仓库附了一张跨硬件的效率表,格式是「总耗时(秒)/ 峰值显存(GB)」。除 4090 的数据外,表里还能看到 A14B 档位在 H20 上的表现:单卡跑 720P 文生视频约 4048.7 秒、峰值显存约 59.8 GB,扩到 4 卡后降到约 1067.8 秒、峰值显存约 51.7 GB。仓库同时提示,A14B 的单卡命令需要至少 80GB 显存的 GPU;显存不够时可以打开模型卸载与参数类型转换,用速度换容量。
三条专项模型线:音频驱动、角色动画、音乐舞蹈
Wan2.2 之后,这条开源线分出几个针对性很强的方向。2025 年 8 月 26 日发布的 Wan2.2-S2V-14B 是音频驱动的视频生成模型,官方同步给出推理代码、权重与技术报告,支持 480P 与 720P 两档分辨率;2025 年 9 月 19 日发布的 Wan2.2-Animate-14B 面向角色动画与角色替换,官方提供权重与推理代码,并在 2025 年 11 月 13 日被集成进 Diffusers,此前也已提供 ComfyUI 集成。
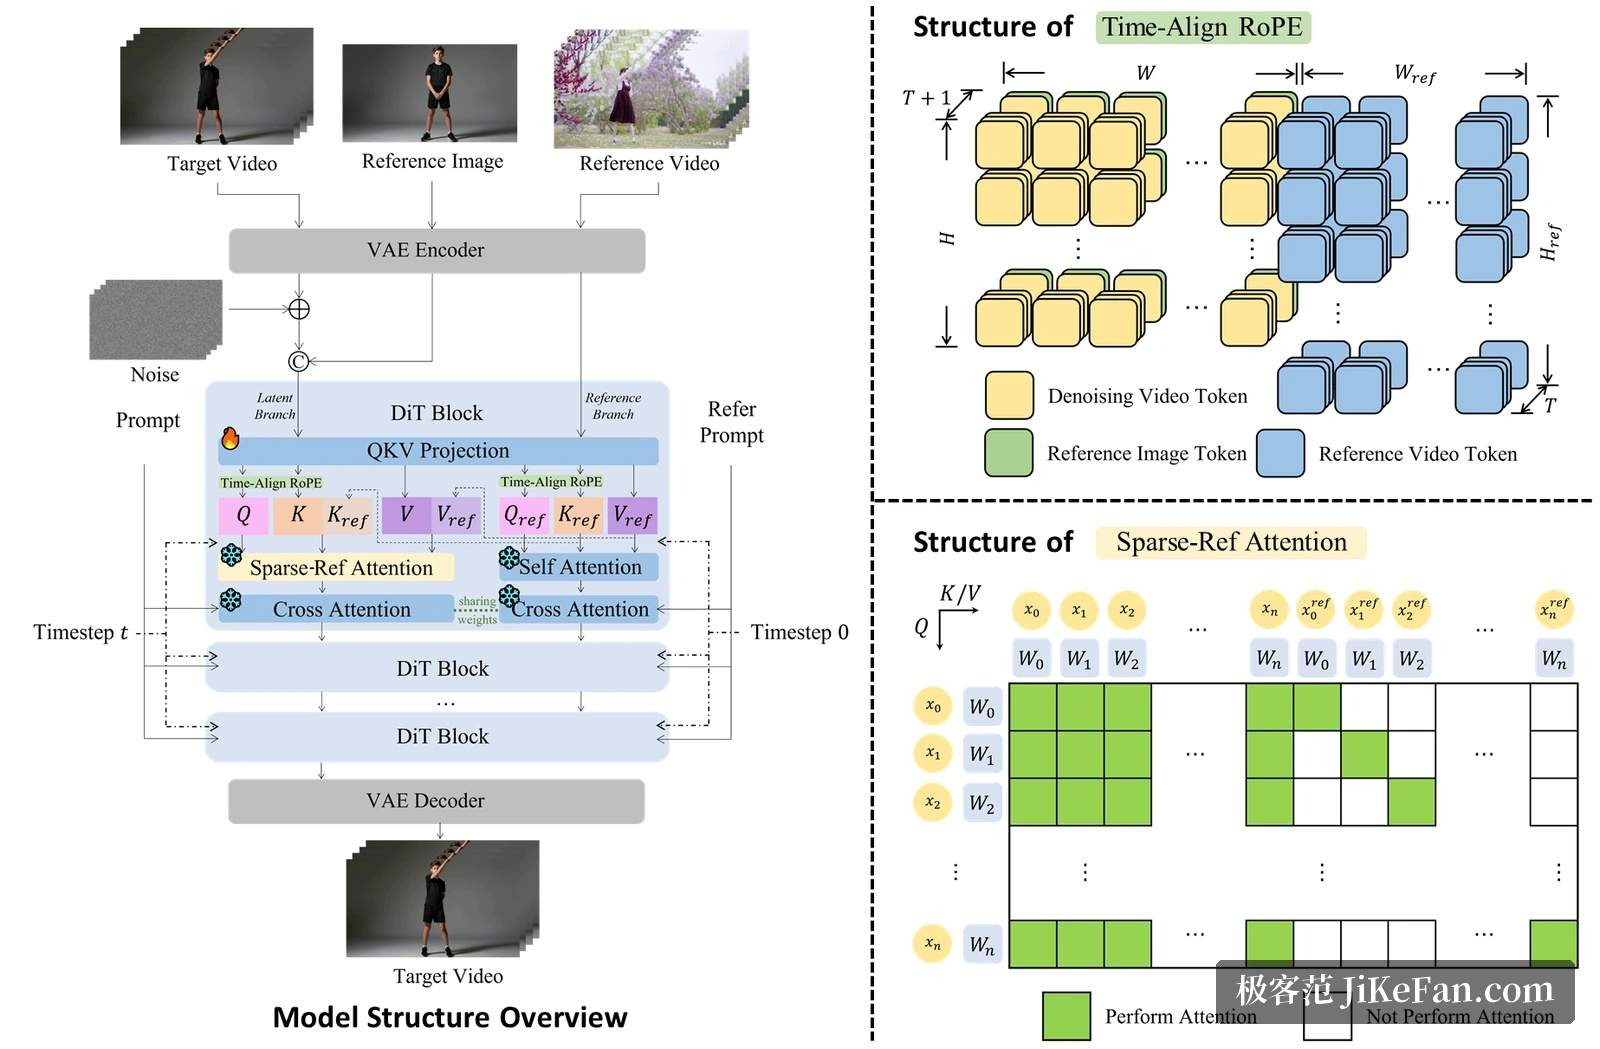
2026 年 8 月 7 日发布的 Wan-Animate-2 把这条路走得更远:它采用端到端的角色动画框架,直接把驱动视频送进重新设计的 Diffusion Transformer,省掉了中间的动作提取器,因此在动作保真度与身份保持上更有针对性;另一个新增能力是文本驱动的视角控制,可以把输出的相机视角与驱动视频解耦。官方还给出 Wan-Animate-2-Lite 这一轻量变体,把推理延迟压到实时阈值,面向流式角色动画。
音乐到舞蹈则被单独开源成 Wan-Dancer。官方写明这套框架可以生成时长超过一分钟的 720p 30fps 舞蹈视频,覆盖古典、街舞、拉丁等五种舞种;做法是把生成拆成全局关键帧规划与局部时序细化两步,再用时间映射的位置编码与光流损失维持长时序的稳定性。仓库标注的测试环境是 8 张 A800 80GB 显卡,属于这几个专项模型里门槛较高的一个。
回溯 Wan2.1:8.19GB 显存与中英文字渲染
Wan2.1 是这条线的起点,也是理解轻量分支的参照。官方写明 T2V-1.3B 版本只需要 8.19 GB 显存,几乎可以在全部消费级显卡上运行;在 RTX 4090 上大约 4 分钟能生成一段 5 秒 480P 视频,而且没有使用量化等优化手段。模型档位方面,Wan2.1 提供 T2V-14B(480P 与 720P)、I2V-14B 的 480P 与 720P 两个版本、T2V-1.3B(480P)、FLF2V-14B(720P)以及 VACE 的 1.3B 与 14B 两档。
能力覆盖上,Wan2.1 除文生视频与图生视频外还包含视频编辑、文生图与视频转音频;官方把「能同时生成中英文文字的视频模型」列为它的卖点之一,并说明 Wan-VAE 可以对任意长度的 1080P 视频做编解码、同时保留时间信息。这两点决定了它后续能被大量二次开发项目直接拿来当底座。
许可证、权重与集成路径
组织页写明,Wan 名下 6 个公开仓库全部采用 Apache-2.0 许可证,包括 Wan2.2、Wan2.1、Wan-Dancer、Wan-Animate-2、Wan-skills 与一个 Diffusers 分支;其中 Wan2.2 的星标数约 17.5k,Wan2.1 约 17k。权重同时发布在 Hugging Face 与 ModelScope 两个渠道,可以用对应的命令行工具下载到本地。对团队来说,许可证与权重渠道决定了它能不能进内部流程,这两项在仓库首页都能直接确认。
社区生态:从 ComfyUI 到推理加速
围绕这条线的第三方项目已经形成规模。官方 README 收录的包括 LightX2V(轻量推理框架,可在 RTX 5090 与 8GB 显存的 RTX 4060 上运行)、DiffSynth-Studio(低显存逐层卸载、FP8 量化、序列并行与 LoRA 训练)、FastVideo 与 Cache-dit(稀疏注意力与缓存加速)、Kijai 的 ComfyUI 封装,以及 Prompt Relay、Video-As-Prompt、Wan-Move、EchoShot 等控制类与长视频类工作。此外还有一个 Wan-skills 仓库,把模型能力包装成可被智能体调用的技能,例如用图像模型做生成与编辑,或把文档转成幻灯片。
几点边界
其一,文中耗时与显存数字全部来自官方仓库的效率表,测试条件包含特定的并行策略与注意力实现,自己的机器上会有差异。其二,A14B 单卡需要 80GB 以上显存才能按仓库默认命令运行,5B 分支才是消费级显卡的现实选择。其三,专项模型的硬件门槛差别很大,Wan-Dancer 标注的测试环境是 8 张 A800。其四,许可证与商用条款请以仓库内的许可文件为准,涉及人物形象与肖像素材时还要确认素材本身的授权。
一句话概括:通义万相这条开源线的价值不在单个模型的分数,而在于它把同一套架构铺成了一条梯度清晰的产品线——1.3B 负责让 8GB 显存的机器也能出片,5B 用高压缩比 VAE 把 720P 24fps 做到单张 4090 可跑,A14B 用双专家 MoE 把总参数推到 27B 而单步成本不变,再往上用 S2V、Animate、Dancer 分别解决声音、角色与长时序舞蹈这三类具体问题。