
CPU 也能推理大模型:llama.cpp 是本地部署的最后一道保险
如果追问本地大模型生态的源头,几乎所有名字最终都会指向同一个项目。2023 年 3 月,开发者 Georgi Gerganov 用纯 C/C++ 把刚刚问世的 LLaMA 模型搬到了普通消费级硬件上,这个名为 llama.cpp 的项目随后发展成整个本地推理领域的基石——如今由 ggml-org 组织维护,GitHub 上已聚集超过 128,000 颗星标,Ollama、LM Studio、GPT4All 这些用户熟悉的桌面工具,其推理后端都与它同源。最新稳定版 v0.4.1 于 2026 年 9 月 14 日发布,继续提供 Windows、macOS、Linux 三平台预编译版本。
llama.cpp 最广为人知的贡献是 GGUF 模型格式。在此之前,开源模型动辄几十 GB 的原始权重让消费级硬件无从下手;GGUF 把权重、分词器与元数据打包进单一文件,配合 k-quants 量化体系(Q4_K_M 等等级),可将模型内存占用降低约 60-75%,而质量损失很小。量化后 7B 级别的模型体积缩到几个 GB,普通笔记本的内存也能装下,Hugging Face 上数以千计的 GGUF 量化版本正是围绕这套格式生长起来的。换言之,今天"下载一个量化文件就能跑模型"的顺畅体验,底层的游戏规则是 llama.cpp 定下的。
CPU 推理在 llama.cpp 里从来不是权宜之计,而是一等公民。引擎针对 x86-64 的 AVX、AVX2、AVX512 指令集与 ARM 的 NEON 做了深度优化,社区实测中,量化后的 7B-8B 模型在无独立显卡的现代笔记本 CPU 上能达到每秒 10 到 30 个 token 的生成速度,日常对话完全可用。对那台没有独显的老台式机、一台只有核显的办公本,或是不便安装 GPU 的家用服务器来说,它往往是唯一还能跑得动新模型的选择——这也是"最后一道保险"这个说法的由来:当其他工具都因硬件门槛却步时,llama.cpp 通常还能再顶一层。
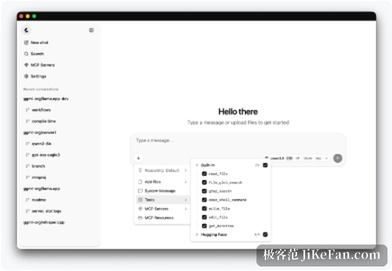
有 GPU 的机器同样能受益,而且方式相当灵活。引擎支持将模型的若干层卸载到 GPU、其余留在 CPU 运行,显存不足的设备可以按层数细粒度地权衡速度与容量;后端方面,NVIDIA 卡走 CUDA 内核,苹果芯片享受 Metal 的一级支持,AMD 与 Intel 显卡则有 Vulkan 和 SYCL 后端可用。项目还提供 llama-server,启动一个 OpenAI 兼容的本地 HTTP 服务并自带网页界面,已有多款支持自定义接口的客户端可以直接指向它,连续批处理等特性也能在服务模式下启用。
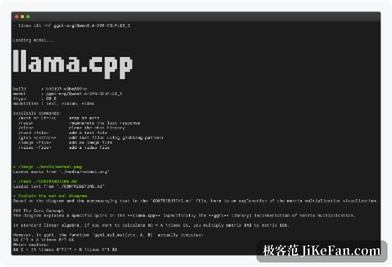
需要坦率说明的是它的取向:llama.cpp 没有官方图形界面,命令行是唯一的官方入口,每一个参数——上下文长度、卸载层数、线程数、量化等级——都需要使用者显式指定或接受默认值。这种设计换来的是极致的可控性与可嵌入性:它是一个零依赖的推理引擎而非成品软件,开发者把它嵌进自己的应用,运维者在无头服务器上把它当作 API 服务跑,极客则用脚本把它编排进各种自动化流程。项目采用 MIT 许可证,商用与二次开发均无障碍。如果前面的 Ollama、LM Studio 是为不同人群准备好的"整车",llama.cpp 就是那台敞开引擎盖、随你改装的底盘——它不适合所有用户,但对愿意动手的人来说,它决定了本地推理能走多远。
项目 | 说明 |
|---|---|
软件名称 | llama.cpp(ggml-org 组织维护) |
最新版本 | v0.4.1(2026-09-14 发布) |
软件类型 | C/C++ 本地大模型推理引擎(命令行,无 GUI) |
开源许可 | MIT |
核心特性 | GGUF 格式制定者;k-quants 量化;CPU/AVX/NEON 优化;CUDA/Metal/Vulkan/SYCL 后端;OpenAI 兼容 llama-server |
适合人群 | 极客玩家、嵌入式开发者、无显卡硬件用户、Homelab 运维 |
图片来源 | GitHub 仓库 ggml-org/llama.cpp(公开页面截图与仓库卡图) |